Choisir un serveur GPU pour l'inférence LLM en 2026 : VRAM, topologie et refroidissement
Introduction : l'inférence, là où arrive réellement la facture de l'IA
En 2026, la conversation sur l'IA est passée de l'entraînement à l'inférence. Entraîner un modèle de pointe est un investissement ponctuel ; le servir aux utilisateurs est un coût d'exploitation permanent. Les estimations placent les dépenses en serveurs IA sur une courbe ascendante, et la part de calcul consacrée à l'inférence plutôt qu'à l'entraînement constitue désormais la majorité des heures GPU déployées. Pour la plupart des entreprises, la question n'est plus « quel GPU est le plus rapide » mais « quel serveur GPU maintient un coût par million de tokens bas à ma concurrence, ma taille de modèle et mon budget de puissance en baie ». Ce guide y répond avec des chiffres.
Que consomme réellement l'inférence LLM ?
Réponse rapide : l'inférence est limitée par la bande passante mémoire, pas par la puissance de calcul. Générer chaque token revient à faire transiter les poids du modèle et le cache KV dans le GPU ; le débit de tokens par seconde dépend donc bien plus de la bande passante mémoire et de la taille du lot que des TFLOPS bruts.
Deux phases comptent. Le prefill traite l'intégralité du prompt en parallèle et sollicite le calcul ; le decode génère la sortie token par token et sollicite la bande passante mémoire. Les prompts longs et les sorties longues sollicitent donc des ressources différentes. C'est pourquoi une carte à gros TFLOPS mais à faible VRAM et bande passante étroite peut perdre face à une carte « plus lente » mais mieux dotée en bande passante sur de vraies charges de chat. Pour dimensionner un serveur, considérez ensemble la capacité VRAM, la bande passante VRAM et la topologie NVLink/PCIe, et non le seul pic FLOPS de la fiche technique.
Combien de VRAM pour les modèles 7B, 13B, 70B et 180B ?
Réponse rapide : comptez environ 2 octets par paramètre en FP16, 1 octet en INT8 et 0,5 octet en INT4, puis ajoutez 15-30 % pour le cache KV et les frais d'exécution. Un modèle 70B en INT8 nécessite environ 80-100 Go avant le batching, soit au minimum des cartes 2x48 Go ou 4x24 Go.
Le cache KV est le coût caché. Il croît avec la longueur de contexte x le nombre de séquences simultanées x le nombre de couches ; un serveur qui tient un modèle en contexte 4K peut manquer de mémoire en 32K ou à forte concurrence. Dimensionnez la VRAM pour la longueur de contexte p95 et la concurrence cible, pas pour le prompt de démonstration. Règle générale : les déploiements optimisés pour l'inférence conservent 20-30 % de marge de VRAM pour que l'ordonnanceur puisse batcher agressivement sans redémarrage pour OOM.
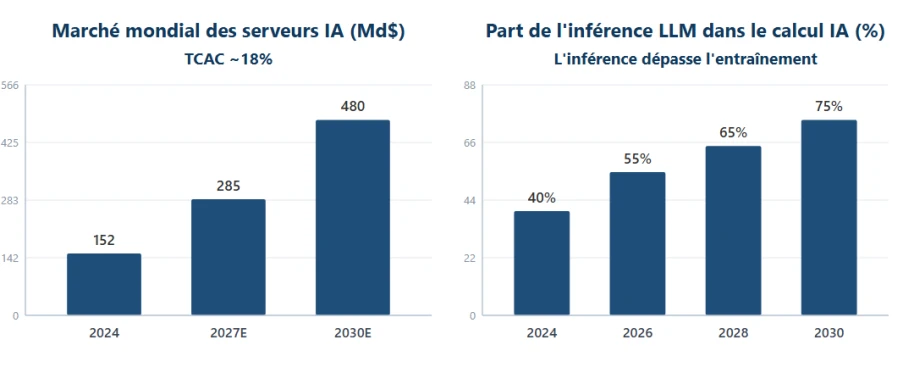
Figure 1 : taille du marché des serveurs IA et part croissante de l'inférence LLM (sources en annexe)
4U multi-GPU ou châssis 8 GPU ? Topologie, refroidissement et extension
Réponse rapide : un serveur 4U avec 4-5 GPU double largeur est l'optimum pour la plupart des déploiements LLM privés ; ne passez à une plateforme 8 GPU NVLink que si un modèle doit s'étendre sur plus de quatre GPU ou si vous avez besoin du débit maximal par nœud.
La topologie décide si l'inférence multi-GPU passe à l'échelle. Une distribution purement PCIe suffit pour les petits modèles et le service en parallélisme de données, mais le service en parallélisme tensoriel d'un modèle 70B+ exige des liens GPU-GPU à haut débit (NVLink/NVSwitch), sinon l'interconnexion devient le goulot. Le thermique décide de la survie : quatre ou cinq cartes double largeur de 350-700 W dans un 4U exigent un module de ventilateurs GPU arrière dédié et un flux d'air avant-arrière. Prévoyez des alimentations redondantes 3+1 ou 2+2 et vérifiez que la baie fournit l'ampérage.
▪ GPU unique : idéal pour les prototypes 7B-13B et les outils internes à faible concurrence.
▪ 2-4 GPU dans un 4U : meilleur équilibre capacité/redondance/puissance pour les modèles 32B-70B.
▪ Nœud 8 GPU NVLink : pour le service tensoriel 70B+, les API multi-tenant ou les flottes d'agents.
▪ Vérifiez toujours l'attribution des voies PCIe et le dégagement des ventilateurs arrière avant d'acheter.
Scénarios d'inférence LLM vs configuration de serveur GPU (2026)
Le tableau ci-dessous associe des charges d'inférence typiques à une enveloppe matérielle de départ. Traitez-le comme une base de dimensionnement, puis affinez avec les tokens par seconde mesurés sur votre propre mix de prompts.
Scénario | Modèle et concurrence | Configuration GPU | VRAM cible | Plateforme recommandée |
Prototype / développeur seul | 7B-13B, 1-3 utilisateurs | 1 GPU double largeur | 24-48 Go | Station GPU 1U/2U |
Inférence d'équipe | 7B-32B, 5-20 utilisateurs | 1-2 GPU double largeur | 48-96 Go | Serveur GPU 2U |
LLM de département | 70B (INT8), 20-50 utilisateurs | 2-4 GPU | 96-160 Go | Serveur 4U 4 GPU |
Service entreprise | 70B-180B, 50-200 utilisateurs | 4-8 GPU + NVLink | 160-640 Go | Nœud 4U/8 GPU NVLink |
Multi-tenant / agents | Tout, 200+ utilisateurs | 8 GPU centre de données | 640 Go+ | 8 GPU HGX / cluster |
Tableau 1 : charges d'inférence LLM vs configurations de serveur GPU (2026)
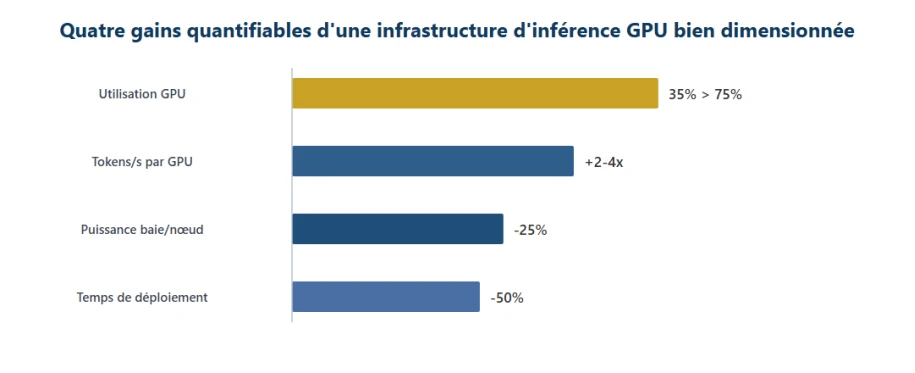
Figure 2 : quatre gains quantifiables d'une infrastructure d'inférence GPU bien dimensionnée (illustratif, sources en annexe)
Puissance, refroidissement et la salle que vous avez oublié de budgéter
Réponse rapide : les serveurs GPU denses transforment une baie en radiateur. Un nœud 4U avec quatre GPU de 600 W, plus CPU et ventilateurs, peut tirer 3-4 kW ; les nœuds 8 GPU dépassent 8-10 kW. Confirmez que votre PDU, votre circuit et votre refroidissement le supportent avant l'arrivée du matériel.
Le sens du flux d'air, le confinement des allées chaudes et la température ambiante déterminent si les GPU vont throttler sous charge d'inférence soutenue. Si votre site ne peut pas supporter des baies haute densité, un nœud 4U/4 GPU à puissance modérée est souvent plus fiable qu'un monstre 8 GPU théorique qui throttle thermiquement. Le bruit est l'autre contrainte oubliée : les modules de ventilateurs GPU arrière sont bruyants ; prévoyez de les placer loin des personnes.
Serveurs GPU ChangFan : une plateforme complète conçue pour l'inférence IA
L'IA industrielle, c'est 70 % de charge de travail et 30 % de matériel, mais les 30 % mal choisis peuvent annuler les 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) conçoit des serveurs GPU rack destinés à l'inférence soutenue : plateformes 4U jusqu'à 5 GPU double largeur sur double Intel Xeon Scalable (1re-5e gén.), jusqu'à 4 To de mémoire DDR4/DDR5 ECC ; variantes mono-socket AMD EPYC 7002/7003/8004 avec 4 GPU double largeur ; châssis 24 baies avec NVMe en option pour le stockage des modèles. Chaque unité est livrée avec un module de ventilateurs GPU arrière dédié, une alimentation redondante 1+1 ou 2+2, un réseau Gigabit intégré, une extension PCIe et la gestion à distance IPMI.
Si vous évaluez un LLM privé, une API d'inférence ou une flotte d'agents, contactez ChangFan pour une recommandation de configuration complète dimensionnée selon taille de modèle x concurrence x puissance en baie (matériel uniquement, sans abonnement logiciel). La personnalisation OEM/ODM est prise en charge pour les intégrateurs et les marques.
Questions fréquentes (FAQ)
Q1 : Combien de GPU faut-il pour l'inférence d'un modèle 7B ?
R : Une seule carte de 24 Go fait tourner un modèle 7B en INT8 ; en FP16 avec une concurrence modérée, une carte de 48 Go ou deux de 24 Go offrent une marge confortable. La VRAM, et non les FLOPS, est la première contrainte.
Q2 : Faut-il des cartes RTX grand public ou des GPU de centre de données ?
R : Les cartes grand public l'emportent sur le prix par Go pour les prototypes et les outils internes à faible concurrence ; les GPU de centre de données l'emportent sur la bande passante mémoire, le NVLink, l'ECC et la fiabilité 24/7. Choisissez selon le SLA et la concurrence, pas selon le pic FLOPS.
Q3 : Un serveur 4U 4 GPU suffit-il pour un modèle 70B ?
R : Pour un service INT8 à concurrence modérée, oui : 4x48 Go (192 Go) contiennent confortablement un modèle 70B INT8 plus le cache KV. Pour du FP16, une forte concurrence ou des modèles 180B, passez à un nœud 8 GPU NVLink.
Q4 : Plus de VRAM signifie-t-il toujours une inférence plus rapide ?
R : Non. Les tokens par seconde dépendent de la bande passante mémoire, de la taille du lot et de l'interconnexion. Une capacité supplémentaire évite l'OOM et permet de plus grands lots, mais la bande passante et la topologie décident du débit.
Q5 : Puis-je ajouter des GPU à un serveur 2U standard plus tard ?
R : Généralement non, pas en toute sécurité : les serveurs standard manquent de câblage d'alimentation GPU, de modules de ventilateurs arrière et d'attribution de voies PCIe pour les cartes double largeur. Achetez dès le départ un châssis conçu pour les GPU.
- Article précédent Montée en puissance de l'Edge AI en 2026 : D'Orin à Thor, comment Changfan sécurise l'infrastructure de calcul pour l'« IA Physique » (Physical AI)
- Article suivant Il n'y en a plus