Cara Memilih Server GPU untuk Inferensi LLM di 2026: VRAM, Topologi, dan Pendingin
Pendahuluan: Tagihan AI Sebenarnya Jatuh pada Inferensi
Pada 2026, percakapan tentang AI telah bergeser dari pelatihan ke inferensi. Melatih model terdepan adalah kejadian modal satu kali; melayani model tersebut kepada pengguna adalah biaya operasional permanen. Estimasi industri menunjukkan pengeluaran server AI berada pada kurva yang curam, dan proporsi komputasi yang didedikasikan untuk inferensi daripada pelatihan kini merupakan mayoritas jam GPU yang diterapkan. Bagi sebagian besar perusahaan, pertanyaan praktisnya bukan lagi 'GPU mana yang tercepat' melainkan 'server GPU mana yang menjaga biaya per juta token tetap rendah pada konkurensi, ukuran model, dan anggaran daya rak saya'. Panduan ini menjawabnya dengan angka.
Apa yang Sebenarnya Dikonsumsi oleh Inferensi LLM?
Jawaban cepat: inferensi dibatasi oleh bandwidth memori, bukan komputasi. Menghasilkan setiap token berarti menyalurkan bobot model dan KV cache melalui GPU, sehingga token per detik skala dengan bandwidth memori dan ukuran batch jauh lebih dari TFLOPS puncak.
Dua fase penting. Prefill memproses seluruh prompt secara paralel dan berat secara komputasi; decode menghasilkan keluaran token demi token dan berat pada bandwidth memori. Oleh karena itu, prompt panjang dan keluaran panjang menekan sumber daya yang berbeda. Itulah alasan kartu dengan TFLOPS besar tetapi VRAM kecil dan bandwidth sempit bisa kalah dari kartu 'lebih lambat' dengan bandwidth memori lebih besar pada beban kerja obrolan nyata. Saat menentukan ukuran server, perhatikan kapasitas VRAM, bandwidth VRAM, dan topologi NVLink/PCIe bersama-sama, bukan hanya FLOPS puncak di lembar spesifikasi.
Berapa VRAM yang Anda Butuhkan untuk Model 7B, 13B, 70B, dan 180B?
Jawaban cepat: alokasikan sekitar 2 byte per parameter pada FP16, 1 byte pada INT8, dan 0,5 byte pada INT4, lalu tambahkan 15-30% untuk KV cache dan overhead runtime. Satu model 70B pada INT8 membutuhkan sekitar 80-100 GB sebelum batching, yang berarti setidaknya 2x48GB atau 4x24GB kartu.
KV cache adalah biaya tersembunyi. Ia tumbuh dengan panjang konteks x urutan konkuren x lapisan, sehingga server yang muat model pada konteks 4K bisa kehabisan memori pada 32K atau konkurensi tinggi. Rencanakan VRAM untuk panjang konteks p95 dan konkurensi target, bukan prompt demo. Sebagai aturan praktis, penerapan yang dioptimalkan untuk inferensi menyisakan 20-30% ruang VRAM agar penjadwal dapat melakukan batch secara agresif tanpa restart akibat kehabisan memori (OOM).
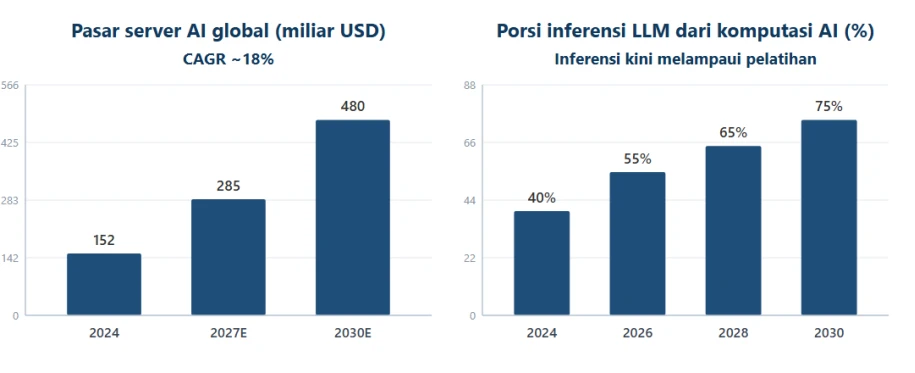
Gambar 1: Ukuran pasar server AI dan meningkatnya porsi inferensi LLM (sumber data di lampiran)
Server 4U Multi-GPU atau Sasis 8-GPU? Topologi, Pendingin, dan Ekspansi
Jawaban cepat: satu server 4U dengan 4-5 GPU berlebar ganda adalah titik manis untuk sebagian besar penerapan LLM privat; beralih ke platform 8-GPU NVLink hanya ketika satu model harus mencakup lebih dari empat GPU atau Anda membutuhkan throughput per-node maksimum.
Topologi menentukan apakah inferensi multi-GPU diskalakan. Fan-out hanya PCIe cukup untuk model kecil dan pelayanan data-paralel, tetapi pelayanan tensor-paralel model 70B+ membutuhkan tautan GPU-ke-GPU bandwidth tinggi (NVLink/NVSwitch), atau interkoneksi menjadi hambatan. Termal menentukan apakah ia bertahan: empat atau lima kartu berlebar ganda 350-700W dalam 4U membutuhkan modul kipas GPU belakang khusus dan aliran udara depan-belakang. Rencanakan catu daya redundan 3+1 atau 2+2 dan pastikan rak dapat menyediakan arus yang cukup.
▪ GPU tunggal: terbaik untuk prototipe 7B-13B dan alat internal berkonkurensi rendah.
▪ 2-4 GPU dalam satu 4U: keseimbangan terbaik kapasitas, redundansi, dan daya untuk model 32B-70B.
▪ Node 8-GPU NVLink: untuk pelayanan tensor-paralel 70B+, API multi-penyewa, atau armada agen.
▪ Selalu verifikasi alokasi jalur PCIe dan ruang kipas belakang sebelum membeli.
Skenario Inferensi LLM vs Konfigurasi Server GPU (2026)
Tabel di bawah memetakan beban kerja inferensi khas ke amplop perangkat keras awal. Anggap ini sebagai dasar penentuan ukuran, lalu sempurnakan berdasarkan token per detik terukur pada campuran prompt Anda sendiri.
Skenario | Model & konkurensi | Konfigurasi GPU | Target VRAM | Platform yang disarankan |
Prototipe / pengembang tunggal | 7B-13B, 1-3 pengguna | 1x GPU berlebar ganda | 24-48 GB | Stasiun kerja GPU 1U/2U |
Inferensi tim | 7B-32B, 5-20 pengguna | 1-2x GPU berlebar ganda | 48-96 GB | Server GPU 2U |
LLM departemen | 70B (INT8), 20-50 pengguna | 2-4x GPU | 96-160 GB | Server 4U 4-GPU |
Layanan perusahaan | 70B-180B, 50-200 pengguna | 4-8x GPU + NVLink | 160-640 GB | Node 4U/8-GPU NVLink |
Multi-penyewa / agen | Apa pun, 200+ pengguna | 8x GPU pusat data | 640 GB+ | HGX 8-GPU / klaster |
Tabel 1: Beban kerja inferensi LLM vs konfigurasi server GPU (2026)
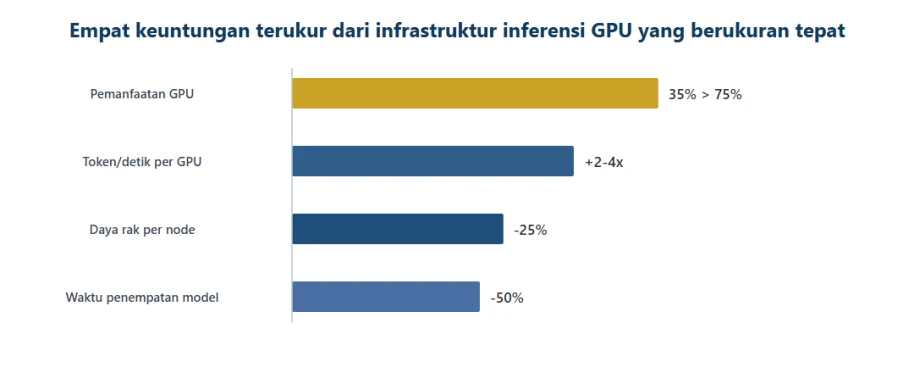
Gambar 2: Empat keuntungan terukur dari infrastruktur inferensi GPU yang berukuran tepat (ilustratif, sumber data di lampiran)
Daya, Pendingin, dan Ruangan yang Anda Lupa Anggarkan
Jawaban cepat: server GPU padat mengubah rak menjadi pemanas ruangan. Satu node 4U dengan empat GPU 600W plus CPU dan kipas dapat menarik 3-4 kW; node delapan GPU melewati 8-10 kW. Pastikan PDU, sirkuit, dan pendingin Anda sanggup sebelum perangkat keras tiba.
Arah aliran udara, enkapsulasi lorong panas, dan suhu lingkungan semua memengaruhi apakah GPU melakukan throttling di bawah beban inferensi berkelanjutan. Jika fasilitas Anda tidak mendukung rak berdensitas tinggi, node 4U/4-GPU dengan daya sedang sering lebih andal daripada 'monster' 8-GPU teoretis yang mengalami throttling termal. Kebisingan adalah kendala terlupakan lainnya: modul kipas GPU belakang sangat berisik, jadi rencanakan penempatannya jauh dari orang.
Server GPU ChangFan: Platform Sistem Utuh yang Dibangun untuk Inferensi AI
AI industri adalah 70% beban kerja dan 30% perangkat keras, tetapi 30% yang salah dapat menghapus 70% tersebut. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) membangun server GPU rackmount yang direkayasa untuk inferensi berkelanjutan: platform 4U mendukung hingga 5 GPU berlebar ganda pada Intel Xeon Scalable (Generasi 1-5) soket ganda dengan memori ECC DDR4/DDR5 hingga 4TB, varian soket tunggal AMD EPYC 7002/7003/8004 dengan 4 GPU berlebar ganda, dan sasis 24-bay dengan NVMe opsional untuk penyimpanan model. Setiap unit dilengkapi modul kipas GPU belakang khusus, catu daya redundan 1+1 atau 2+2, jaringan Gigabit bawaan, ekspansi PCIe, dan manajemen jarak jauh IPMI.
Jika Anda mengevaluasi LLM privat, API inferensi, atau armada agen, hubungi ChangFan untuk rekomendasi konfigurasi sistem utuh yang diukur berdasarkan ukuran model x konkurensi x daya rak (hanya perangkat keras sistem utuh, tanpa langganan perangkat lunak). Kustomisasi OEM/ODM didukung untuk integrator dan merek.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Berapa banyak GPU yang dibutuhkan model 7B untuk inferensi?
A: Satu kartu 24GB menjalankan model 7B pada INT8; untuk FP16 dan konkurensi sedang, satu kartu 48GB atau dua kartu 24GB memberikan ruang yang nyaman. VRAM, bukan FLOPS, adalah kendala pertama.
Q2: Haruskah saya menggunakan kartu RTX konsumen atau GPU pusat data untuk inferensi?
A: Kartu konsumen menang dalam harga per GB untuk prototipe dan alat internal berkonkurensi rendah; GPU pusat data menang dalam bandwidth memori, NVLink, ECC, dan keandalan 24/7. Pilih berdasarkan SLA dan konkurensi, bukan FLOPS puncak.
Q3: Apakah server 4U 4-GPU cukup untuk model 70B?
A: Untuk layanan INT8 pada konkurensi sedang, ya: 4x48GB (192GB) dengan mudah menampung model 70B INT8 plus KV cache. Untuk FP16, konkurensi tinggi, atau model 180B, beralih ke node 8-GPU NVLink.
Q4: Apakah VRAM lebih banyak selalu berarti inferensi lebih cepat?
A: Tidak. Token per detik bergantung pada bandwidth memori, ukuran batch, dan interkoneksi. Kapasitas ekstra mencegah OOM dan memungkinkan batch lebih besar, tetapi bandwidth dan topologi yang menentukan throughput.
Q5: Dapatkah saya menambah GPU ke server 2U standar nanti?
A: Biasanya tidak aman: server standar kekurangan kabel daya GPU, modul kipas belakang, dan alokasi jalur PCIe untuk kartu berlebar ganda. Beli sasis yang dirancang untuk GPU sejak hari pertama.
- Artikel sebelumnya Ekspansi Edge AI 2026: Dari Orin ke Thor, Bagaimana Changfan Mengamankan Fondasi Komputasi untuk "AI Fisik" (Physical AI)
- Artikel berikutnya tidak ada lagi