Как выбрать GPU-сервер для LLM-инференса в 2026 году: VRAM, топология и охлаждение
Введение: инференс — там, где на самом деле формируется счёт за ИИ
В 2026 году разговор об ИИ сместился с обучения на инференс. Обучение фронтирной модели — разовая капитальная инвестиция; её обслуживание для пользователей — постоянные операционные расходы. Оценки показывают, что расходы на ИИ-серверы растут по крутой кривой, а доля вычислений, приходящаяся на инференс, а не на обучение, теперь составляет большинство развёрнутых GPU-часов. Для большинства компаний практический вопрос уже не «какой GPU быстрее», а «какой GPU-сервер удерживает низкую стоимость за миллион токенов при моей конкурентности, размере модели и бюджете мощности стойки». Это руководство отвечает цифрами.
Что на самом деле потребляет LLM-инференс?
Краткий ответ: инференс ограничен пропускной способностью памяти, а не вычислениями. Генерация каждого токена означает потоковую передачу весов модели и KV-кэша через GPU, поэтому токены в секунду масштабируются гораздо сильнее от пропускной способности памяти и размера батча, чем от чистых TFLOPS.
Важны две фазы. Prefill обрабатывает весь промпт параллельно и нагружает вычисления; decode генерирует вывод токен за токеном и нагружает память. Поэтому длинные промпты и длинные ответы нагружают разные ресурсы. Именно поэтому карта с огромными TFLOPS, но малым VRAM и узкой пропускной способностью может проиграть «более медленной» карте с большей пропускной способностью на реальных чат-нагрузках. При подборе сервера смотрите на объём VRAM, пропускную способность VRAM и топологию NVLink/PCIe вместе, а не только на пиковые FLOPS из спецификации.
Сколько VRAM нужно для моделей 7B, 13B, 70B и 180B?
Краткий ответ: закладывайте примерно 2 байта на параметр в FP16, 1 байт в INT8 и 0,5 байта в INT4, затем добавьте 15-30 % на KV-кэш и накладные расходы. Одной модели 70B в INT8 нужно около 80-100 ГБ до батчинга, то есть минимум карты 2x48 ГБ или 4x24 ГБ.
KV-кэш — скрытая статья расходов. Он растёт с длиной контекста x числом одновременных последовательностей x числом слоёв, поэтому сервер, вмещающий модель при контексте 4K, может исчерпать память при 32K или высокой конкурентности. Планируйте VRAM под длину контекста p95 и целевую конкурентность, а не под демонстрационный промпт. Как правило, оптимизированные под инференс развёртывания оставляют 20-30 % запаса VRAM, чтобы планировщик мог агрессивно батчить без перезапусков из-за OOM.
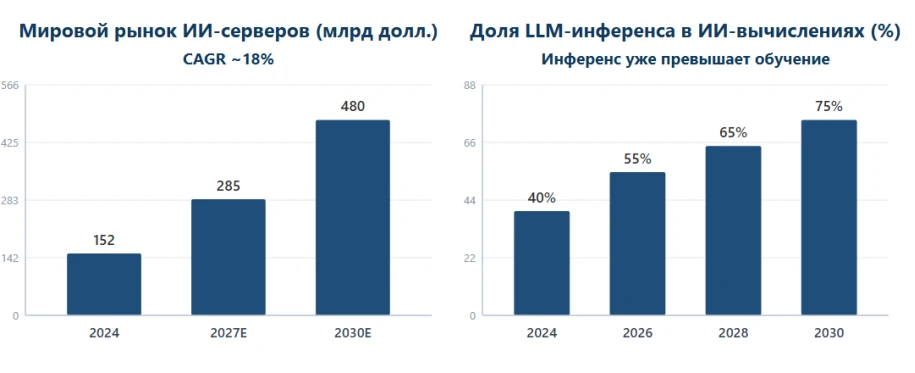
Рис. 1: объём рынка ИИ-серверов и рост доли LLM-инференса (источники в приложении)
4U multi-GPU или шасси на 8 GPU? Топология, охлаждение и расширение
Краткий ответ: один 4U-сервер с 4-5 GPU двойной ширины — оптимум для большинства частных LLM-развёртываний; переходите на платформу 8 GPU NVLink только если одна модель должна охватывать более четырёх GPU или нужен максимальный пропуск на узел.
Топология решает, масштабируется ли multi-GPU инференс. Чисто PCIe-распределения достаточно для небольших моделей и data-parallel обслуживания, но tensor-parallel обслуживание модели 70B+ требует высокоскоростных связей GPU-GPU (NVLink/NVSwitch), иначе interconnect становится узким местом. Термика решает, выживет ли система: четыре-пять карт двойной ширины 350-700 Вт в 4U требуют выделенного заднего модуля вентиляторов GPU и потока воздуха спереди назад. Предусмотрите резервирование питания 3+1 или 2+2 и убедитесь, что стойка выдаёт нужные амперы.
▪ Один GPU: лучше всего для прототипов 7B-13B и внутренних инструментов с низкой конкурентностью.
▪ 2-4 GPU в одном 4U: лучший баланс ёмкости, резервирования и мощности для моделей 32B-70B.
▪ Узел 8 GPU NVLink: для tensor-parallel обслуживания 70B+, мультитенантных API или флотов агентов.
▪ Всегда проверяйте распределение линий PCIe и зазор для задних вентиляторов перед покупкой.
Сценарии LLM-инференса против конфигурации GPU-сервера (2026)
Таблица ниже сопоставляет типовые нагрузки инференса с начальным аппаратным профилем. Используйте её как базу для подбора, затем уточните по измеренным токенам в секунду на вашем наборе промптов.
Сценарий | Модель и конкурентность | Конфигурация GPU | Цель по VRAM | Рекомендуемая платформа |
Прототип / один разработчик | 7B-13B, 1-3 пользователя | 1 GPU двойной ширины | 24-48 ГБ | GPU-станция 1U/2U |
Командный инференс | 7B-32B, 5-20 пользователей | 1-2 GPU двойной ширины | 48-96 ГБ | GPU-сервер 2U |
Отдел / LLM | 70B (INT8), 20-50 пользователей | 2-4 GPU | 96-160 ГБ | Сервер 4U на 4 GPU |
Корпоративное обслуживание | 70B-180B, 50-200 пользователей | 4-8 GPU + NVLink | 160-640 ГБ | Узел 4U/8 GPU NVLink |
Мультитенант / агенты | Любая, 200+ пользователей | 8 GPU ЦОД | 640 ГБ+ | 8 GPU HGX / кластер |
Таблица 1: нагрузки LLM-инференса против конфигураций GPU-сервера (2026)
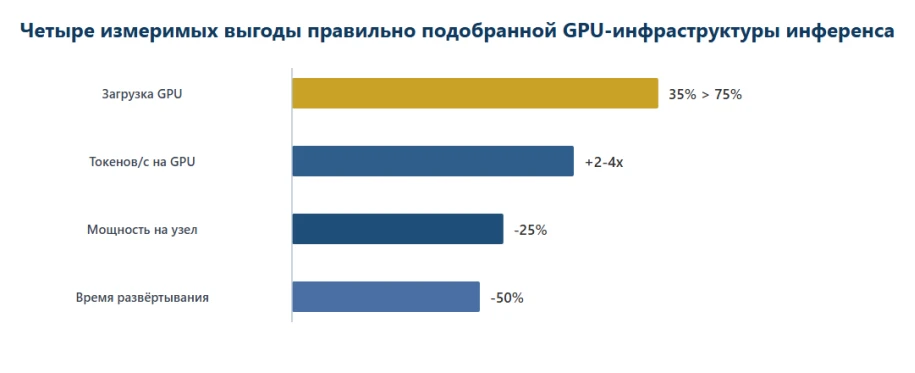
Рис. 2: четыре измеримых выгоды правильно подобранной GPU-инфраструктуры инференса (иллюстративно, источники в приложении)
Питание, охлаждение и помещение, которое вы забыли заложить в бюджет
Краткий ответ: плотные GPU-серверы превращают стойку в обогреватель. Узел 4U с четырьмя GPU по 600 Вт плюс CPU и вентиляторы может потреблять 3-4 кВт; узлы на 8 GPU превышают 8-10 кВт. Убедитесь, что PDU, цепь и охлаждение выдержат это до приезда оборудования.
Направление воздушного потока, изоляция горячих коридоров и температура окружающей среды определяют, будут ли GPU троттлить под длительной нагрузкой инференса. Если ваше помещение не поддерживает стойки высокой плотности, узел 4U/4 GPU умеренной мощности часто надёжнее теоретического «монстра» на 8 GPU, который троттлит по теплу. Шум — ещё одно забытое ограничение: задние модули вентиляторов GPU громкие, поэтому размещайте оборудование вдали от людей.
GPU-серверы ChangFan: платформа полного цикла для ИИ-инференса
Промышленный ИИ — это 70 % нагрузки и 30 % оборудования, но неверные 30 % могут обнулить 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) производит стоечные GPU-серверы для длительного инференса: платформы 4U с поддержкой до 5 GPU двойной ширины на двух Intel Xeon Scalable (1-5 поколения) с памятью DDR4/DDR5 ECC до 4 ТБ, односокетные варианты AMD EPYC 7002/7003/8004 с 4 GPU двойной ширины и шасси на 24 отсека с опциональным NVMe для хранения моделей. Каждый сервер оснащён выделенным задним модулем вентиляторов GPU, резервированием питания 1+1 или 2+2, встроенной сетью Gigabit, расширением PCIe и удалённым управлением IPMI.
Если вы оцениваете частную LLM, API инференса или флот агентов, свяжитесь с ChangFan для рекомендации по конфигурации полного цикла, рассчитанной по размеру модели x конкурентности x мощности стойки (только оборудование, без подписки на ПО). Поддерживается OEM/ODM-кастомизация для интеграторов и брендов.
Часто задаваемые вопросы (FAQ)
В1: Сколько GPU нужно модели 7B для инференса?
О: Одной карты 24 ГБ достаточно для 7B в INT8; для FP16 и умеренной конкурентности одна карта 48 ГБ или две по 24 ГБ дают комфортный запас. Первое ограничение — VRAM, а не FLOPS.
В2: Использовать потребительские RTX или серверные GPU?
О: Потребительские карты выигрывают по цене за ГБ для прототипов и внутренних инструментов с низкой конкурентностью; серверные GPU выигрывают по пропускной способности памяти, NVLink, ECC и надёжности 24/7. Выбирайте по SLA и конкурентности, а не по пиковым FLOPS.
В3: Достаточно ли сервера 4U на 4 GPU для модели 70B?
О: Для INT8-обслуживания при умеренной конкурентности да: 4x48 ГБ (192 ГБ) комфортно вмещают модель 70B INT8 плюс KV-кэш. Для FP16, высокой конкурентности или моделей 180B переходите на узел 8 GPU NVLink.
В4: Всегда ли больше VRAM означает более быстрый инференс?
О: Нет. Токены в секунду зависят от пропускной способности памяти, размера батча и interconnect. Дополнительная ёмкость предотвращает OOM и позволяет большие батчи, но пропускная способность и топология определяют throughput.
В5: Можно ли позже добавить GPU в стандартный 2U-сервер?
О: Обычно нет, безопасно нельзя: стандартным серверам не хватает кабелей питания GPU, задних модулей вентиляторов и распределения линий PCIe для карт двойной ширины. Покупайте шасси, спроектированное под GPU, с самого начала.
- Предыдущая статья Масштабирование Edge AI в 2026 году: От Orin к Thor — как Changfan закладывает вычислительный фундамент для «Физического ИИ» (Physical AI)
- Следующая статья Больше нет