Come scegliere un server GPU per l'inferenza LLM nel 2026: VRAM, topologia e raffreddamento
Introduzione: l'inferenza è dove arriva davvero il conto dell'IA
Nel 2026 il discorso sull'IA è passato dall'addestramento all'inferenza. Addestrare un modello di frontiera è un investimento una tantum; servirlo agli utenti è un costo operativo permanente. Le stime collocano la spesa per server IA su una curva ripida, e la quota di calcolo dedicata all'inferenza anziché all'addestramento rappresenta ormai la maggioranza delle ore GPU dispiegate. Per la maggior parte delle aziende la domanda pratica non è più «quale GPU è la più veloce» ma «quale server GPU mantiene basso il costo per milione di token con la mia concorrenza, dimensione del modello e budget di potenza nel rack». Questa guida risponde con i numeri.
Che cosa consuma davvero l'inferenza LLM?
Risposta rapida: l'inferenza è limitata dalla banda di memoria, non dal calcolo. Generare ogni token significa far scorrere i pesi del modello e la KV-cache attraverso la GPU, quindi i token al secondo scalano molto più con la banda di memoria e la dimensione del batch che con i TFLOPS grezzi.
Contano due fasi. Il prefill elabora l'intero prompt in parallelo ed è intensivo di calcolo; il decode genera l'output token per token ed è intensivo di banda di memoria. Prompt lunghi e output lunghi stressano quindi risorse diverse. È per questo che una scheda con TFLOPS enormi ma poca VRAM e banda stretta può perdere contro una scheda «più lenta» con più banda di memoria su carichi chat reali. Nel dimensionare un server, considerate insieme capacità VRAM, banda VRAM e topologia NVLink/PCIe, non solo il picco FLOPS della scheda tecnica.
Quanta VRAM servono per modelli 7B, 13B, 70B e 180B?
Risposta rapida: calcolate circa 2 byte per parametro in FP16, 1 byte in INT8 e 0,5 byte in INT4, poi aggiungete il 15-30 % per KV-cache e overhead di runtime. Un singolo modello 70B in INT8 richiede circa 80-100 GB prima del batching, cioè almeno schede 2x48GB o 4x24GB.
La KV-cache è il costo nascosto. Cresce con lunghezza di contesto x sequenze concorrenti x livelli, quindi un server che ospita un modello a contesto 4K può esaurire la memoria a 32K o con alta concorrenza. Pianificate la VRAM per la lunghezza di contesto p95 e la concorrenza target, non per il prompt dimostrativo. Come regola, i deployment ottimizzati per l'inferenza lasciano il 20-30 % di margine VRAM così lo scheduler può fare batching aggressivo senza riavvii per OOM.
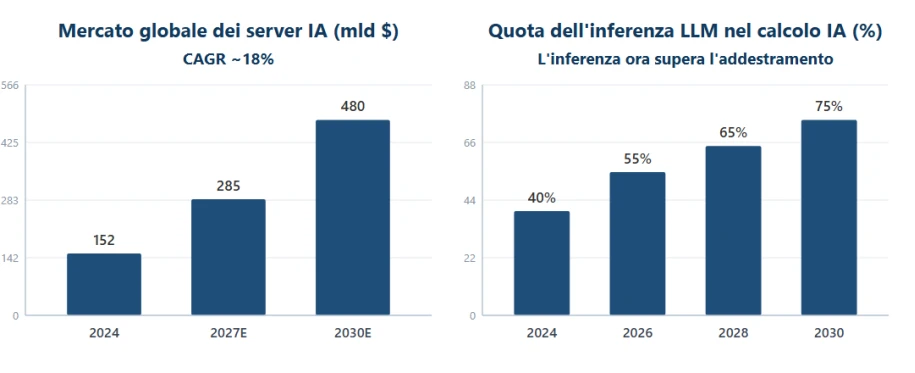
Figura 1: dimensione del mercato dei server IA e quota crescente dell'inferenza LLM (fonti in appendice)
4U multi-GPU o chassis a 8 GPU? Topologia, raffreddamento ed espansione
Risposta rapida: un server 4U con 4-5 GPU a doppia larghezza è il punto ottimale per la maggior parte dei deployment LLM privati; passate a una piattaforma 8 GPU NVLink solo quando un modello deve estendersi su più di quattro GPU o serve il massimo throughput per nodo.
La topologia decide se l'inferenza multi-GPU scala. La distribuzione solo PCIe basta per modelli piccoli e servizio in parallelismo di dati, ma il servizio in parallelismo tensoriale di un modello 70B+ richiede collegamenti GPU-GPU ad alta banda (NVLink/NVSwitch), altrimenti l'interconnessione diventa il collo di bottiglia. La termica decide se sopravvive: quattro o cinque schede a doppia larghezza da 350-700 W in 4U richiedono un modulo ventole GPU posteriore dedicato e flusso d'aria front-to-back. Prevedete alimentatori ridondanti 3+1 o 2+2 e verificate che il rack eroghi gli ampere.
▪ GPU singola: ideale per prototipi 7B-13B e strumenti interni a bassa concorrenza.
▪ 2-4 GPU in un 4U: miglior equilibrio tra capacità, ridondanza e potenza per modelli 32B-70B.
▪ Nodo 8 GPU NVLink: per servizio tensoriale 70B+, API multi-tenant o flotte di agenti.
▪ Verificate sempre l'assegnazione delle lane PCIe e lo spazio per la ventola posteriore prima di acquistare.
Scenari di inferenza LLM vs configurazione del server GPU (2026)
La tabella seguente mappa carichi di inferenza tipici su un involucro hardware di partenza. Trattatela come base di dimensionamento, poi perfezionatela con i token al secondo misurati sul vostro mix di prompt.
Scenario | Modello e concorrenza | Configurazione GPU | VRAM target | Piattaforma consigliata |
Prototipo / singolo sviluppatore | 7B-13B, 1-3 utenti | 1 GPU a doppia larghezza | 24-48 GB | Workstation GPU 1U/2U |
Inferenza di team | 7B-32B, 5-20 utenti | 1-2 GPU a doppia larghezza | 48-96 GB | Server GPU 2U |
LLM dipartimentale | 70B (INT8), 20-50 utenti | 2-4 GPU | 96-160 GB | Server 4U a 4 GPU |
Servizio enterprise | 70B-180B, 50-200 utenti | 4-8 GPU + NVLink | 160-640 GB | Nodo 4U/8 GPU NVLink |
Multi-tenant / agenti | Qualsiasi, 200+ utenti | 8 GPU data center | 640 GB+ | 8 GPU HGX / cluster |
Tabella 1: carichi di inferenza LLM vs configurazioni server GPU (2026)
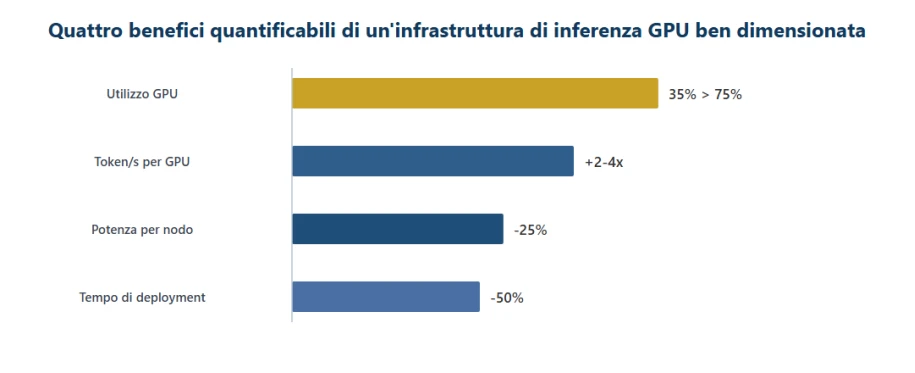
Figura 2: quattro benefici quantificabili di un'infrastruttura di inferenza GPU ben dimensionata (illustrativo, fonti in appendice)
Potenza, raffreddamento e la sala che avete dimenticato di preventivare
Risposta rapida: i server GPU densi trasformano un rack in un radiatore. Un nodo 4U con quattro GPU da 600 W, più CPU e ventole, può assorbire 3-4 kW; i nodi a 8 GPU superano gli 8-10 kW. Confermate che PDU, circuito e raffreddamento lo supportino prima che arrivi l'hardware.
Direzione del flusso d'aria, contenimento dei corridoi caldi e temperatura ambiente determinano se le GPU rallentano sotto carico di inferenza prolungato. Se la struttura non supporta rack ad alta densità, un nodo 4U/4 GPU a potenza moderata è spesso più affidabile di un mostro teorico a 8 GPU che va in throttling termico. Il rumore è l'altro vincolo dimenticato: i moduli ventole GPU posteriori sono rumorosi, quindi pianificate la collocazione lontano dalle persone.
Server GPU ChangFan: una piattaforma completa pensata per l'inferenza IA
L'IA industriale è 70 % carico di lavoro e 30 % hardware, ma il 30 % sbagliato può annullare il 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) realizza server GPU rack progettati per l'inferenza continua: piattaforme 4U con fino a 5 GPU a doppia larghezza su doppio Intel Xeon Scalable (1ª-5ª gen.) con fino a 4 TB di memoria DDR4/DDR5 ECC, varianti single-socket AMD EPYC 7002/7003/8004 con 4 GPU a doppia larghezza e chassis a 24 bay con NVMe opzionale per lo storage dei modelli. Ogni unità include un modulo ventole GPU posteriore dedicato, alimentazione ridondante 1+1 o 2+2, rete Gigabit integrata, espansione PCIe e gestione remota IPMI.
Se state valutando un LLM privato, un'API di inferenza o una flotta di agenti, contattate ChangFan per una raccomandazione di configurazione completa dimensionata per dimensione modello x concorrenza x potenza rack (solo hardware, senza abbonamento software). La personalizzazione OEM/ODM è supportata per integratori e marchi.
Domande frequenti (FAQ)
D1: Quante GPU servono a un modello 7B per l'inferenza?
R: Una singola scheda da 24 GB esegue un modello 7B in INT8; per FP16 e concorrenza moderata, una scheda da 48 GB o due da 24 GB offrono margine comodo. La VRAM, non i FLOPS, è il primo vincolo.
D2: Meglio schede RTX consumer o GPU data center?
R: Le schede consumer vincono sul prezzo per GB per prototipi e strumenti interni a bassa concorrenza; le GPU data center vincono su banda di memoria, NVLink, ECC e affidabilità 24/7. Scegliete in base a SLA e concorrenza, non al picco FLOPS.
D3: Un server 4U a 4 GPU basta per un modello 70B?
R: Per servizio INT8 a concorrenza moderata, sì: 4x48 GB (192 GB) ospitano comodamente un modello 70B INT8 più KV-cache. Per FP16, alta concorrenza o modelli 180B, passate a un nodo 8 GPU NVLink.
D4: Più VRAM significa sempre inferenza più veloce?
R: No. I token al secondo dipendono da banda di memoria, dimensione del batch e interconnessione. Più capacità evita OOM e consente batch maggiori, ma banda e topologia decidono il throughput.
D5: Posso aggiungere GPU a un server 2U standard in seguito?
R: Di solito no in sicurezza: i server standard mancano di cablaggio di alimentazione GPU, moduli ventole posteriori e assegnazione lane PCIe per schede a doppia larghezza. Acquistate fin dall'inizio uno chassis progettato per GPU.
- Articolo precedente L'espansione dell'Edge AI nel 2026: Da Orin a Thor, come Changfan protegge le fondamenta del calcolo per la "IA Fisica" (Physical AI)
- Articolo successivo non c'è più nulla