GPU-Server für LLM-Inferenz richtig wählen (2026): VRAM, Topologie und Kühlung
Einleitung: Inferenz ist, wo die KI-Rechnung tatsächlich ankommt
2026 hat sich das KI-Gespräch vom Training zur Inferenz verschoben. Ein Frontier-Modell zu trainieren ist eine einmalige Investition; es Nutzern bereitzustellen ist dauerhafte Betriebskosten. Schätzungen setzen die Ausgaben für KI-Server auf eine steile Kurve, und der Anteil der Rechenleistung, der auf Inferenz statt Training entfällt, macht inzwischen die Mehrheit der eingesetzten GPU-Stunden aus. Für die meisten Unternehmen lautet die praktische Frage nicht mehr „welche GPU ist am schnellsten“, sondern „welcher GPU-Server hält die Kosten pro Million Tokens bei meiner Parallelität, Modellgröße und meinem Rack-Leistungsbudget niedrig“. Dieser Leitfaden beantwortet das mit Zahlen.
Was verbraucht LLM-Inferenz eigentlich?
Kurzantwort: Inferenz ist speicherbandbreitenbegrenzt, nicht rechenbegrenzt. Jedes generierte Token bedeutet, die Modellgewichte und den KV-Cache durch die GPU zu streamen; Tokens pro Sekunde skalieren daher weit stärker mit Speicherbandbreite und Batchgröße als mit rohen TFLOPS.
Zwei Phasen zählen. Prefill verarbeitet den gesamten Prompt parallel und ist rechenintensiv; Decode erzeugt die Ausgabe Token für Token und ist speicherbandbreitenintensiv. Lange Prompts und lange Ausgaben belasten daher unterschiedliche Ressourcen. Deshalb kann eine Karte mit riesigen TFLOPS, aber wenig VRAM und schmaler Bandbreite bei echten Chat-Workloads gegen eine „langsamere“ Karte mit mehr Speicherbandbreite verlieren. Bei der Serverdimensionierung sollten VRAM-Kapazität, VRAM-Bandbreite und NVLink/PCIe-Topologie gemeinsam betrachtet werden, nicht nur die Spitzen-FLOPS im Datenblatt.
Wie viel VRAM brauchen Modelle mit 7B, 13B, 70B und 180B?
Kurzantwort: rechnen Sie mit etwa 2 Byte pro Parameter in FP16, 1 Byte in INT8 und 0,5 Byte in INT4 und addieren Sie 15-30 % für KV-Cache und Laufzeit-Overhead. Ein einzelnes 70B-Modell in INT8 benötigt vor dem Batching etwa 80-100 GB, also mindestens 2x48GB- oder 4x24GB-Karten.
Der KV-Cache sind die versteckten Kosten. Er wächst mit Kontextlänge x gleichzeitigen Sequenzen x Schichten; ein Server, der ein Modell bei 4K-Kontext fasst, kann bei 32K oder hoher Parallelität den Speicher sprengen. Planen Sie VRAM für die p95-Kontextlänge und die Zielparallelität, nicht für den Demo-Prompt. Faustregel: Inferenzoptimierte Deployments lassen 20-30 % VRAM-Reserve, damit der Scheduler aggressiv batchen kann, ohne wegen OOM neu zu starten.
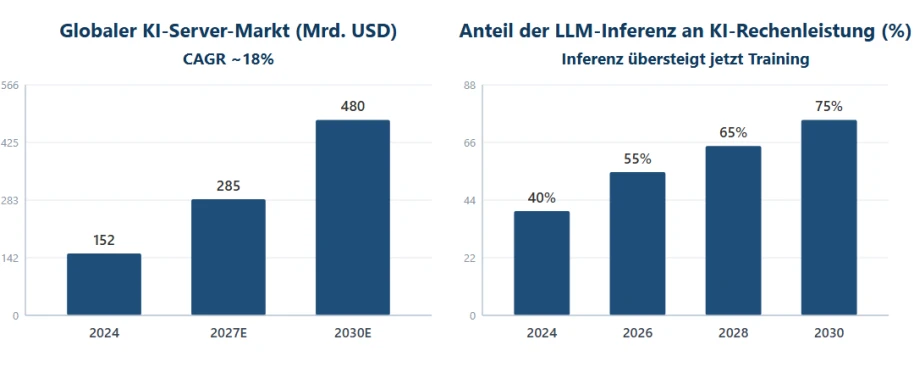
Abbildung 1: Marktgröße für KI-Server und steigender Anteil der LLM-Inferenz (Quellen im Anhang)
4U-Multi-GPU oder 8-GPU-Chassis? Topologie, Kühlung und Erweiterung
Kurzantwort: ein 4U-Server mit 4-5 Dual-Width-GPUs ist der Sweet Spot für die meisten privaten LLM-Deployments; wechseln Sie nur dann zu einer 8-GPU-NVLink-Plattform, wenn ein Modell mehr als vier GPUs überspannen muss oder Sie maximalen Durchsatz pro Knoten brauchen.
Die Topologie entscheidet, ob Multi-GPU-Inferenz skaliert. Reine PCIe-Verteilung reicht für kleine Modelle und Datenparallelität, aber Tensor-Parallelität eines 70B+-Modells benötigt GPU-zu-GPU-Verbindungen mit hoher Bandbreite (NVLink/NVSwitch), sonst wird die Verbindung zum Flaschenhals. Die Thermik entscheidet über das Überleben: vier oder fünf Dual-Width-Karten mit 350-700 W in 4U erfordern ein dediziertes rückseitiges GPU-Lüftermodul und Front-to-Back-Luftstrom. Planen Sie 3+1- oder 2+2-redundante Netzteile ein und prüfen Sie, ob das Rack die Ampere liefert.
▪ Einzelne GPU: ideal für 7B-13B-Prototypen und interne Tools mit geringer Parallelität.
▪ 2-4 GPUs in einem 4U: bestes Gleichgewicht aus Kapazität, Redundanz und Leistung für 32B-70B-Modelle.
▪ 8-GPU-NVLink-Knoten: für 70B+-Tensor-Parallelität, Multi-Tenant-APIs oder Agenten-Flotten.
▪ Prüfen Sie vor dem Kauf stets die PCIe-Lane-Zuteilung und den Freiraum für den rückseitigen Lüfter.
LLM-Inferenzszenarien vs. GPU-Server-Konfiguration (2026)
Die folgende Tabelle ordnet typische Inferenz-Workloads einer Start-Hardware-Hülle zu. Behandeln Sie sie als Dimensionierungsbasis und verfeinern Sie sie mit gemessenen Tokens pro Sekunde auf Ihrem eigenen Prompt-Mix.
Szenario | Modell & Parallelität | GPU-Konfiguration | VRAM-Ziel | Empfohlene Plattform |
Prototyp / Einzelentwickler | 7B-13B, 1-3 Nutzer | 1x Dual-Width-GPU | 24-48 GB | 1U/2U-GPU-Workstation |
Team-Inferenz | 7B-32B, 5-20 Nutzer | 1-2x Dual-Width-GPU | 48-96 GB | 2U-GPU-Server |
Abteilungs-LLM | 70B (INT8), 20-50 Nutzer | 2-4x GPU | 96-160 GB | 4U-Server mit 4 GPUs |
Enterprise-Serving | 70B-180B, 50-200 Nutzer | 4-8x GPU + NVLink | 160-640 GB | 4U/8-GPU-NVLink-Knoten |
Multi-Tenant / Agenten | Beliebig, 200+ Nutzer | 8x Rechenzentrums-GPU | 640 GB+ | 8-GPU-HGX / Cluster |
Tabelle 1: LLM-Inferenz-Workloads vs. GPU-Server-Konfigurationen (2026)
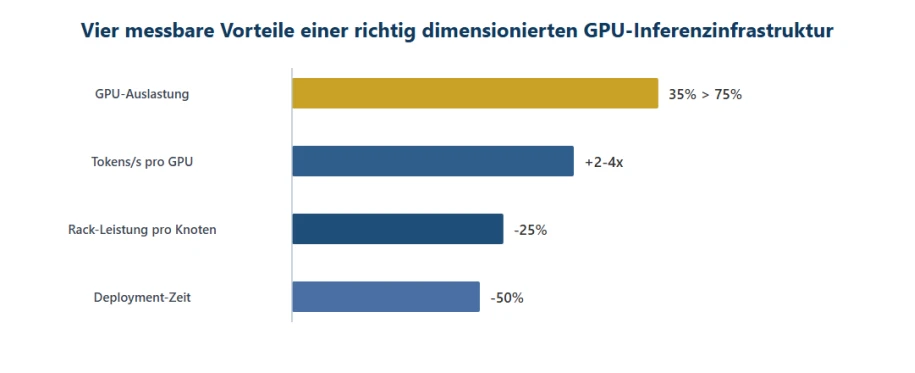
Abbildung 2: vier messbare Vorteile einer richtig dimensionierten GPU-Inferenzinfrastruktur (illustrativ, Quellen im Anhang)
Leistung, Kühlung und der Raum, den Sie vergessen haben einzupreisen
Kurzantwort: dichte GPU-Server machen aus einem Rack eine Heizung. Ein 4U-Knoten mit vier 600-W-GPUs plus CPUs und Lüftern kann 3-4 kW ziehen; 8-GPU-Knoten überschreiten 8-10 kW. Bestätigen Sie, dass PDU, Stromkreis und Kühlung das vor der Hardware-Ankunft tragen.
Luftstromrichtung, Einhausung der Warmgänge und Umgebungstemperatur entscheiden, ob GPUs unter Dauerlast drosseln. Kann Ihre Einrichtung keine Hochdichteschränke tragen, ist ein 4U/4-GPU-Knoten mit moderater Leistung oft zuverlässiger als ein theoretisches 8-GPU-Monster, das thermisch drosselt. Lärm ist die andere vergessene Randbedingung: rückseitige GPU-Lüftermodule sind laut, planen Sie den Standort abseits von Personen.
ChangFan GPU-Server: eine Gesamtsystem-Plattform für KI-Inferenz
Industrielle KI ist zu 70 % Workload und zu 30 % Hardware, aber die falschen 30 % können die 70 % zunichtemachen. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) baut Rack-GPU-Server für Dauerinferenz: 4U-Plattformen mit bis zu 5 Dual-Width-GPUs auf dualem Intel Xeon Scalable (1.-5. Gen.) mit bis zu 4 TB DDR4/DDR5-ECC-Speicher, Single-Socket-AMD-EPYC-7002/7003/8004-Varianten mit 4 Dual-Width-GPUs sowie 24-Bay-Chassis mit optionalem NVMe für Modellspeicher. Jede Einheit kommt mit dediziertem rückseitigem GPU-Lüftermodul, 1+1- oder 2+2-Redundanznetzteil, integriertem Gigabit-Netzwerk, PCIe-Erweiterung und IPMI-Fernverwaltung.
Wenn Sie ein privates LLM, eine Inferenz-API oder eine Agenten-Flotte evaluieren, kontaktieren Sie ChangFan für eine Gesamtsystem-Konfigurationsempfehlung, dimensioniert nach Modellgröße x Parallelität x Rack-Leistung (nur Hardware, kein Software-Abo). OEM/ODM-Anpassung wird für Integratoren und Marken unterstützt.
Häufige Fragen (FAQ)
F1: Wie viele GPUs braucht ein 7B-Modell für Inferenz?
A: Eine einzelne 24-GB-Karte betreibt ein 7B-Modell in INT8; für FP16 mit moderater Parallelität bieten eine 48-GB-Karte oder zwei 24-GB-Karten komfortable Reserve. VRAM, nicht FLOPS, ist die erste Einschränkung.
F2: Consumer-RTX-Karten oder Rechenzentrums-GPUs für Inferenz?
A: Consumer-Karten gewinnen beim Preis pro GB für Prototypen und interne Tools mit geringer Parallelität; Rechenzentrums-GPUs gewinnen bei Speicherbandbreite, NVLink, ECC und 24/7-Zuverlässigkeit. Entscheiden Sie nach SLA und Parallelität, nicht nach Spitzen-FLOPS.
F3: Reicht ein 4U-Server mit 4 GPUs für ein 70B-Modell?
A: Für INT8-Serving bei moderater Parallelität ja: 4x48 GB (192 GB) fassen ein 70B-INT8-Modell plus KV-Cache bequem. Für FP16, hohe Parallelität oder 180B-Modelle wechseln Sie zu einem 8-GPU-NVLink-Knoten.
F4: Bedeutet mehr VRAM immer schnellere Inferenz?
A: Nein. Tokens pro Sekunde hängen von Speicherbandbreite, Batchgröße und Verbindung ab. Mehr Kapazität verhindert OOM und ermöglicht größere Batches, aber Bandbreite und Topologie bestimmen den Durchsatz.
F5: Kann ich einem Standard-2U-Server später GPUs hinzufügen?
A: Meist nicht sicher: Standard-Server haben keine GPU-Stromverkabelung, rückseitigen Lüftermodule und PCIe-Lane-Zuteilung für Dual-Width-Karten. Kaufen Sie von Anfang an ein für GPUs ausgelegtes Chassis.
- Vorheriger Artikel Der Ausbau von Edge AI im Jahr 2026: Von Orin zu Thor – Wie Changfan das Rechenfundament für „Physical AI“ sichert
- Nächster Artikel Es ist keiner mehr übrig