Cara Memilih Pelayan GPU untuk LLM Inference pada 2026: VRAM, Topologi dan Penyejukan
Pengenalan: Inference adalah Di Mana Bil AI Sebenarnya Tiba
Pada 2026, perbualan AI telah beralih daripada latihan ke inference. Melatih model frontier adalah perbelanjaan modal sekali sahaja; menyajikannya kepada pengguna adalah kos operasi kekal. Anggaran industri meletakkan perbelanjaan pelayan AI pada lengkung curam, dan bahagian pengkomputeran yang diperuntukkan untuk inference dan bukannya latihan kini adalah majoriti GPU-jam yang dikerahkan. Untuk kebanyakan syarikat, soalan praktikal bukan lagi 'GPU mana paling pantas' tetapi 'pelayan GPU mana yang mengekalkan kos setiap juta token rendah pada keserentakan, saiz model dan bajet kuasa rak saya'. Panduan ini menjawab dengan nombor.
Apa Sebenarnya yang Dimakan oleh LLM Inference?
Jawapan pantas: inference dihadkan oleh lebar jalur memori, bukan pengkomputeran. Menjana setiap token bermakna menstrim pemberat model dan KV-cache melalui GPU, jadi token sesaat berkadar lebih kuat dengan lebar jalur memori dan saiz kelompok berbanding TFLOPS mentah.
Dua fasa penting. Prefill memproses keseluruhan gesa secara selari dan berat dari segi pengkomputeran; decode menjana output token demi token dan berat dari segi lebar jalur memori. Justeru gesa panjang dan output panjang memberi tekanan pada sumber berbeza. Itu sebabnya kad dengan TFLOPS besar tetapi VRAM kecil dan lebar jalur sempit boleh kalah dengan kad 'perlahan' yang mempunyai lebar jalur memori lebih besar pada beban sembang sebenar. Apabila menentukan saiz pelayan, lihat kapasiti VRAM, lebar jalur VRAM dan topologi NVLink/PCIe bersama-sama, bukan sekadar FLOPS puncak dalam helaian spesifikasi.
Berapa VRAM Diperlukan untuk Model 7B, 13B, 70B dan 180B?
Jawapan pantas: kira kira-kira 2 bait setiap parameter dalam FP16, 1 bait dalam INT8 dan 0.5 bait dalam INT4, kemudian tambah 15-30% untuk KV-cache dan overhed masa jalan. Satu model 70B dalam INT8 memerlukan kira-kira 80-100 GB sebelum kelompok, bermakna sekurang-kurangnya 2x48GB atau 4x24GB.
KV-cache adalah kos tersembunyi. Ia membesar dengan panjang konteks x jujukan serentak x lapisan, jadi pelayan yang memuatkan model pada konteks 4K boleh kehabisan memori pada 32K atau keserentakan tinggi. Rancang VRAM untuk panjang konteks p95 dan keserentakan sasaran, bukan gesa demo. Sebagai peraturan, penggunaan yang dioptimumkan untuk inference meninggalkan ruang VRAM 20-30% supaya penjadual boleh mengelompok secara agresif tanpa restart OOM.
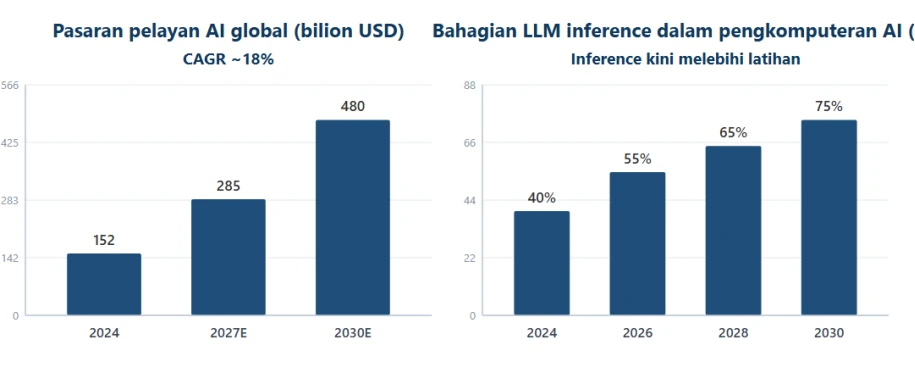
Rajah 1: Saiz pasaran pelayan AI dan peningkatan bahagian LLM inference (sumber dalam lampiran)
4U Multi-GPU atau Casis 8-GPU? Topologi, Penyejukan dan Pengembangan
Jawapan pantas: satu pelayan 4U dengan 4-5 GPU dwi-lebar adalah titik manis untuk kebanyakan penggunaan LLM persendirian; beralih ke platform 8-GPU NVLink hanya apabila satu model mesti merentasi lebih daripada empat GPU atau anda memerlukan daya pemprosesan maksimum setiap nod.
Topologi menentukan sama ada inference multi-GPU berskala. Penyebaran PCIe sahaja cukup untuk model kecil dan perkhidmatan selari-data, tetapi perkhidmatan selari-tensor model 70B+ memerlukan pautan GPU-ke-GPU lebar jalur tinggi (NVLink/NVSwitch), jika tidak interkoneksi menjadi kesesakan. Terma menentukan sama ada ia bertahan: 4-5 kad dwi-lebar 350-700W dalam 4U memerlukan modul kipas GPU belakang khusus dan aliran udara hadapan-ke-belakang. Rancang bekalan kuasa sandar 3+1 atau 2+2 dan sahkan rak dapat menyediakan amp.
▪ GPU tunggal: terbaik untuk prototaip 7B-13B dan alat dalaman keserentakan rendah.
▪ 2-4 GPU dalam satu 4U: keseimbangan kapasiti, sandaran dan kuasa terbaik untuk model 32B-70B.
▪ Nod 8-GPU NVLink: untuk perkhidmatan selari-tensor 70B+, API berbilang penyewa atau flit ejen.
▪ Sentiasa sahkan peruntukan lorong PCIe dan ruang kipas belakang sebelum membeli.
Senario LLM Inference berbanding Konfigurasi Pelayan GPU (2026)
Jadual di bawah memetakan beban kerja inference tipikal kepada sampul perkakasan permulaan. Gunakannya sebagai garis asas saiz, kemudian perhalusi dengan token sesaat yang diukur pada campuran gesa anda.
Senario | Model & keserentakan | Konfigurasi GPU | Sasaran VRAM | Platform disyorkan |
Prototaip / pemaju tunggal | 7B-13B, 1-3 pengguna | 1x GPU dwi-lebar | 24-48 GB | Stesen kerja GPU 1U/2U |
Inference pasukan | 7B-32B, 5-20 pengguna | 1-2x GPU dwi-lebar | 48-96 GB | Pelayan GPU 2U |
LLM jabatan | 70B (INT8), 20-50 pengguna | 2-4x GPU | 96-160 GB | Pelayan 4U 4-GPU |
Perkhidmatan enterprise | 70B-180B, 50-200 pengguna | 4-8x GPU + NVLink | 160-640 GB | Nod 4U/8-GPU NVLink |
Berbilang penyewa / ejen | Mana-mana, 200+ pengguna | 8x GPU pusat data | 640 GB+ | 8-GPU HGX / kelompok |
Jadual 1: Beban kerja LLM inference berbanding konfigurasi pelayan GPU (2026)
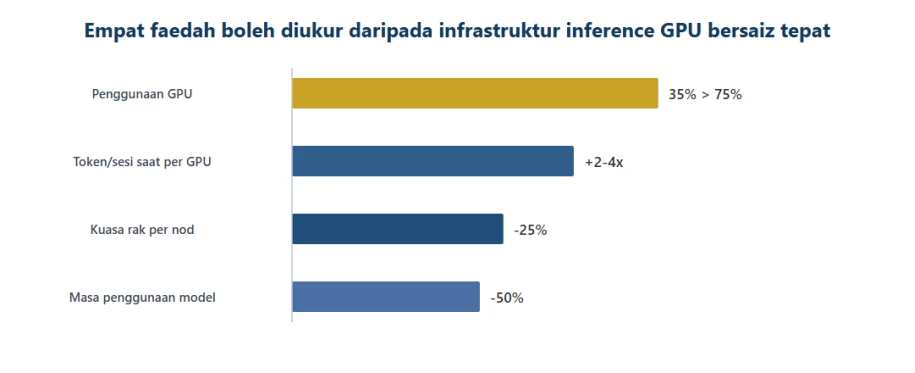
Rajah 2: Empat faedah boleh diukur daripada infrastruktur inference GPU bersaiz tepat (ilustrasi, sumber dalam lampiran)
Kuasa, Penyejukan dan Bilik yang Anda Lupa Bajetkan
Jawapan pantas: pelayan GPU padat mengubah rak menjadi pemanas. Nod 4U dengan empat GPU 600W ditambah CPU dan kipas boleh menarik 3-4 kW; nod 8-GPU melebihi 8-10 kW. Sahkan PDU, litar dan penyejukan dapat menanggungnya sebelum perkakasan tiba.
Arah aliran udara, pengasingan lorong panas dan suhu persekitaran semua menentukan sama ada GPU terhad pada beban inference berterusan. Jika fasiliti anda tidak menyokong rak ketumpatan tinggi, nod 4U/4-GPU kuasa sederhana selalunya lebih dipercayai daripada raksasa 8-GPU teori yang terhad secara terma. Bunyi adalah kekangan terlupakan lain: modul kipas GPU belakang bising, jadi rancang penempatan jauh dari orang.
Pelayan ChangFan GPU: Platform Sistem Penuh untuk Inference AI
AI perindustrian adalah 70% beban kerja dan 30% perkakasan, tetapi 30% yang salah boleh menghapuskan 70%. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) mengilang pelayan GPU rackmount yang direka untuk inference berterusan: platform 4U menyokong sehingga 5 GPU dwi-lebar pada dual Intel Xeon Scalable (generasi 1-5) dengan memori DDR4/DDR5 ECC sehingga 4TB, varian soket tunggal AMD EPYC 7002/7003/8004 dengan 4 GPU dwi-lebar, dan casis 24 petak dengan NVMe pilihan untuk storan model. Setiap unit dilengkapi modul kipas GPU belakang khusus, bekalan kuasa sandar 1+1 atau 2+2, rangkaian Gigabit atas papan, pengembangan PCIe dan pengurusan jauh IPMI.
Jika anda menilai LLM persendirian, API inference atau flit ejen, hubungi ChangFan untuk cadangan konfigurasi sistem penuh yang disaiz mengikut saiz model x keserentakan x kuasa rak (perkakasan sahaja, tiada langganan perisian). Pemperibadian OEM/ODM disokong untuk integrator dan jenama.
Soalan Lazim (FAQ)
S1: Berapa banyak GPU yang diperlukan model 7B untuk inference?
A: Satu kad 24GB menjalankan model 7B dalam INT8; untuk FP16 dan keserentakan sederhana, satu kad 48GB atau dua kad 24GB memberi ruang selesa. Kekangan pertama ialah VRAM, bukan FLOPS.
S2: Patutkah saya menggunakan kad pengguna RTX atau GPU pusat data untuk inference?
A: Kad pengguna menang pada harga per GB untuk prototaip dan alat dalaman keserentakan rendah; GPU pusat data menang pada lebar jalur memori, NVLink, ECC dan kebolehpercayaan 24/7. Pilih mengikut SLA dan keserentakan, bukan FLOPS puncak.
S3: Adakah pelayan 4U 4-GPU mencukupi untuk model 70B?
A: Untuk perkhidmatan INT8 pada keserentakan sederhana, ya: 4x48GB (192GB) memuatkan model 70B INT8 plus KV-cache dengan selesa. Untuk FP16, keserentakan tinggi atau model 180B, beralih ke nod 8-GPU NVLink.
S4: Adakah VRAM lebih besar sentiasa bermakna inference lebih pantas?
A: Tidak. Token sesaat bergantung pada lebar jalur memori, saiz kelompok dan interkoneksi. Kapasiti tambahan menghalang OOM dan membolehkan kelompok lebih besar, tetapi lebar jalur dan topologi menentukan daya pemprosesan.
S5: Bolehkah saya menambah GPU ke pelayan 2U standard kemudian?
A: Biasanya tidak selamat: pelayan standard kekurangan pendawaian kuasa GPU, modul kipas belakang dan peruntukan lorong PCIe untuk kad dwi-lebar. Beli casis yang direka untuk GPU dari hari pertama.
- Artikel sebelumnya Pengukuhan AI Edge 2026: Dari Orin ke Thor, Bagaimana Changfan Mendasari "AI Fizikal" (Physical AI)
- Artikel seterusnya tiada lagi