2026'da LLM Çıkarımı için GPU Sunucusu Nasıl Seçilir: VRAM, Topoloji ve Soğutma
Giriş: AI faturası aslında çıkarımda kesiliyor
2026'da AI tartışması eğitimden çıkarıma kaydı. Sınır modelini eğitmek tek seferlik bir sermaye yatırımıdır; onu kullanıcılara sunmak kalıcı bir işletme maliyetidir. Tahminler AI sunucusu harcamalarını dik bir eğriye yerleştiriyor ve eğitim yerine çıkarıma ayrılan hesaplama payı artık konuşlandırılan GPU saatlerinin çoğunluğunu oluşturuyor. Çoğu şirket için pratik soru artık 'hangi GPU en hızlı' değil, 'hangi GPU sunucusu benim eşzamanlılığım, model boyutum ve raf güç bütçemde milyon token başına maliyeti düşük tutar'. Bu rehber bunu sayılarla yanıtlıyor.
LLM çıkarımı gerçekte neyi tüketir?
Kısa yanıt: çıkarım bellek bant genişliğiyle sınırlıdır, hesaplamayla değil. Her token üretmek model ağırlıklarını ve KV-cache'i GPU üzerinden akıtmak demektir; bu yüzden saniyedeki token sayısı ham TFLOPS'tan çok bellek bant genişliği ve parti boyutuyla ölçeklenir.
İki aşama önemlidir. Prefill tüm istemi paralel işler ve hesaplama yoğundur; decode çıktıyı token token üretir ve bant genişliği yoğundur. Bu nedenle uzun istemler ve uzun çıktılar farklı kaynakları zorlar. Bu yüzden muazzam TFLOPS'a ama küçük VRAM ve dar bant genişliğine sahip bir kart, gerçek sohbet yüklerinde daha fazla bant genişliğine sahip 'daha yavaş' bir karta yenilebilir. Sunucu boyutlandırırken VRAM kapasitesini, VRAM bant genişliğini ve NVLink/PCIe topolojisini birlikte izleyin; yalnızca veri sayfasındaki tepe FLOPS'a bakmayın.
7B, 13B, 70B ve 180B modeller için ne kadar VRAM gerekir?
Kısa yanıt: FP16'da parametre başına yaklaşık 2 bayt, INT8'de 1 bayt ve INT4'te 0,5 bayt hesaplayın, ardından KV-cache ve çalışma zamanı ek yükü için %15-30 ekleyin. INT8'de tek bir 70B model, partilemeden önce yaklaşık 80-100 GB gerektirir; yani en az 2x48GB veya 4x24GB kart.
KV-cache gizli maliyettir. Bağlam uzunluğu x eşzamanlı diziler x katmanlarla büyür; bu yüzden 4K bağlamda modeli sığdıran bir sunucu 32K'da veya yüksek eşzamanlılıkta belleği tüketebilir. VRAM'i p95 bağlam uzunluğu ve hedef eşzamanlılık için planlayın, demo istemi için değil. Genel kural olarak çıkarım için optimize edilmiş dağıtımlar %20-30 VRAM marjı bırakır; böylece zamanlayıcı OOM yeniden başlatmaları olmadan agresif partileyebilir.
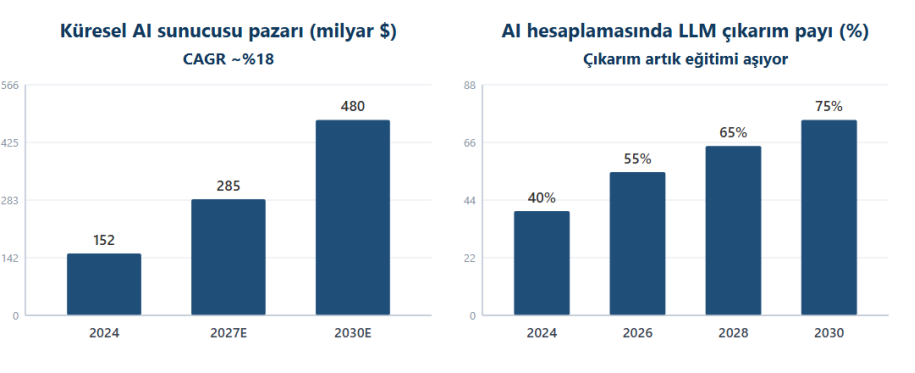
Şekil 1: AI sunucusu pazar büyüklüğü ve LLM çıkarımının artan payı (kaynaklar ekte)
4U çoklu GPU mu 8 GPU kasası mı? Topoloji, soğutma ve genişleme
Kısa yanıt: 4-5 çift genişlikli GPU'lu tek bir 4U sunucu çoğu özel LLM dağıtımı için en uygun noktadır; yalnızca bir model dörtten fazla GPU'ya yayılmalıysa veya düğüm başına maksimum verim gerekiyorsa 8 GPU NVLink platformuna geçin.
Topoloji, çoklu GPU çıkarımının ölçeklenip ölçeklenmeyeceğine karar verir. Yalnızca PCIe dağıtımı küçük modeller ve veri paralel sunum için yeterlidir, ancak 70B+ bir modelin tensör paralel sunumu yüksek bant genişlikli GPU-GPU bağlantıları (NVLink/NVSwitch) gerektirir; aksi halde ara bağlantı darboğaz olur. Termik, hayatta kalıp kalmayacağına karar verir: 4U içinde dört veya beş 350-700W çift genişlikli kart, özel arka GPU fan modülü ve önden arkaya hava akışı gerektirir. 3+1 veya 2+2 yedekli güç kaynakları planlayın ve rafın amperleri sağladığını doğrulayın.
▪ Tek GPU: 7B-13B prototipler ve düşük eşzamanlı dahili araçlar için en iyi.
▪ Tek 4U içinde 2-4 GPU: 32B-70B modeller için kapasite, yedeklilik ve güç dengesi en iyi.
▪ 8 GPU NVLink düğümü: 70B+ tensör paralel sunum, çok kiracılı API'ler veya ajan filoları için.
▪ Satın almadan önce her zaman PCIe hat tahsisini ve arka fan boşluğunu doğrulayın.
LLM çıkarım senaryoları ile GPU sunucusu yapılandırması (2026)
Aşağıdaki tablo tipik çıkarım yüklerini başlangıç donanım zarfına eşler. Bunu boyutlandırma temeli olarak alın, ardından kendi istem karışımınızda ölçülen saniyedeki token ile rafine edin.
Senaryo | Model ve eşzamanlılık | GPU yapılandırması | VRAM hedefi | Önerilen platform |
Prototip / tek geliştirici | 7B-13B, 1-3 kullanıcı | 1 çift genişlikli GPU | 24-48 GB | 1U/2U GPU istasyonu |
Ekip çıkarımı | 7B-32B, 5-20 kullanıcı | 1-2 çift genişlikli GPU | 48-96 GB | 2U GPU sunucusu |
Departman LLM | 70B (INT8), 20-50 kullanıcı | 2-4 GPU | 96-160 GB | 4U 4 GPU sunucusu |
Kurumsal sunum | 70B-180B, 50-200 kullanıcı | 4-8 GPU + NVLink | 160-640 GB | 4U/8 GPU NVLink düğümü |
Çok kiracılı / ajanlar | Herhangi, 200+ kullanıcı | 8 veri merkezi GPU | 640 GB+ | 8 GPU HGX / küme |
Tablo 1: LLM çıkarım yükleri ile GPU sunucusu yapılandırmaları (2026)
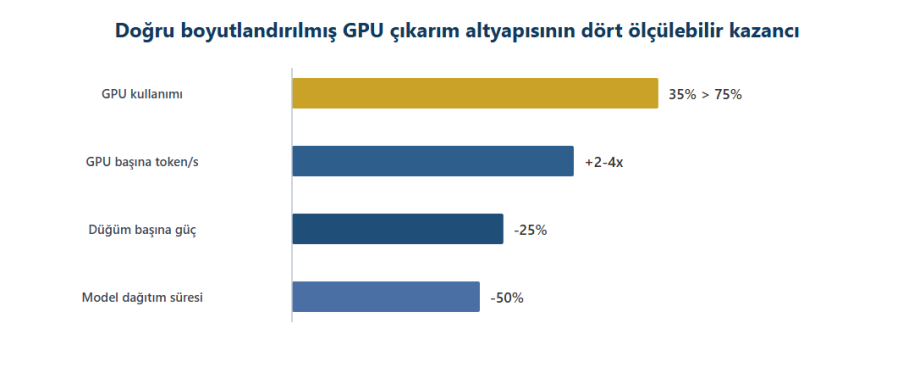
Şekil 2: doğru boyutlandırılmış GPU çıkarım altyapısının dört ölçülebilir kazancı (örnekleyici, kaynaklar ekte)
Güç, soğutma ve bütçelemeyi unuttuğunuz oda
Kısa yanıt: yoğun GPU sunucuları bir rafı ısıtıcıya çevirir. Dört adet 600W GPU artı CPU ve fanlarla bir 4U düğüm 3-4 kW çekebilir; 8 GPU düğümleri 8-10 kW'ı aşar. Donanım gelmeden önce PDU, devre ve soğutmanın bunu kaldırdığını doğrulayın.
Hava akışı yönü, sıcak koridor kapatma ve ortam sıcaklığı, GPU'ların sürekli çıkarım yükü altında kısıp kısmayacağını belirler. Tesisiniz yüksek yoğunluklu rafları desteklemiyorsa, ısıl olarak kısılan teorik bir 8 GPU canavarından orta güçte bir 4U/4 GPU düğümü genellikle daha güvenilirdir. Gürültü diğer unutulan kısıttır: arka GPU fan modülleri gürültülüdür, bu yüzden yerleşimi insanlardan uzağa planlayın.
ChangFan GPU Sunucuları: AI çıkarımı için tasarlanmış tam sistem platformu
Endüstriyel AI %70 iş yükü ve %30 donanımdır, ancak yanlış %30, %70'i sıfırlayabilir. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) sürekli çıkarım için tasarlanmış raf tipi GPU sunucuları üretir: çift Intel Xeon Scalable (1.-5. nesil) üzerinde 5 çift genişlikli GPU'ya kadar destekleyen, 4 TB'a kadar DDR4/DDR5 ECC belleğe sahip 4U platformlar, 4 çift genişlikli GPU'lu tek soket AMD EPYC 7002/7003/8004 varyantları ve model depolama için isteğe bağlı NVMe'li 24 yuvalı kasalar. Her ünite özel arka GPU fan modülü, 1+1 veya 2+2 yedekli güç, yerleşik Gigabit ağ, PCIe genişleme ve IPMI uzaktan yönetim ile gelir.
Özel bir LLM, çıkarım API'si veya ajan filosu değerlendiriyorsanız, model boyutu x eşzamanlılık x raf gücüne göre boyutlandırılmış tam sistem yapılandırma önerisi için ChangFan ile iletişime geçin (yalnızca donanım, yazılım aboneliği yok). Entegratörler ve markalar için OEM/ODM özelleştirmesi desteklenir.
Sıkça Sorulan Sorular (FAQ)
S1: Bir 7B model çıkarım için kaç GPU gerektirir?
C: Tek bir 24GB kart, 7B modeli INT8'de çalıştırır; FP16 ve orta eşzamanlılık için bir 48GB kart veya iki 24GB kart rahat marj sağlar. İlk kısıt VRAM'dir, FLOPS değil.
S2: Tüketici RTX kartları mı yoksa veri merkezi GPU'ları mı?
C: Tüketici kartları prototipler ve düşük eşzamanlı dahili araçlar için GB başına fiyatta kazanır; veri merkezi GPU'ları bellek bant genişliği, NVLink, ECC ve 7/24 güvenilirlikte kazanır. SLA ve eşzamanlılığa göre seçin, tepe FLOPS'a göre değil.
S3: 4U 4 GPU sunucu 70B model için yeterli mi?
C: Orta eşzamanlılıkta INT8 sunum için evet: 4x48GB (192GB) bir 70B INT8 modeli artı KV-cache'i rahatça barındırır. FP16, yüksek eşzamanlılık veya 180B modeller için 8 GPU NVLink düğümüne geçin.
S4: Daha fazla VRAM her zaman daha hızlı çıkarım demek mi?
C: Hayır. Saniyedeki token bellek bant genişliği, parti boyutu ve ara bağlantıya bağlıdır. Ek kapasite OOM'u önler ve daha büyük partilere izin verir, ancak verimi bant genişliği ve topoloji belirler.
S5: Standart bir 2U sunucuya sonradan GPU ekleyebilir miyim?
C: Genellikle güvenli değil: standart sunucularda GPU güç kablolaması, arka fan modülleri ve çift genişlikli kartlar için PCIe hat tahsisi yoktur. İlk günden GPU için tasarlanmış bir kasa satın alın.
- Önceki makale 2026 Edge AI Genişlemesi: Orin'den Thor'a, Changfan "Fiziksel Yapay Zeka" (Physical AI) için Hesaplama Temelini Nasıl Sağlamlaştırıyor?
- Sonraki makale başka yok