عنوان 1: 2026 میں LLM انفرنس کے لیے GPU سرور کیسے منتخب کریں: VRAM، ٹوپولوجی اور کولنگ
تعارف: انفرنس وہ جگہ ہے جہاں AI کا بل واقعی پہنچتا ہے
2026 میں AI کی گفتگو تربیت سے انفرنس کی طرف منتقل ہو گئی ہے۔ فرنٹیئر ماڈل کی تربیت ایک بار کی سرمایہ کاری ہے؛ اسے صارفین تک پہنچانا مستقل آپریٹنگ لاگت ہے۔ اندازے AI سرور کے اخراجات کو تیز چڑھتی ہوئی منحنی پر رکھتے ہیں، اور تربیت کے بجائے انفرنس پر خرچ ہونے والی کمپیوٹ کا حصہ اب تعینات GPU گھنٹوں کی اکثریت ہے۔ زیادہ تر کمپنیوں کے لیے عملی سوال اب یہ نہیں کہ ’کون سا GPU تیز ترین ہے‘ بلکہ یہ ہے کہ ’کون سا GPU سرور میری ہم وقتی، ماڈل سائز اور ریک پاور بجٹ پر فی ملین ٹوکن لاگت کم رکھتا ہے‘۔ یہ رہنما اعداد کے ساتھ جواب دیتی ہے۔
LLM انفرنس دراصل کیا خرچ کرتی ہے؟
مختصر جواب: انفرنس میموری بینڈوتھ سے محدود ہے، کمپیوٹ سے نہیں۔ ہر ٹوکن پیدا کرنے کا مطلب ماڈل کے وزن اور KV-cache کو GPU سے گزارنا ہے، اس لیے فی سیکنڈ ٹوکن میموری بینڈوتھ اور بیچ سائز کے ساتھ خام TFLOPS سے کہیں زیادہ بڑھتے ہیں۔
دو مراحل اہم ہیں۔ Prefill پورے پرامپٹ کو متوازی پراسیس کرتا ہے اور کمپیوٹ پر بھاری ہے؛ Decode آؤٹ پٹ ٹوکن بہ ٹوکن پیدا کرتا ہے اور بینڈوتھ پر بھاری ہے۔ اسی لیے لمبے پرامپٹ اور لمبے آؤٹ پٹ مختلف وسائل پر دباؤ ڈالتے ہیں۔ یہی وجہ ہے کہ بہت زیادہ TFLOPS مگر کم VRAM اور تنگ بینڈوتھ والا کارڈ حقیقی چیٹ بوجھ میں زیادہ بینڈوتھ والے ’سست‘ کارڈ سے ہار سکتا ہے۔ سرور کی پیمائش کرتے وقت VRAM گنجائش، VRAM بینڈوتھ اور NVLink/PCIe ٹوپولوجی کو اکٹھا دیکھیں، صرف اسپیک شیٹ کی چوٹی FLOPS نہیں۔
7B، 13B، 70B اور 180B ماڈلز کے لیے کتنی VRAM درکار ہے؟
مختصر جواب: FP16 میں تقریباً 2 بائٹ فی پیرامیٹر، INT8 میں 1 بائٹ اور INT4 میں 0.5 بائٹ شمار کریں، پھر KV-cache اور رن ٹائم اوور ہیڈ کے لیے 15-30% شامل کریں۔ INT8 میں ایک 70B ماڈل کو بیچنگ سے پہلے تقریباً 80-100 GB درکار ہوتے ہیں، یعنی کم از کم 2x48GB یا 4x24GB کارڈز۔
KV-cache پوشیدہ لاگت ہے۔ یہ سیاق کی لمبائی × بیک وقت ترتیبوں × تہوں کے ساتھ بڑھتا ہے، اس لیے 4K سیاق پر ماڈل رکھنے والا سرور 32K یا زیادہ ہم وقتی پر میموری سے محروم ہو سکتا ہے۔ VRAM کی منصوبہ بندی p95 سیاق کی لمبائی اور ہدف ہم وقتی کے لیے کریں، ڈیمو پرامپٹ کے لیے نہیں۔ عام قاعدہ: انفرنس کے لیے بہتر بنائی گئی تعیناتیاں 20-30% VRAM مارجن چھوڑتی ہیں تاکہ شیڈولر OOM ری اسٹارٹ کے بغیر جارحانہ بیچ کر سکے۔
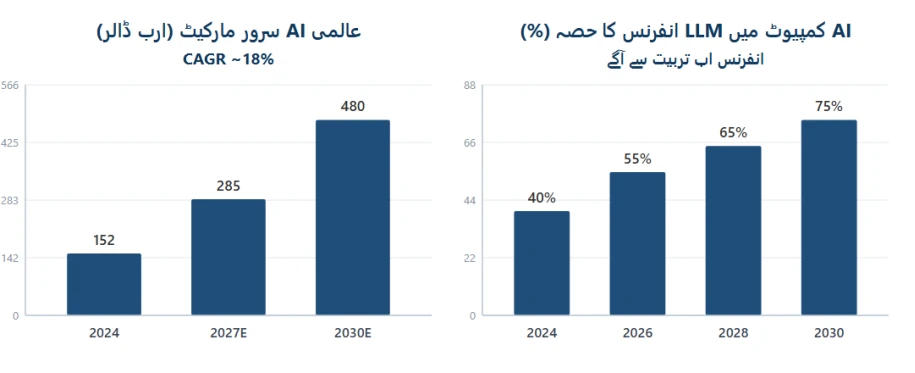
شکل 1: AI سرور مارکیٹ کا حجم اور LLM انفرنس کا بڑھتا حصہ (ذرائع ضمیمے میں)
4U ملٹی GPU یا 8 GPU چیسس؟ ٹوپولوجی، کولنگ اور توسیع
مختصر جواب: 4-5 ڈبل چوڑائی GPU والا ایک 4U سرور زیادہ تر نجی LLM تعیناتیوں کے لیے بہترین ہے؛ 8 GPU NVLink پلیٹ فارم پر صرف اس وقت جائیں جب ایک ماڈل کو چار سے زیادہ GPU پر پھیلنا ہو یا فی نوڈ زیادہ سے زیادہ تھروپٹ درکار ہو۔
ٹوپولوجی فیصلہ کرتی ہے کہ ملٹی GPU انفرنس اسکیل کرتی ہے یا نہیں۔ صرف PCIe تقسیم چھوٹے ماڈلز اور ڈیٹا متوازی سروس کے لیے کافی ہے، مگر 70B+ ماڈل کی ٹینسر متوازی سروس کے لیے تیز رفتار GPU-GPU روابط (NVLink/NVSwitch) درکار ہیں، ورنہ انٹرکنیکٹ رکاوٹ بن جاتا ہے۔ تھرمل فیصلہ کرتا ہے کہ یہ زندہ رہے گا: 4U میں چار یا پانچ 350-700W ڈبل چوڑائی کارڈز کے لیے مخصوص عقبی GPU فین ماڈیول اور سامنے سے پیچھے ہوا کا بہاؤ ضروری ہے۔ 3+1 یا 2+2 ریڈنڈنٹ پاور سوپلائیز کا منصوبہ بنائیں اور تصدیق کریں کہ ریک مطلوبہ ایمپیئر فراہم کرتا ہے۔
▪ ایک GPU: 7B-13B پروٹوٹائپس اور کم ہم وقتی داخلی ٹولز کے لیے بہترین۔
▪ ایک 4U میں 2-4 GPU: 32B-70B ماڈلز کے لیے گنجائش، ریڈنڈنسی اور پاور کا بہترین توازن۔
▪ 8 GPU NVLink نوڈ: 70B+ ٹینسر متوازی سروس، ملٹی ٹیننٹ APIs یا ایجنٹ بیڑے کے لیے۔
▪ خریداری سے پہلے ہمیشہ PCIe لین کی تقسیم اور عقبی فین کی جگہ کی تصدیق کریں۔
LLM انفرنس منظرنامے بمقابلہ GPU سرور کنفیگریشن (2026)
نیچے دیا گیا جدول عام انفرنس بوجھ کو ابتدائی ہارڈ ویئر لفافے سے جوڑتا ہے۔ اسے پیمائش کی بنیاد سمجھیں، پھر اپنے پرامپٹ مکس پر ناپے گئے فی سیکنڈ ٹوکن سے بہتر کریں۔
منظرنامہ | ماڈل اور ہم وقتی | GPU کنفیگریشن | VRAM ہدف | تجویز کردہ پلیٹ فارم |
پروٹوٹائپ / واحد ڈویلپر | 7B-13B، 1-3 صارفین | 1 ڈبل چوڑائی GPU | 24-48 GB | 1U/2U GPU ورک اسٹیشن |
ٹیم انفرنس | 7B-32B، 5-20 صارفین | 1-2 ڈبل چوڑائی GPU | 48-96 GB | 2U GPU سرور |
محکمانہ LLM | 70B (INT8)، 20-50 صارفین | 2-4 GPU | 96-160 GB | 4U 4-GPU سرور |
انٹرپرائز سروس | 70B-180B، 50-200 صارفین | 4-8 GPU + NVLink | 160-640 GB | 4U/8 GPU NVLink نوڈ |
ملٹی ٹیننٹ / ایجنٹس | کوئی بھی، 200+ صارفین | 8 ڈیٹا سینٹر GPU | 640 GB+ | 8 GPU HGX / کلسٹر |
جدول 1: LLM انفرنس بوجھ بمقابلہ GPU سرور کنفیگریشنز (2026)
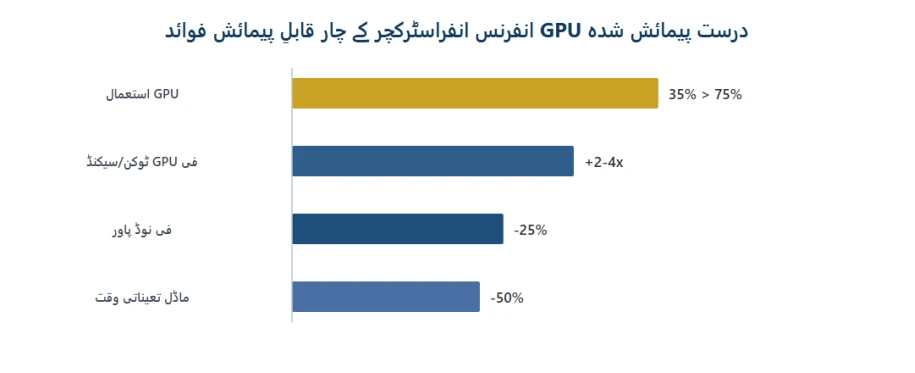
شکل 2: درست پیمائش شدہ GPU انفرنس انفراسٹرکچر کے چار قابلِ پیمائش فوائد (وضاحتی، ذرائع ضمیمے میں)
پاور، کولنگ اور وہ کمرہ جس کا بجٹ آپ بھول گئے
مختصر جواب: گھنے GPU سرور ریک کو ہیٹر بنا دیتے ہیں۔ چار 600W GPU کے ساتھ 4U نوڈ، CPUs اور فینز سمیت، 3-4 kW کھینچ سکتا ہے؛ 8 GPU نوڈز 8-10 kW سے تجاوز کرتے ہیں۔ ہارڈ ویئر آنے سے پہلے تصدیق کریں کہ آپ کا PDU، سرکٹ اور کولنگ اسے سنبھال سکتے ہیں۔
ہوا کے بہاؤ کی سمت، گرم راہداریوں کی باڑ اور محیطی درجہ حرارت طے کرتے ہیں کہ GPU مسلسل انفرنس بوجھ میں تھروٹل ہوں گے یا نہیں۔ اگر آپ کی سہولت زیادہ کثافت والے ریک نہیں سنبھال سکتی تو معتدل پاور کا 4U/4 GPU نوڈ اکثر نظریاتی 8 GPU عفریت سے زیادہ قابلِ بھروسہ ہوتا ہے جو تھرمل طور پر تھروٹل ہوتا ہے۔ شور دوسری بھولی ہوئی قید ہے: عقبی GPU فین ماڈیولز شور مچاتے ہیں، اس لیے جگہ لوگوں سے دور رکھیں۔
ChangFan GPU سرورز: AI انفرنس کے لیے بنایا گیا مکمل نظام پلیٹ فارم
صنعتی AI 70% بوجھ اور 30% ہارڈ ویئر ہے، مگر غلط 30% 70% کو صفر کر سکتا ہے۔ Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) مسلسل انفرنس کے لیے ریک ماؤنٹ GPU سرورز بناتی ہے: 4U پلیٹ فارمز جو دو Intel Xeon Scalable (1-5 جنریشن) پر 5 ڈبل چوڑائی GPU تک، 4TB DDR4/DDR5 ECC میموری تک، سنگل ساکٹ AMD EPYC 7002/7003/8004 ورژنز 4 ڈبل چوڑائی GPU کے ساتھ، اور 24 بے چیسس اختیاری NVMe کے ساتھ ماڈل اسٹوریج کے لیے۔ ہر یونٹ مخصوص عقبی GPU فین ماڈیول، 1+1 یا 2+2 ریڈنڈنٹ پاور، آن بورڈ Gigabit نیٹ ورکنگ، PCIe توسیع اور IPMI ریموٹ مینجمنٹ کے ساتھ آتا ہے۔
اگر آپ نجی LLM، انفرنس API یا ایجنٹ بیڑے کا جائزہ لے رہے ہیں تو ChangFan سے رابطہ کریں تاکہ ماڈل سائز × ہم وقتی × ریک پاور کے مطابق مکمل نظام کنفیگریشن کی تجویز حاصل کریں (صرف ہارڈ ویئر، سافٹ ویئر سبسکرپشن کے بغیر)۔ انٹیگریٹرز اور برانڈز کے لیے OEM/ODM حسبِ ضرورت دستیاب ہے۔
عمومی سوالات (FAQ)
س1: 7B ماڈل کو انفرنس کے لیے کتنے GPU درکار ہیں؟
ج: ایک 24GB کارڈ INT8 میں 7B ماڈل چلاتا ہے؛ FP16 اور معتدل ہم وقتی کے لیے ایک 48GB کارڈ یا دو 24GB کارڈز آرام دہ مارجن دیتے ہیں۔ پہلی قید VRAM ہے، FLOPS نہیں۔
س2: کنزیومر RTX کارڈز یا ڈیٹا سینٹر GPU استعمال کروں؟
ج: کنزیومر کارڈز پروٹوٹائپس اور کم ہم وقتی داخلی ٹولز کے لیے فی GB قیمت میں بہتر ہیں؛ ڈیٹا سینٹر GPU میموری بینڈوتھ، NVLink، ECC اور 24/7 بھروسے میں بہتر ہیں۔ SLA اور ہم وقتی کی بنیاد پر انتخاب کریں، چوٹی FLOPS کی نہیں۔
س3: کیا 4U 4-GPU سرور 70B ماڈل کے لیے کافی ہے؟
ج: معتدل ہم وقتی پر INT8 سروس کے لیے ہاں: 4x48GB (192GB) 70B INT8 ماڈل اور KV-cache آرام سے رکھتے ہیں۔ FP16، زیادہ ہم وقتی یا 180B ماڈلز کے لیے 8 GPU NVLink نوڈ پر جائیں۔
س4: کیا زیادہ VRAM کا مطلب ہمیشہ تیز انفرنس ہے؟
ج: نہیں۔ فی سیکنڈ ٹوکن میموری بینڈوتھ، بیچ سائز اور انٹرکنیکٹ پر منحصر ہیں۔ زیادہ گنجائش OOM روکتی ہے اور بڑے بیچز ممکن بناتی ہے، مگر تھروپٹ بینڈوتھ اور ٹوپولوجی طے کرتے ہیں۔
س5: کیا بعد میں معیاری 2U سرور میں GPU شامل کر سکتا ہوں؟
ج: عام طور پر محفوظ طریقے سے نہیں: معیاری سرورز میں GPU پاور کیبلنگ، عقبی فین ماڈیولز اور ڈبل چوڑائی کارڈز کے لیے PCIe لین تقسیم نہیں ہوتی۔ پہلے دن سے GPU کے لیے بنایا گیا چیسس خریدیں۔
- پچھلا مضمون مرکزی عنوان: 2026 میں ایج AI کی توسیع: Orin سے Thor تک، Changfan "فزیکل AI" (Physical AI) کے لیے کمپیوٹنگ کی بنیاد کیسے محفوظ کرتا ہے
- اگلا مضمون کچھ باقی نہیں ہے