2026 में LLM इन्फरेंस के लिए GPU सर्वर कैसे चुनें: VRAM, टोपोलॉजी और कूलिंग
प्रस्तावना: इन्फरेंस वहीं है जहाँ AI का बिल वास्तव में आता है
2026 में AI की बातचीत ट्रेनिंग से इन्फरेंस की ओर खिसक गई है। किसी फ्रंटियर मॉडल को ट्रेन करना एकमुश्त पूंजीगत खर्च है; उसे उपयोगकर्ताओं को देना स्थायी परिचालन लागत है। उद्योग के अनुमान AI सर्वर खर्च को एक तेज़ वक्र पर रखते हैं, और ट्रेनिंग के बजाय इन्फरेंस को दी जाने वाली कंप्यूट का हिस्सा अब तैनात GPU घंटों का बहुमत है। अधिकांश कंपनियों के लिए व्यावहारिक सवाल अब 'कौन सा GPU सबसे तेज़ है' नहीं बल्कि 'मेरी कंकरेंसी, मॉडल साइज़ और रैक पावर बजट पर कौन सा GPU सर्वर प्रति मिलियन टोकन लागत कम रखता है' है। यह गाइड नंबरों से जवाब देती है।
LLM इन्फरेंस वास्तव में क्या खपता है?
त्वरित उत्तर: इन्फरेंस मेमोरी-बैंडविड्थ प्रतिबंधित है, कंप्यूट प्रतिबंधित नहीं। हर टोकन जेनरेट करने का मतलब मॉडल के वेट्स और KV-कैश को GPU से स्ट्रीम करना है, इसलिए प्रति सेकंड टोकन्स शुद्ध TFLOPS से कहीं अधिक मेमोरी बैंडविड्थ और बैच साइज़ पर निर्भर करते हैं।
दो चरण मायने रखते हैं। Prefill पूरी प्रॉम्प्ट को समानांतर संसाधित करता है और कंप्यूट-भारी होता है; decode आउटपुट को टोकन दर टोकन जेनरेट करता है और मेमोरी-बैंडविड्थ-भारी होता है। इसलिए लंबी प्रॉम्प्ट्स और लंबे आउटपुट अलग-अलग संसाधनों पर बोझ डालते हैं। यही कारण है कि विशाल TFLOPS वाला परंतु छोटे VRAM और संकरी बैंडविड्थ वाला कार्ड वास्तविक चैट लोड पर अधिक मेमोरी बैंडविड्थ वाले 'धीमे' कार्ड से हार सकता है। सर्वर साइज़ करते समय, स्पेसिफिकेशन शीट के पीक FLOPS को अकेले न देखें बल्कि VRAM क्षमता, VRAM बैंडविड्थ और NVLink/PCIe टोपोलॉजी को साथ में देखें।
7B, 13B, 70B और 180B मॉडल्स के लिए कितना VRAM चाहिए?
त्वरित उत्तर: FP16 में प्रति पैरामीटर लगभग 2 बाइट्स, INT8 में 1 बाइट और INT4 में 0.5 बाइट रखें, फिर KV-कैश और रनटाइम ओवरहेड के लिए 15-30% जोड़ें। बैचिंग से पहले एकल 70B मॉडल INT8 में लगभग 80-100 GB चाहता है, यानी कम से कम 2x48GB या 4x24GB कार्ड।
KV-कैश छिपी हुई लागत है। यह कॉन्टेक्स्ट लंबाई x कंकरेंट सीक्वेंसेस x लेयर्स के साथ बढ़ती है, इसलिए 4K कॉन्टेक्स्ट पर मॉडल समाने वाला सर्वर 32K या उच्च कंकरेंसी पर मेमोरी समाप्त कर सकता है। डेमो प्रॉम्प्ट के बजाय p95 कॉन्टेक्स्ट लंबाई और लक्ष्य कंकरेंसी के लिए VRAM प्लान करें। एक नियम के रूप में, इन्फरेंस-अनुकूलित डिप्लॉयमेंट्स OOM रीस्टार्ट के बिना आक्रामक बैचिंग के लिए VRAM का 20-30% हेडरूम छोड़ते हैं।
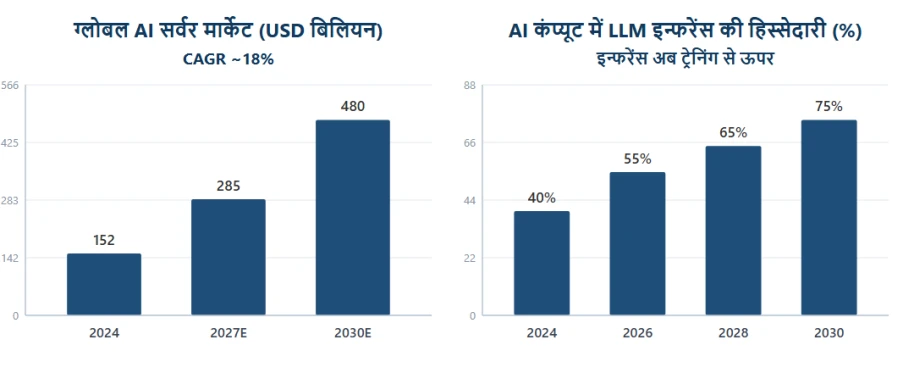
चित्र 1: AI सर्वर मार्केट साइज़ और LLM इन्फरेंस की बढ़ती हिस्सेदारी (स्रोत परिशिष्ट में)
4U मल्टी-GPU या 8-GPU चेसिस? टोपोलॉजी, कूलिंग और एक्सपेंशन
त्वरित उत्तर: अधिकांश प्राइवेट LLM डिप्लॉयमेंट्स के लिए 4-5 डुअल-विड्थ GPU वाला एकल 4U सर्वर मीठा बिंदु है; तभी 8-GPU NVLink प्लेटफ़ॉर्म पर जाएँ जब एक मॉडल को चार से अधिक GPU पर फैलना हो या प्रति नोड अधिकतम थ्रूपुट चाहिए।
टोपोलॉजी तय करती है कि मल्टी-GPU इन्फरेंस स्केल करता है या नहीं। केवल PCIe फैन-आउट छोटे मॉडल्स और डेटा-पैरलल सर्विंग के लिए ठीक है, पर 70B+ मॉडल की टेंसर-पैरलल सर्विंग को GPU-से-GPU हाई-बैंडविड्थ लिंक्स (NVLink/NVSwitch) चाहिए, अन्यथा इंटरकनेक्ट बॉटलनेक बन जाता है। थर्मल्स तय करते हैं कि यह बचता है या नहीं: 4U में 350-700W डुअल-विड्थ कार्ड्स के 4-5 नग को समर्पित रियर GPU फैन मॉड्यूल और आगे-से-पीछे एयरफ्लो चाहिए। 3+1 या 2+2 रिडंडेंट पावर सप्लाई प्लान करें और पुष्टि करें कि रैक एम्पियर दे सके।
▪ सिंगल GPU: 7B-13B प्रोटोटाइप और कम कंकरेंसी वाले आंतरिक टूल्स के लिए सर्वश्रेष्ठ।
▪ एक 4U में 2-4 GPU: 32B-70B मॉडल्स के लिए क्षमता, रिडंडेंसी और पावर का सबसे अच्छा संतुलन।
▪ 8-GPU NVLink नोड: 70B+ टेंसर-पैरलल सर्विंग, मल्टी-टेनेंट API, या एजेंट फ्लीट्स के लिए।
▪ खरीदने से पहले हमेशा PCIe लेन आवंटन और रियर फैन क्लियरेंस जांचें।
LLM इन्फरेंस परिदृश्य बनाम GPU सर्वर कॉन्फ़िगरेशन (2026)
नीचे दी गई तालिका विशिष्ट इन्फरेंस वर्कलोड्स को एक प्रारंभिक हार्डवेयर एनवेलप से मैप करती है। इसे साइज़िंग बेसलाइन मानें, फिर अपने प्रॉम्प्ट मिक्स पर मापे गए प्रति सेकंद टोकन्स से रिफाइन करें।
परिदृश्य | मॉडल और कंकरेंसी | GPU कॉन्फ़िगरेशन | VRAM लक्ष्य | अनुशंसित प्लेटफ़ॉर्म |
प्रोटोटाइप / एक डेवलपर | 7B-13B, 1-3 उपयोगकर्ता | 1x डुअल-विड्थ GPU | 24-48 GB | 1U/2U GPU वर्कस्टेशन |
टीम इन्फरेंस | 7B-32B, 5-20 उपयोगकर्ता | 1-2x डुअल-विड्थ GPU | 48-96 GB | 2U GPU सर्वर |
डिपार्टमेंट LLM | 70B (INT8), 20-50 उपयोगकर्ता | 2-4x GPU | 96-160 GB | 4U 4-GPU सर्वर |
एंटरप्राइज़ सर्विंग | 70B-180B, 50-200 उपयोगकर्ता | 4-8x GPU + NVLink | 160-640 GB | 4U/8-GPU NVLink नोड |
मल्टी-टेनेंट / एजेंट्स | कोई भी, 200+ उपयोगकर्ता | 8x डेटासेंटर GPU | 640 GB+ | 8-GPU HGX / क्लस्टर |
तालिका 1: LLM इन्फरेंस वर्कलोड बनाम GPU सर्वर कॉन्फ़िगरेशन्स (2026)
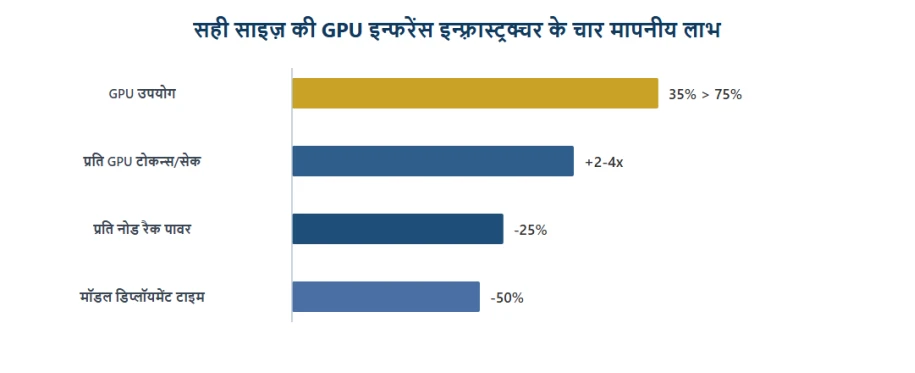
चित्र 2: सही साइज़ की GPU इन्फरेंस इन्फ़्रास्ट्रक्चर के चार मापनीय लाभ (उदाहरणात्मक, स्रोत परिशिष्ट में)
पावर, कूलिंग और वह कमरा जिसका बजट आप भूल गए
त्वरित उत्तर: घने GPU सर्वर रैक को हीटर बना देते हैं। चार 600W GPU, CPU और फैन्स वाला 4U नोड 3-4 kW खींच सकता है; आठ-GPU नोड्स 8-10 kW पार कर जाते हैं। हार्डवेयर आने से पहले पुष्टि करें कि PDU, सर्किट और कूलिंग इसे झेल लें।
एयरफ्लो दिशा, हॉट-ऐसल कंटेनमेंट और एंबिएंट तापमान सभी यह तय करते हैं कि स्थायी इन्फरेंस लोड के तहत GPU थ्रॉटल होंगे या नहीं। यदि आपकी सुविधा हाई-डेंसिटी रैक सपोर्ट नहीं करती, तो थर्मली थ्रॉटल होने वाले सैद्धांतिक 8-GPU मॉन्स्टर से 4U/4-GPU मॉडरेट-पावर नोड अक्सर अधिक भरोसेमंद होता है। शोर एक और भुलाई गई सीमा है: रियर GPU फैन मॉड्यूल्स शोरगुल करते हैं, इसलिए लोगों से दूर रखें।
ChangFan GPU सर्वर्स: AI इन्फरेंस के लिए बनाया गया होल-सिस्टम प्लेटफ़ॉर्म
इंडस्ट्रियल AI 70% वर्कलोड और 30% हार्डवेयर है, पर गलत 30% 70% को मिटा सकता है। Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) स्थायी इन्फरेंस के लिए डिज़ाइन किए गए रैकमाउंट GPU सर्वर्स बनाता है: डुअल Intel Xeon Scalable (1st-5th Gen) पर 5 तक डुअल-विड्थ GPU सपोर्ट करने वाले 4U प्लेटफ़ॉर्म, 4TB तक DDR4/DDR5 ECC मेमोरी, सिंगल-सॉकेट AMD EPYC 7002/7003/8004 वैरिएंट्स 4 डुअल-विड्थ GPU के साथ, और ऑप्शनल NVMe मॉडल स्टोरेज वाले 24-बे चेसिस। हर यूनिट में समर्पित रियर GPU फैन मॉड्यूल, 1+1 या 2+2 रिडंडेंट पावर, ऑनबोर्ड Gigabit नेटवर्किंग, PCIe एक्सपेंशन और IPMI रिमोट मैनेजमेंट आता है।
यदि आप प्राइवेट LLM, इन्फरेंस API, या एजेंट फ्लीट का मूल्यांकन कर रहे हैं, तो मॉडल साइज़ × कंकरेंसी × रैक पावर से साइज़ की गई होल-सिस्टम कॉन्फ़िगरेशन सिफ़ारिश के लिए ChangFan से संपर्क करें (केवल हार्डवेयर, कोई सॉफ़्टवेयर सब्सक्रिप्शन नहीं)। इंटिग्रेटर्स और ब्रांड्स के लिए OEM/ODM कस्टमाइज़ेशन सपोर्टेड है।
अक्सर पूछे जाने वाले सवाल (FAQ)
Q1: 7B मॉडल के इन्फरेंस के लिए कितने GPU चाहिए?
A: एक 24GB कार्ड 7B मॉडल को INT8 में चला लेता है; FP16 और मध्यम कंकरेंसी के लिए एक 48GB कार्ड या दो 24GB कार्ड आरामदायक हेडरूम देते हैं। पहली सीमा FLOPS नहीं, VRAM है।
Q2: इन्फरेंस के लिए कंज़्यूमर RTX कार्ड या डेटासेंटर GPU इस्तेमाल करूँ?
A: कंज़्यूमर कार्ड्स प्रोटोटाइप और कम कंकरेंसी वाले आंतरिक टूल्स में प्रति GB कीमत में जीतते हैं; डेटासेंटर GPU मेमोरी बैंडविड्थ, NVLink, ECC और 24/7 रिलायबिलिटी में जीतते हैं। पीक FLOPS के बजाय SLA और कंकरेंसी से चुनें।
Q3: क्या 4U 4-GPU सर्वर 70B मॉडल के लिए काफ़ी है?
A: मध्यम कंकरेंसी वाली INT8 सर्विंग के लिए हाँ: 4×48GB (192GB) एक 70B INT8 मॉडल + KV-कैश आराम से समाता है। FP16, उच्च कंकरेंसी, या 180B मॉडल्स के लिए 8-GPU NVLink नोड पर जाएँ।
Q4: क्या ज़्यादा VRAM हमेशा तेज़ इन्फरेंस मतलब है?
A: नहीं। प्रति सेकंद टोकन्स मेमोरी बैंडविड्थ, बैच साइज़ और इंटरकनेक्ट पर निर्भर करते हैं। अतिरिक्त क्षमता OOM रोकती है और बड़े बैच सक्षम करती है, पर थ्रूपुट बैंडविड्थ और टोपोलॉजी तय करते हैं।
Q5: क्या बाद में स्टैंडर्ड 2U सर्वर में GPU जोड़ सकता हूँ?
A: आमतौर पर सुरक्षित नहीं: स्टैंडर्ड सर्वर्स में डुअल-विड्थ कार्ड्स के लिए GPU पावर केबलिंग, रियर फैन मॉड्यूल और PCIe लेन आवंटन नहीं होता। पहले दिन से GPU के लिए डिज़ाइन किया चेसिस खरीदें।
- पिछला लेख 2026 में एज AI का विस्तार: Orin से Thor तक, Changfan "फिजिकल AI" (Physical AI) के लिए कंप्यूटिंग की नींव कैसे सुरक्षित करता है
- अगला लेख कुछ नहीं बचा