Πώς να επιλέξετε έναν διακομιστή GPU για συμπερασμό LLM το 2026: VRAM, τοπολογία και ψύξη
Εισαγωγή: Ο συμπερασμός είναι εκεί που προσγειώνεται πραγματικά ο λογαριασμός AI
Το 2026 η συζήτηση για την AI μετακινήθηκε από την εκπαίδευση στον συμπερασμό. Η εκπαίδευση ενός πρωτοποριακού μοντέλου είναι ένα μονομερές κεφαλαιακό γεγονός· η εξυπηρέτησή του στους χρήστες είναι μόνιμο λειτουργικό κόστος. Οι εκτιμήσεις της βιομηχανίας θέτουν τις δαπάνες για διακομιστές AI σε απότομη καμπύλη και το μερίδιο των υπολογισμών που αφιερώνονται στον συμπερασμό αντί για την εκπαίδευση αποτελεί πλέον την πλειοψηφία των αναπτυγμένων ωρών GPU. Για τις περισσότερες εταιρείες το πρακτικό ερώτημα δεν είναι πλέον «ποιο GPU είναι ταχύτερο» αλλά «ποιος διακομιστής GPU διατηρεί χαμηλό το κόστος ανά εκατομμύριο tokens στο δικό μου επίπεδο ταυτόχρονης λειτουργίας, μέγεθος μοντέλου και προϋπολογισμό ισχύος rack». Αυτός ο οδηγός απαντά με αριθμούς.
Τι καταναλώνει πραγματικά ο συμπερασμός LLM;
Γρήγορη απάντηση: ο συμπερασμός περιορίζεται από το εύρος ζώνης μνήμης, όχι από τον υπολογισμό. Η δημιουργία κάθε token σημαίνει ροή των βαρών του μοντέλου και της KV-κρυφής μνήμης μέσω της GPU, οπότε τα tokens ανά δευτερόλεπτο κλιμακώνονται πολύ περισσότερο με το εύρος ζώνης μνήμης και το μέγεθος δέσμης παρά με τα ωμά TFLOPS.
Δύο φάσεις έχουν σημασία. Το Prefill επεξεργάζεται ολόκληρη την προτροπή παράλληλα και είναι υπολογιστικά βαριά· το decode παράγει την έξοδο token προς token και είναι βαριά σε εύρος ζώνης μνήμης. Γι' αυτό μακριές προτροπές και μακριές έξοδοι πιέζουν διαφορετικούς πόρους. Γι' αυτό μια κάρτα με τεράστια TFLOPS αλλά μικρό VRAM και στενό εύρος ζώνης μπορεί να χάσει από μια «πιο αργή» κάρτα με μεγαλύτερο εύρος ζώνης μνήμης σε πραγματικά φορτία συνομιλίας. Κατά τον καθορισμό μεγέθους του διακομιστή, δείτε μαζί χωρητικότητα VRAM, εύρος ζώνης VRAM και τοπολογία NVLink/PCIe, όχι μόνο τα κορυφαία FLOPS του φύλλου προδιαγραφών.
Πόσο VRAM χρειάζεστε για μοντέλα 7B, 13B, 70B και 180B;
Γρήγορη απάντηση: υπολογίστε περίπου 2 bytes ανά παράμετρο σε FP16, 1 byte σε INT8 και 0,5 byte σε INT4, και προσθέστε 15-30% για την KV-κρυφή μνήμη και το κόστος εκτέλεσης. Ένα μόνο μοντέλο 70B σε INT8 χρειάζεται περίπου 80-100 GB πριν από τη δέσμευση, δηλαδή τουλάχιστον κάρτες 2×48 GB ή 4×24 GB.
Η KV-κρυφή μνήμη είναι το κρυφό κόστος. Αυξάνεται με το μήκος περιβάλλοντος × ταυτόχρονες ακολουθίες × στρώματα, οπότε ένας διακομιστής που χωράει ένα μοντέλο σε περιβάλλον 4K μπορεί να μείνει από μνήμη σε 32K ή σε υψηλή ταυτόχρονη λειτουργία. Σχεδιάστε το VRAM για το μήκος περιβάλλοντος p95 και την ταυτόχρονη λειτουργία-στόχο, όχι για την προτροπή επίδειξης. Ως κανόνας, οι αναπτύξεις βελτιστοποιημένες για συμπερασμό αφήνουν περιθώριο 20-30% VRAM ώστε ο προγραμματιστής να δεσμεύει επιθετικά δέσμες χωρίς επανεκκινήσεις λόγω έλλειψης μνήμης.
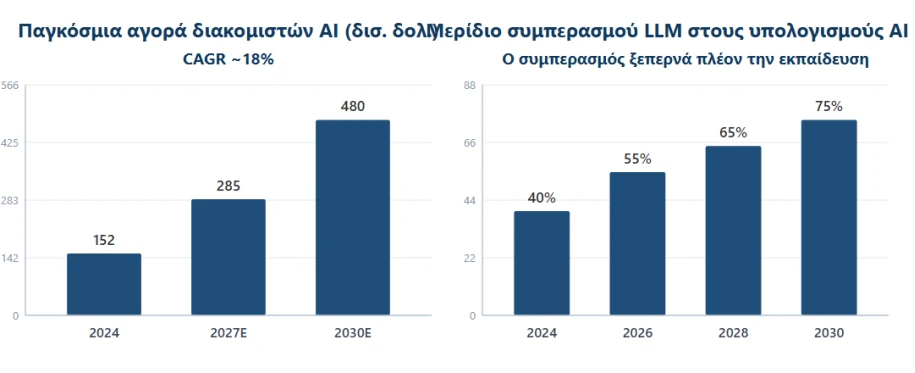
Σχήμα 1: Μέγεθος αγοράς διακομιστών AI και η ανοδική μερίδα του συμπερασμού LLM (πηγές στο παράρτημα)
4U πολλαπλών GPU ή πλαίσιο 8 GPU; Τοπολογία, ψύξη και επέκταση
Γρήγορη απάντηση: ένας μοναδικός διακομιστής 4U με 4-5 GPU διπλού πλάτους είναι το ιδανικό σημείο για τις περισσότερες ιδιωτικές αναπτύξεις LLM· περάστε σε πλατφόρμα 8 GPU NVLink μόνο όταν ένα μοντέλο πρέπει να εκτείνεται σε περισσότερες από τέσσερις GPU ή χρειάζεστε μέγιστη απόδοση ανά κόμβο.
Η τοπολογία αποφασίζει αν ο συμπερασμός πολλαπλών GPU κλιμακώνεται. Η διασπορά μόνο μέσω PCIe αρκεί για μικρά μοντέλα και εξυπηρέτηση με παραλληλισμό δεδομένων, αλλά η εξυπηρέτηση tensor-parallel ενός μοντέλου 70B+ απαιτεί συνδέσεις GPU-GPU υψηλού εύρους (NVLink/NVSwitch), αλλιώς ο διασυνδετής γίνεται σημείο συμφόρησης. Η θερμική διαχείριση αποφασίζει αν επιβιώνει: τέσσερις ή πέντε κάρτες διπλού πλάτους 350-700W σε 4U απαιτούν αφιερωμένη μονάδα ανεμιστήρων GPU στο πίσω μέρος και ροή αέρα από εμπρός προς τα πίσω. Σχεδιάστε πλεονάζοντα τροφοδοτικά 3+1 ή 2+2 και επιβεβαιώστε ότι το rack δίνει τους αμπέρ.
▪ Μονή GPU: καλύτερη για πρωτότυπα 7B-13B και εσωτερικά εργαλεία χαμηλής ταυτόχρονης λειτουργίας.
▪ 2-4 GPU σε ένα 4U: η καλύτερη ισορροπία χωρητικότητας, πλεονασμού και ισχύος για μοντέλα 32B-70B.
▪ Κόμβος 8 GPU NVLink: για εξυπηρέτηση tensor-parallel 70B+, API πολλαπλών μισθωτών ή στόλους πρακτόρων.
▪ Επαληθεύετε πάντα την κατανομή λωρίδων PCIe και τον καθαρισμό ανεμιστήρα πίσω μέρους πριν την αγορά.
Σενάρια συμπερασμού LLM έναντι διαμόρφωσης διακομιστή GPU (2026)
Ο παρακάτω πίνακας αντιστοιχίζει τυπικά φορτία συμπερασμού σε ένα αρχικό περίβλημα υλικού. Χρησιμοποιήστε τον ως βάση μεγέθους και μετά βελτιστοποιήστε με τα μετρημένα tokens ανά δευτερόλεπτο στο δικό σας μίγμα προτροπών.
Σενάριο | Μοντέλο και ταυτόχρονη | Διαμόρφωση GPU | Στόχος VRAM | Προτεινόμενη πλατφόρμα |
Πρωτότυπο / μοναδικός προγραμματιστής | 7B-13B, 1-3 χρήστες | 1 GPU διπλού πλάτους | 24-48 GB | Σταθμός εργασίας GPU 1U/2U |
Συμπερασμός ομάδας | 7B-32B, 5-20 χρήστες | 1-2 GPU διπλού πλάτους | 48-96 GB | Διακομιστής GPU 2U |
LLM τμήματος | 70B (INT8), 20-50 χρήστες | 2-4 GPU | 96-160 GB | Διακομιστής 4U 4-GPU |
Επιχειρησιακή εξυπηρέτηση | 70B-180B, 50-200 χρήστες | 4-8 GPU + NVLink | 160-640 GB | Κόμβος 4U/8-GPU NVLink |
Πολλαπλών μισθωτών / πρακτόρων | Οποιοδήποτε, 200+ χρήστες | 8 GPU κέντρου δεδομένων | 640 GB+ | 8-GPU HGX / συμπλέγμα |
Πίνακας 1: Φορτία συμπερασμού LLM έναντι διαμορφώσεων διακομιστή GPU (2026)
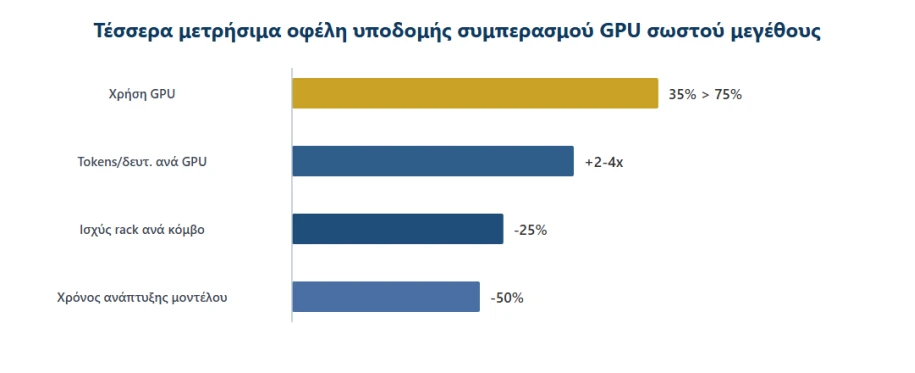
Σχήμα 2: Τέσσερα μετρήσιμα οφέλη υποδομής συμπερασμού GPU σωστού μεγέθους (εικονιστικό, πηγές στο παράρτημα)
Ισχύς, ψύξη και ο χώρος που ξεχάσατε να προϋπολογίσετε
Γρήγορη απάντηση: οι πυκνοί διακομιστές GPU μετατρέπουν το rack σε θερμάστρα. Ένας κόμβος 4U με τέσσερις GPU των 600W συν CPU και ανεμιστήρες μπορεί να καταναλώνει 3-4 kW· οι κόμβοι 8 GPU ξεπερνούν τα 8-10 kW. Επιβεβαιώστε ότι το PDU, το κύκλωμα και η ψύξη αντέχουν πριν φτάσει ο εξοπλισμός.
Η κατεύθυνση ροής αέρα, ο απομονωτής ζεστού διαδρόμου και η περιβάλλουσα θερμοκρασία καθορίζουν αν οι GPU θα υποβαθμίζουν υπό συνεχές φορτίο συμπερασμού. Αν η εγκατάστασή σας δεν υποστηρίζει rack υψηλής πυκνότητας, ένας κόμβος 4U/4 GPU μέτριας ισχύος είναι συχνά πιο αξιόπιστος από ένα θεωρητικό τέρας 8 GPU που υποβαθμίζει θερμικά. Ο θόρυβος είναι ο άλλος ξεχασμένος περιορισμός: οι μονάδες ανεμιστήρων GPU πίσω είναι δυνατές, οπότε σχεδιάστε την τοποθεσία μακριά από ανθρώπους.
Διακομιστές ChangFan GPU: Μια πλατφόρμα ολόκληρου συστήματος για συμπερασμό AI
Η βιομηχανική AI είναι 70% φόρτος εργασίας και 30% υλικό, αλλά το λάθος 30% μπορεί να εξαφανίσει το 70%. Η Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) κατασκευάζει διακομιστές GPU rackmount σχεδιασμένους για συνεχή συμπερασμό: πλατφόρμες 4U που υποστηρίζουν έως 5 GPU διπλού πλάτους σε διπλούς Intel Xeon Scalable (γενιές 1-5) με έως 4 TB μνήμη DDR4/DDR5 ECC, παραλλαγές μονού υποδοχέως AMD EPYC 7002/7003/8004 με 4 GPU διπλού πλάτους και πλαίσια 24 θέσεων με προαιρετικό NVMe για αποθήκευση μοντέλων. Κάθε μονάδα συνοδεύεται από αφιερωμένη μονάδα ανεμιστήρων GPU πίσω, πλεονάζουσα ισχύ 1+1 ή 2+2, ενσωματωμένο δίκτυο Gigabit, επέκταση PCIe και απομακρυσμένη διαχείριση IPMI.
Αν αξιολογείτε ένα ιδιωτικό LLM, ένα API συμπερασμού ή έναν στόλο πρακτόρων, επικοινωνήστε με τη ChangFan για μια σύσταση διαμόρφωσης ολόκληρου συστήματος μεγέθους βάσει μεγέθους μοντέλου × ταυτόχρονη λειτουργία × ισχύ rack (μόνο υλικό, χωρίς συνδρομή λογισμικού). Υποστηρίζεται προσαρμογή OEM/ODM για ενσωματωτές και επωνυμίες.
Συχνές ερωτήσεις (FAQ)
Ε1: Πόσες GPU χρειάζεται ένα μοντέλο 7B για συμπερασμό;
Α: Μια μόνη κάρτα 24 GB εκτελεί ένα μοντέλο 7B σε INT8· για FP16 και μέτρια ταυτόχρονη λειτουργία, μια κάρτα 48 GB ή δύο 24 GB δίνουν άνετο περιθώριο. Ο πρώτος περιορισμός είναι το VRAM, όχι τα FLOPS.
Ε2: Να χρησιμοποιήσω καταναλωτικές κάρτες RTX ή GPU κέντρου δεδομένων;
Α: Οι καταναλωτικές κάρτες κερδίζουν σε τιμή ανά GB για πρωτότυπα και εσωτερικά εργαλεία χαμηλής ταυτόχρονης λειτουργίας· οι GPU κέντρου δεδομένων κερδίζουν σε εύρος ζώνης μνήμης, NVLink, ECC και αξιοπιστία 24/7. Επιλέξτε με βάση SLA και ταυτόχρονη λειτουργία, όχι τα κορυφαία FLOPS.
Ε3: Αρκεί ένας διακομιστής 4U 4-GPU για ένα μοντέλο 70B;
Α: Για εξυπηρέτηση INT8 σε μέτρια ταυτόχρονη λειτουργία, ναι: 4×48 GB (192 GB) χωράνε άνετα ένα μοντέλο 70B INT8 συν KV-κρυφή μνήμη. Για FP16, υψηλή ταυτόχρονη λειτουργία ή μοντέλα 180B, περάστε σε κόμβο 8 GPU NVLink.
Ε4: Σημαίνει το μεγαλύτερο VRAM πάντα ταχύτερο συμπερασμό;
Α: Όχι. Τα tokens ανά δευτερόλεπτο εξαρτώνται από το εύρος ζώνης μνήμης, το μέγεθος δέσμης και τον διασυνδετή. Η επιπλέον χωρητικότητα αποτρέπει το OOM και επιτρέπει μεγαλύτερες δέσμες, αλλά το εύρος ζώνης και η τοπολογία καθορίζουν την απόδοση.
Ε5: Μπορώ να προσθέσω GPU σε έναν τυπικό διακομιστή 2U αργότερα;
Α: Συνήθως όχι με ασφάλεια: οι τυπικοί διακομιστές στερούνται καλωδίωσης τροφοδοσίας GPU, μονάδων ανεμιστήρων πίσω και κατανομής λωρίδων PCIe για κάρτες διπλού πλάτους. Αγοράστε πλαίσιο σχεδιασμένο για GPU από την αρχή.
- Προηγούμενο άρθρο Η επέκταση του Edge AI το 2026: Από το Orin στο Thor, πώς η Changfan διασφαλίζει το υπολογιστικό θεμέλιο για τη «Φυσική Τεχνητή Νοημοσύνη» (Physical AI)
- Επόμενο άρθρο δεν υπάρχει άλλο