Jak wybrać serwer GPU do wnioskowania LLM w 2026 roku: VRAM, topologia i chłodzenie
Wstęp: wnioskowanie to miejsce, w którym naprawdę pojawia się rachunek za AI
W 2026 roku rozmowa o AI przeniosła się z trenowania na wnioskowanie. Wytrenowanie modelu czołowego to jednorazowa inwestycja kapitałowa; udostępnianie go użytkownikom to stały koszt operacyjny. Szacunki lokują wydatki na serwery AI na stromo rosnącej krzywej, a udział obliczeń przeznaczonych na wnioskowanie, a nie trenowanie, stanowi obecnie większość wdrożonych godzin GPU. Dla większości firm praktyczne pytanie nie brzmi już „który GPU jest najszybszy”, lecz „który serwer GPU utrzymuje niski koszt na milion tokenów przy mojej współbieżności, rozmiarze modelu i budżecie mocy szafy”. Ten przewodnik odpowiada liczbami.
Co tak naprawdę zużywa wnioskowanie LLM?
Krótka odpowiedź: wnioskowanie jest ograniczone przepustowością pamięci, a nie obliczeniami. Wygenerowanie każdego tokenu oznacza przesłanie wag modelu i KV-cache przez GPU, więc tokeny na sekundę skalują się znacznie bardziej z przepustowością pamięci i rozmiarem partii niż z surowymi TFLOPS.
Znaczenie mają dwie fazy. Prefill przetwarza cały prompt równolegle i jest intensywny obliczeniowo; decode generuje wyjście token po tokenie i jest intensywny pamięciowo. Długie prompty i długie odpowiedzi obciążają więc różne zasoby. Dlatego karta o ogromnych TFLOPS, ale małej VRAM i wąskiej przepustowości może przegrać z „wolniejszą” kartą o większej przepustowości pamięci w rzeczywistych obciążeniach czatu. Dobierając serwer, patrz łącznie na pojemność VRAM, przepustowość VRAM i topologię NVLink/PCIe, a nie tylko na szczytowe FLOPS z karty katalogowej.
Ile VRAM potrzebują modele 7B, 13B, 70B i 180B?
Krótka odpowiedź: przyjmij około 2 bajtów na parametr w FP16, 1 bajt w INT8 i 0,5 bajta w INT4, a następnie dodaj 15-30 % na KV-cache i narzut wykonania. Pojedynczy model 70B w INT8 potrzebuje około 80-100 GB przed batchowaniem, czyli co najmniej kart 2x48 GB lub 4x24 GB.
KV-cache to ukryty koszt. Rośnie wraz z długością kontekstu x liczbą równoczesnych sekwencji x liczbą warstw, więc serwer mieszczący model przy kontekście 4K może zabraknąć pamięci przy 32K lub wysokiej współbieżności. Planuj VRAM pod długość kontekstu p95 i docelową współbieżność, a nie pod prompt demonstracyjny. Z reguły wdrożenia optymalizowane pod wnioskowanie zostawiają 20-30 % zapasu VRAM, aby scheduler mógł agresywnie batchować bez restartów z powodu OOM.
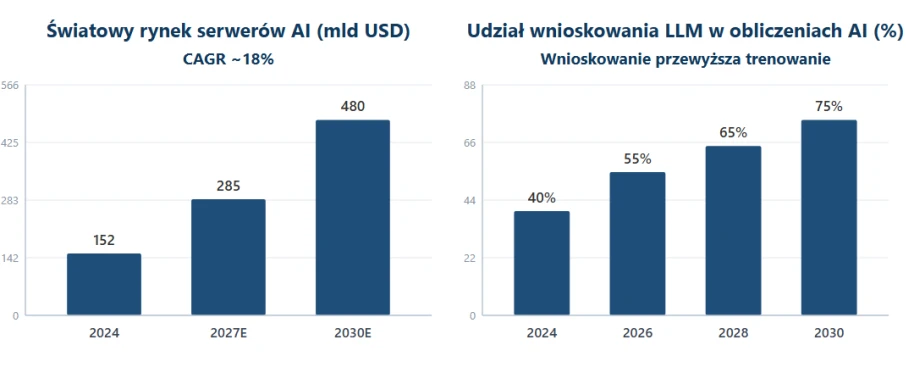
Rysunek 1: wielkość rynku serwerów AI i rosnący udział wnioskowania LLM (źródła w załączniku)
4U multi-GPU czy obudowa 8 GPU? Topologia, chłodzenie i rozbudowa
Krótka odpowiedź: jeden serwer 4U z 4-5 GPU o podwójnej szerokości to optimum dla większości prywatnych wdrożeń LLM; przejdź na platformę 8 GPU NVLink tylko wtedy, gdy jeden model musi objąć więcej niż cztery GPU lub potrzebujesz maksymalnej przepustowości na węzeł.
Topologia decyduje, czy wnioskowanie multi-GPU się skaluje. Dystrybucja wyłącznie przez PCIe wystarcza dla małych modeli i obsługi data-parallel, ale obsługa tensor-parallel modelu 70B+ wymaga szybkich łączy GPU-GPU (NVLink/NVSwitch), inaczej połączenie staje się wąskim gardłem. Termika decyduje o przetrwaniu: cztery lub pięć kart o podwójnej szerokości 350-700 W w 4U wymagają dedykowanego tylnego modułu wentylatorów GPU i przepływu powietrza od przodu do tyłu. Zaplanuj zasilanie redundantne 3+1 lub 2+2 i potwierdź, że szafa dostarcza odpowiednie ampery.
▪ Pojedynczy GPU: najlepszy do prototypów 7B-13B i narzędzi wewnętrznych o niskiej współbieżności.
▪ 2-4 GPU w jednym 4U: najlepszy balans pojemności, redundancji i mocy dla modeli 32B-70B.
▪ Węzeł 8 GPU NVLink: do obsługi tensor-parallel 70B+, API multi-tenant lub flot agentów.
▪ Zawsze sprawdź przydział linii PCIe i prześwit tylnych wentylatorów przed zakupem.
Scenariusze wnioskowania LLM a konfiguracja serwera GPU (2026)
Tabela poniżej mapuje typowe obciążenia wnioskowania na wyjściową obudowę sprzętową. Traktuj ją jako bazę doboru, a następnie doprecyzuj na podstawie zmierzonych tokenów na sekundę na własnym zestawie promptów.
Scenariusz | Model i współbieżność | Konfiguracja GPU | Docelowa VRAM | Zalecana platforma |
Prototyp / jeden deweloper | 7B-13B, 1-3 użytkowników | 1 GPU o podwójnej szerokości | 24-48 GB | Stacja GPU 1U/2U |
Wnioskowanie zespołowe | 7B-32B, 5-20 użytkowników | 1-2 GPU o podwójnej szerokości | 48-96 GB | Serwer GPU 2U |
LLM działowy | 70B (INT8), 20-50 użytkowników | 2-4 GPU | 96-160 GB | Serwer 4U z 4 GPU |
Obsługa korporacyjna | 70B-180B, 50-200 użytkowników | 4-8 GPU + NVLink | 160-640 GB | Węzeł 4U/8 GPU NVLink |
Multi-tenant / agenci | Dowolny, 200+ użytkowników | 8 GPU centrum danych | 640 GB+ | 8 GPU HGX / klaster |
Tabela 1: obciążenia wnioskowania LLM a konfiguracje serwera GPU (2026)
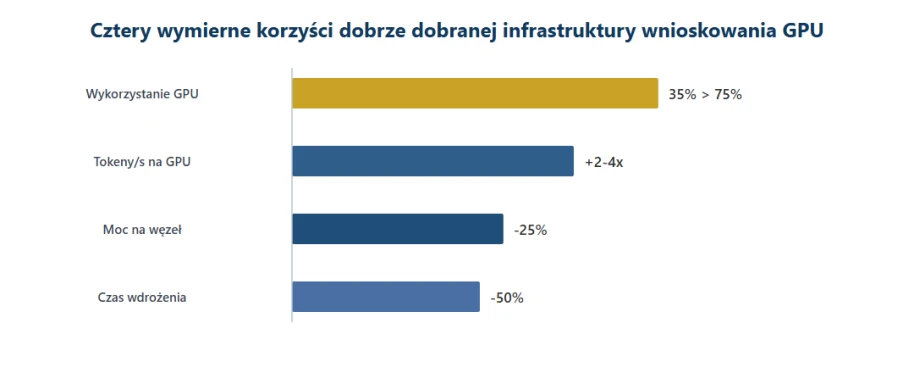
Rysunek 2: cztery wymierne korzyści dobrze dobranej infrastruktury wnioskowania GPU (ilustracyjnie, źródła w załączniku)
Zasilanie, chłodzenie i serwerownia, o której zapomniałeś w budżecie
Krótka odpowiedź: gęste serwery GPU zamieniają szafę w grzejnik. Węzeł 4U z czterema GPU po 600 W plus CPU i wentylatory może pobierać 3-4 kW; węzły 8 GPU przekraczają 8-10 kW. Potwierdź, że PDU, obwód i chłodzenie to wytrzymają, zanim sprzęt dotrze.
Kierunek przepływu powietrza, obudowa zimnych i gorących korytarzy oraz temperatura otoczenia decydują, czy GPU będą dławić się pod ciągłym obciążeniem wnioskowania. Jeśli obiekt nie obsługuje szaf o wysokiej gęstości, węzeł 4U/4 GPU o umiarkowanej mocy bywa niezawodniejszy niż teoretyczny potwór 8 GPU, który dławi się termicznie. Hałas to kolejne zapomniane ograniczenie: tylne moduły wentylatorów GPU są głośne, więc zaplanuj lokalizację z dala od ludzi.
Serwery GPU ChangFan: platforma całosystemowa stworzona do wnioskowania AI
AI przemysłowe to 70 % obciążenia i 30 % sprzętu, ale niewłaściwe 30 % może wyzerować 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) produkuje szafowe serwery GPU zaprojektowane do ciągłego wnioskowania: platformy 4U obsługujące do 5 GPU o podwójnej szerokości na dwóch Intel Xeon Scalable (1-5 gen.) z pamięcią DDR4/DDR5 ECC do 4 TB, warianty jednoprocesorowe AMD EPYC 7002/7003/8004 z 4 GPU o podwójnej szerokości oraz obudowy 24-kieszeniowe z opcjonalnym NVMe do przechowywania modeli. Każda jednostka ma dedykowany tylny moduł wentylatorów GPU, zasilanie redundantne 1+1 lub 2+2, zintegrowaną sieć Gigabit, rozbudowę PCIe i zdalne zarządzanie IPMI.
Jeśli oceniasz prywatny LLM, API wnioskowania lub flotę agentów, skontaktuj się z ChangFan po rekomendację konfiguracji całosystemowej dobranej według rozmiaru modelu x współbieżności x mocy szafy (tylko sprzęt, bez subskrypcji oprogramowania). Wspieramy personalizację OEM/ODM dla integratorów i marek.
Najczęstsze pytania (FAQ)
P1: Ile GPU potrzebuje model 7B do wnioskowania?
O: Jedna karta 24 GB uruchamia model 7B w INT8; dla FP16 i umiarkowanej współbieżności jedna karta 48 GB lub dwie 24 GB dają wygodny zapas. Pierwszym ograniczeniem jest VRAM, nie FLOPS.
P2: Karty RTX konsumenckie czy GPU centrów danych?
O: Karty konsumenckie wygrywają ceną za GB przy prototypach i narzędziach wewnętrznych o niskiej współbieżności; GPU centrów danych wygrywają przepustowością pamięci, NVLink, ECC i niezawodnością 24/7. Wybieraj według SLA i współbieżności, a nie szczytowych FLOPS.
P3: Czy serwer 4U z 4 GPU wystarczy dla modelu 70B?
O: Dla obsługi INT8 przy umiarkowanej współbieżności tak: 4x48 GB (192 GB) wygodnie mieszczą model 70B INT8 plus KV-cache. Dla FP16, wysokiej współbieżności lub modeli 180B przejdź na węzeł 8 GPU NVLink.
P4: Czy więcej VRAM zawsze oznacza szybsze wnioskowanie?
O: Nie. Tokeny na sekundę zależą od przepustowości pamięci, rozmiaru partii i połączenia. Większa pojemność zapobiega OOM i pozwala na większe partie, ale przepustowość i topologia decydują o wydajności.
P5: Czy mogę później dodać GPU do standardowego serwera 2U?
O: Zwykle nie jest to bezpieczne: standardowe serwery nie mają okablowania zasilania GPU, tylnych modułów wentylatorów ani przydziału linii PCIe dla kart o podwójnej szerokości. Kupuj obudowę zaprojektowaną pod GPU od początku.
- Poprzedni artykuł Skalowanie Edge AI w 2026 roku: Od Orin do Thor – jak Changfan zabezpiecza fundamenty obliczeniowe dla „Fizycznej AI” (Physical AI)
- Następny artykuł nie ma już żadnych