Як вибрати GPU-сервер для LLM-інференсу у 2026 році: VRAM, топологія та охолодження
Вступ: інференс — там, де насправді формується рахунок за ШІ
У 2026 році розмова про ШІ змістилася з навчання на інференс. Навчання фронтирної моделі — разова капітальна інвестиція; її обслуговування для користувачів — постійні операційні витрати. Оцінки показують, що витрати на ШІ-сервери зростають по крутій кривій, а частка обчислень, що припадає на інференс, а не на навчання, тепер становить більшість розгорнутих GPU-годин. Для більшості компаній практичне питання вже не «який GPU швидший», а «який GPU-сервер утримує низьку вартість за мільйон токенів за моєї конкурентності, розміру моделі та бюджету потужності стійки». Цей посібник відповідає цифрами.
Що насправді споживає LLM-інференс?
Коротка відповідь: інференс обмежений пропускною здатністю пам'яті, а не обчисленнями. Генерація кожного токена означає потокову передачу ваг моделі та KV-кешу через GPU, тому токени за секунду масштабуються значно сильніше від пропускної здатності пам'яті й розміру батчу, ніж від чистих TFLOPS.
Важливі дві фази. Prefill обробляє весь промпт паралельно й навантажує обчислення; decode генерує вивід токен за токеном і навантажує пам'ять. Тому довгі промпти й довгі відповіді навантажують різні ресурси. Саме тому карта з величезними TFLOPS, але малою VRAM і вузькою пропускною здатністю може програти «повільнішій» карті з більшою пропускною здатністю на реальних чат-навантаженнях. Підбираючи сервер, дивіться на обсяг VRAM, пропускну здатність VRAM і топологію NVLink/PCIe разом, а не лише на пікові FLOPS зі специфікації.
Скільки VRAM потрібно моделям 7B, 13B, 70B і 180B?
Коротка відповідь: закладайте приблизно 2 байти на параметр у FP16, 1 байт в INT8 і 0,5 байта в INT4, потім додайте 15-30 % на KV-кеш і накладні витрати. Одній моделі 70B в INT8 потрібно близько 80-100 ГБ до батчингу, тобто щонайменше карти 2x48 ГБ або 4x24 ГБ.
KV-кеш — прихована стаття витрат. Він зростає з довжиною контексту x кількістю одночасних послідовностей x кількістю шарів, тому сервер, що вміщає модель за контексту 4K, може вичерпати пам'ять за 32K або високої конкурентності. Плануйте VRAM під довжину контексту p95 і цільову конкурентність, а не під демонстраційний промпт. Як правило, оптимізовані під інференс розгортання залишають 20-30 % запасу VRAM, щоб планувальник міг агресивно батчити без перезапусків через OOM.
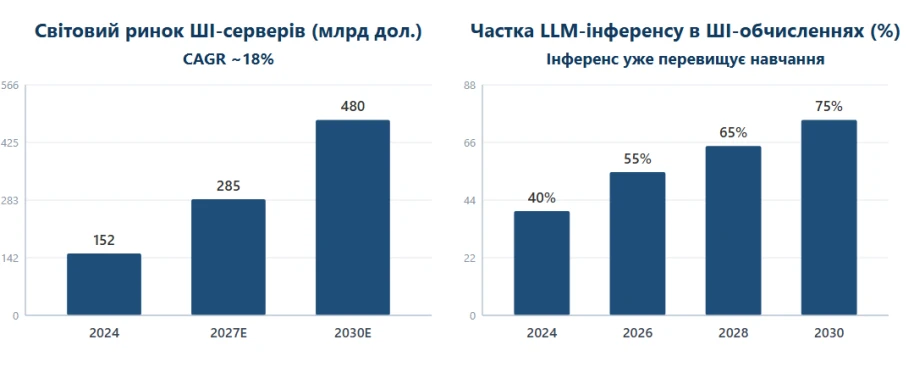
Рис. 1: обсяг ринку ШІ-серверів і зростання частки LLM-інференсу (джерела в додатку)
4U multi-GPU чи шасі на 8 GPU? Топологія, охолодження та розширення
Коротка відповідь: один 4U-сервер із 4-5 GPU подвійної ширини — оптимум для більшості приватних LLM-розгортань; переходьте на платформу 8 GPU NVLink лише якщо одна модель має охоплювати понад чотири GPU або потрібен максимальний пропуск на вузол.
Топологія вирішує, чи масштабується multi-GPU інференс. Чисто PCIe-розподілу достатньо для невеликих моделей і data-parallel обслуговування, але tensor-parallel обслуговування моделі 70B+ потребує високошвидкісних зв'язків GPU-GPU (NVLink/NVSwitch), інакше interconnect стає вузьким місцем. Терміка вирішує, чи виживе система: чотири-п'ять карт подвійної ширини 350-700 Вт у 4U потребують виділеного заднього модуля вентиляторів GPU і потоку повітря спереду назад. Передбачте резервування живлення 3+1 або 2+2 і переконайтеся, що стійка видає потрібні ампери.
▪ Один GPU: найкраще для прототипів 7B-13B і внутрішніх інструментів із низькою конкурентністю.
▪ 2-4 GPU в одному 4U: найкращий баланс ємності, резервування й потужності для моделей 32B-70B.
▪ Вузол 8 GPU NVLink: для tensor-parallel обслуговування 70B+, мультитенантних API або флотів агентів.
▪ Завжди перевіряйте розподіл ліній PCIe і зазор для задніх вентиляторів перед покупкою.
Сценарії LLM-інференсу проти конфігурації GPU-сервера (2026)
Таблиця нижче зіставляє типові навантаження інференсу з початковим апаратним профілем. Використовуйте її як базу для підбору, потім уточніть за виміряними токенами за секунду на вашому наборі промптів.
Сценарій | Модель і конкурентність | Конфігурація GPU | Ціль VRAM | Рекомендована платформа |
Прототип / один розробник | 7B-13B, 1-3 користувачі | 1 GPU подвійної ширини | 24-48 ГБ | GPU-станція 1U/2U |
Командний інференс | 7B-32B, 5-20 користувачів | 1-2 GPU подвійної ширини | 48-96 ГБ | GPU-сервер 2U |
Відділ / LLM | 70B (INT8), 20-50 користувачів | 2-4 GPU | 96-160 ГБ | Сервер 4U на 4 GPU |
Корпоративне обслуговування | 70B-180B, 50-200 користувачів | 4-8 GPU + NVLink | 160-640 ГБ | Вузол 4U/8 GPU NVLink |
Мультитенант / агенти | Будь-яка, 200+ користувачів | 8 GPU ЦОД | 640 ГБ+ | 8 GPU HGX / кластер |
Таблиця 1: навантаження LLM-інференсу проти конфігурацій GPU-сервера (2026)
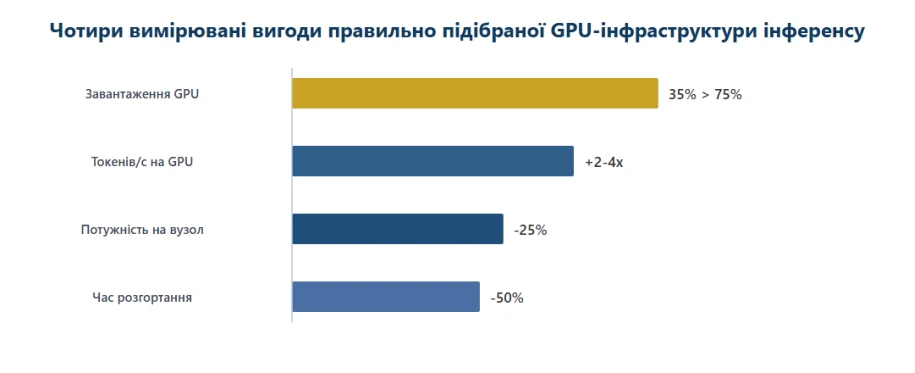
Рис. 2: чотири вимірювані вигоди правильно підібраної GPU-інфраструктури інференсу (ілюстративно, джерела в додатку)
Живлення, охолодження і приміщення, яке ви забули закласти в бюджет
Коротка відповідь: щільні GPU-сервери перетворюють стійку на обігрівач. Вузол 4U з чотирма GPU по 600 Вт плюс CPU і вентилятори може споживати 3-4 кВт; вузли на 8 GPU перевищують 8-10 кВт. Переконайтеся, що PDU, ланцюг і охолодження витримають це до прибуття обладнання.
Напрямок повітряного потоку, ізоляція гарячих коридорів і температура довкілля визначають, чи будуть GPU тротлити під тривалим навантаженням інференсу. Якщо ваше приміщення не підтримує стійки високої щільності, вузол 4U/4 GPU помірної потужності часто надійніший за теоретичного «монстра» на 8 GPU, який тротлить через тепло. Шум — ще одне забуте обмеження: задні модулі вентиляторів GPU гучні, тому розміщуйте обладнання далі від людей.
GPU-сервери ChangFan: платформа повного циклу для ШІ-інференсу
Промисловий ШІ — це 70 % навантаження і 30 % обладнання, але неправильні 30 % можуть обнулити 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) виробляє стійкові GPU-сервери для тривалого інференсу: платформи 4U з підтримкою до 5 GPU подвійної ширини на двох Intel Xeon Scalable (1-5 покоління) з пам'яттю DDR4/DDR5 ECC до 4 ТБ, односокетні варіанти AMD EPYC 7002/7003/8004 з 4 GPU подвійної ширини та шасі на 24 відсіки з опційним NVMe для зберігання моделей. Кожен сервер має виділений задній модуль вентиляторів GPU, резервування живлення 1+1 або 2+2, вбудовану мережу Gigabit, розширення PCIe та віддалене керування IPMI.
Якщо ви оцінюєте приватну LLM, API інференсу або флот агентів, зв'яжіться з ChangFan для рекомендації щодо конфігурації повного циклу, розрахованої за розміром моделі x конкурентністю x потужністю стійки (лише обладнання, без підписки на ПЗ). Підтримується OEM/ODM-кастомізація для інтеграторів і брендів.
Часті запитання (FAQ)
П1: Скільки GPU потрібно моделі 7B для інференсу?
В: Однієї карти 24 ГБ достатньо для 7B в INT8; для FP16 і помірної конкурентності одна карта 48 ГБ або дві по 24 ГБ дають комфортний запас. Перше обмеження — VRAM, а не FLOPS.
П2: Використовувати споживчі RTX чи серверні GPU?
В: Споживчі карти виграють за ціною за ГБ для прототипів і внутрішніх інструментів із низькою конкурентністю; серверні GPU виграють за пропускною здатністю пам'яті, NVLink, ECC і надійністю 24/7. Вибирайте за SLA і конкурентністю, а не за піковими FLOPS.
П3: Чи достатньо сервера 4U на 4 GPU для моделі 70B?
В: Для INT8-обслуговування за помірної конкурентності так: 4x48 ГБ (192 ГБ) комфортно вміщають модель 70B INT8 плюс KV-кеш. Для FP16, високої конкурентності або моделей 180B переходьте на вузол 8 GPU NVLink.
П4: Чи завжди більше VRAM означає швидший інференс?
В: Ні. Токени за секунду залежать від пропускної здатності пам'яті, розміру батчу та interconnect. Додаткова ємність запобігає OOM і дозволяє більші батчі, але пропускна здатність і топологія визначають throughput.
П5: Чи можна згодом додати GPU у стандартний 2U-сервер?
В: Зазвичай ні, безпечно не можна: стандартним серверам бракує кабелів живлення GPU, задніх модулів вентиляторів і розподілу ліній PCIe для карт подвійної ширини. Купуйте шасі, спроєктоване під GPU, від самого початку.
- Попередня стаття Масштабування Edge AI у 2026 році: від Orin до Thor — як Changfan закладає обчислювальний фундамент для «Фізичного ШІ» (Physical AI)
- Наступна стаття більше немає