วิธีเลือกเซิร์ฟเวอร์ GPU สำหรับ LLM Inference ในปี 2026: VRAM, ทอพอโลยี และการระบายความร้อน
บทนำ: อินฟิวเรนซ์คือจุดที่บิล AI ตกจริงๆ
ในปี 2026 บทสนทนาเรื่อง AI เปลี่ยนจากการเทรนไปสู่การอินฟิวเรนซ์ การเทรนโมเดลแนวหน้าคือเหตุการณ์ลงทุนทุนครั้งเดียว แต่การให้บริการแก่ผู้ใช้คือต้นทุนการดำเนินงานถาวร ประมาณการของอุตสาหกรรมวางค่าใช้จ่ายเซิร์ฟเวอร์ AI บนเส้นโค้งชัน และสัดส่วนการประมวลผลที่ใช้สำหรับอินฟิวเรนซ์แทนที่จะเป็นการเทรนนั้นกลายเป็นส่วนใหญ่ของ GPU-hours ที่ถูกดีploy ไปแล้ว สำหรับบริษัทส่วนใหญ่ คำถามเชิงปฏิบัติไม่ใช่ 'GPU ตัวไหนเร็วที่สุด' อีกต่อไป แต่คือ 'เซิร์ฟเวอร์ GPU ตัวไหนรักษาต้นทุนต่อล้านโทเค็นให้ต่ำในระดับคอนครเรนซี ขนาดโมเดล และงบประมาณกำลังของเร็คของฉัน' คู่มือนี้ตอบด้วยตัวเลข
LLM Inference ใช้ทรัพยากรอะไรจริงๆ?
คำตอบสั้น: อินฟิวเรนซ์ถูกจำกัดด้วยแบนด์วิธของหน่วยความจำ ไม่ใช่กำลังประมวลผล การสร้างแต่ละโทเค็นหมายถึงการสตรีมน้ำหนักโมเดลและ KV-cache ผ่าน GPU ดังนั้นโทเค็นต่อวินาทีจึงแปรผันตามแบนด์วิธหน่วยความจำและขนาดแบตช์มากกว่าตาม TFLOPS ดิบ
มีสองเฟสที่สำคัญ Prefill ประมวลผลพรอมต์ทั้งหมดแบบขนานและหนักด้านคำนวณ; decode สร้างผลลัพธ์ทีละโทเค็นและหนักด้านแบนด์วิธหน่วยความจำ นั่นจึงทำให้พรอมต์ยาวและผลลัพธ์ยาวกดดันทรัพยากรต่างกัน เพราะฉะนั้นการ์ดที่มี TFLOPS มหาศาลแต่ VRAM น้อยและแบนด์วิธแคบอาจแพ้การ์ด 'ช้า' ที่มีแบนด์วิธหน่วยความจำมากกว่าในภาระงานแชทจริง เมื่อกำหนดขนาดเซิร์ฟเวอร์ ให้ดูความจุ VRAM, แบนด์วิธ VRAM และทอพอโลยี NVLink/PCIe ไปพร้อมกัน ไม่ใช่เพียงจุดสูงสุด FLOPS ในสเปค
คุณต้องการ VRAM เท่าใดสำหรับโมเดล 7B, 13B, 70B และ 180B?
คำตอบสั้น: คำนวณประมาณ 2 ไบต์ต่อพารามิเตอร์ใน FP16, 1 ไบต์ใน INT8 และ 0.5 ไบต์ใน INT4 แล้วบวกเพิ่ม 15-30% สำหรับ KV-cache และค่าใช้จ่ายขณะรัน โมเดล 70B เดี่ยวใน INT8 ต้องการประมาณ 80-100 GB ก่อนแบตช์ แปลว่าต้องการอย่างน้อย 2×48GB หรือ 4×24GB
KV-cache คือต้นทุนที่ซ่อนอยู่ มันเติบโตตามความยาวคอนเทกซ์ x ลำดับที่ทำงานพร้อมกัน x จำนวนเลเยอร์ ดังนั้นเซิร์ฟเวอร์ที่จุโมเดลได้ที่คอนเทกซ์ 4K อาจหมดหน่วยความจำที่ 32K หรือคอนครเรนซีสูง วางแผน VRAM สำหรับความยาวคอนเทกซ์ p95 และคอนครเรนซีเป้าหมาย ไม่ใช่พรอมต์สาธิต เป็นกฎของ thumb การดีploy ที่ปรับให้เหมาะกับอินฟิวเรนซ์จะเผื่อ VRAM 20-30% เพื่อให้ตัวจัดตารางแบตช์ได้อย่างสะใจโดยไม่ต้องเริ่มใหม่จาก OOM
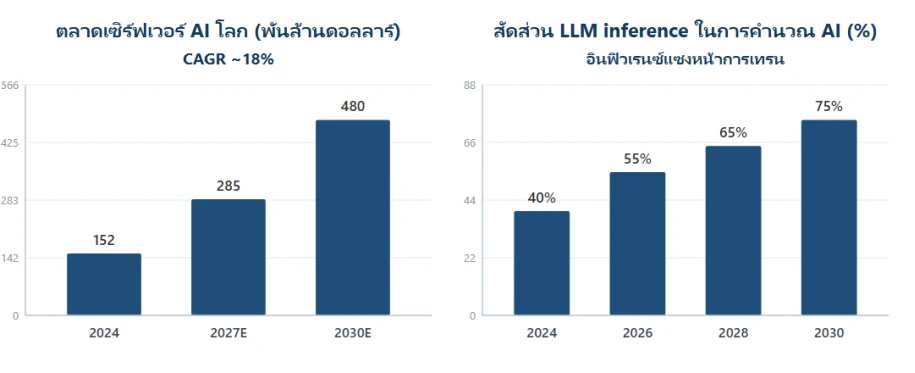
ภาพที่ 1: ขนาดตลาดเซิร์ฟเวอร์ AI และสัดส่วน LLM inference ที่เพิ่มขึ้น (แหล่งในภาคผนวก)
4U Multi-GPU หรือ 8-GPU Chassis? ทอพอโลยี, การระบายความร้อน และการขยาย
คำตอบสั้น: เซิร์ฟเวอร์ 4U เดี่ยวที่มี GPU 4-5 ตัวแบบ dual-width คือจุดที่ดีที่สุดสำหรับการดีploy LLM ส่วนตัวส่วนใหญ่; ย้ายไปแพลตฟอร์ม 8-GPU NVLink เมื่อโมเดลหนึ่งต้องขยายข้าม GPU มากกว่าสี่ตัวหรือเมื่อคุณต้องการทราฟฟิกสูงสุดต่อโหนด
ทอพอโลยีตัดสินว่าอินฟิวเรนซ์ multi-GPU จะขยายได้หรือไม่ การกระจายเฉพาะ PCIe พอบังสำหรับโมเดลเล็กและการให้บริการแบบ data-parallel แต่การให้บริการ tensor-parallel ของโมเดล 70B+ ต้องการเชื่อมต่อ GPU-to-GPU แบนด์วิธสูง (NVLink/NVSwitch) ไม่งั้น interconnect จะเป็นคอขวด ความร้อนตัดสินว่ามันจะรอดหรือไม่: GPU 4-5 ตัวแบบ dual-width 350-700W ใน 4U ต้องการโมดูลพัดลม GPU หลังเฉพาะทางและการไหลของอากาศหน้าไปหลัง วางแผนพาวเวอร์สำรอง 3+1 หรือ 2+2 และยืนยันว่าเร็คจ่ายแอมแปร์ได้
▪ GPU เดี่ยว: เหมาะที่สุดสำหรับโปรโตไทป์ 7B-13B และเครื่องมือภายในที่คอนครเรนซีต่ำ
▪ GPU 2-4 ตัวใน 4U เดียว: สมดุลความจุ, ความสำรอง และกำลังที่ดีที่สุดสำหรับโมเดล 32B-70B
▪ โหนด 8-GPU NVLink: สำหรับการให้บริการ tensor-parallel 70B+, API แบบ multi-tenant หรือฝูงเอเจนต์
▪ ตรวจสอบการจัดสรรเลน PCIe และระยะห่างพัดลมหลังก่อนซื้อเสมอ
สถานการณ์ LLM Inference เทียบกับการกำหนดค่าเซิร์ฟเวอร์ GPU (2026)
ตารางด้านล่างจับคู่ภาระงานอินฟิวเรนซ์ typical กับกรอบฮาร์ดแวร์เริ่มต้น ใช้เป็นฐานสำหรับการกำหนดขนาด แล้วปรับแต่งด้วยโทเค็นต่อวินาทีที่วัดได้จากชุดพรอมต์ของคุณ
สถานการณ์ | โมเดลและคอนครเรนซี | การกำหนดค่า GPU | เป้าหมาย VRAM | แพลตฟอร์มที่แนะนำ |
โปรโตไทป์ / นักพัฒนาเดี่ยว | 7B-13B, ผู้ใช้ 1-3 | GPU 1 ตัวแบบ dual-width | 24-48 GB | สถานีงาน GPU 1U/2U |
อินฟิวเรนซ์ทีม | 7B-32B, ผู้ใช้ 5-20 | GPU 1-2 ตัวแบบ dual-width | 48-96 GB | เซิร์ฟเวอร์ GPU 2U |
LLM ฝ่าย | 70B (INT8), ผู้ใช้ 20-50 | GPU 2-4 ตัว | 96-160 GB | เซิร์ฟเวอร์ 4U 4-GPU |
การให้บริการระดับองค์กร | 70B-180B, ผู้ใช้ 50-200 | GPU 4-8 ตัว + NVLink | 160-640 GB | โหนด 4U/8-GPU NVLink |
Multi-tenant / เอเจนต์ | ใดก็ได้, ผู้ใช้ 200+ | GPU 8 ตัวระดับ数据中心 | 640 GB+ | 8-GPU HGX / คลัสเตอร์ |
ตาราง 1: ภาระงาน LLM inference เทียบกับการกำหนดค่าเซิร์ฟเวอร์ GPU (2026)
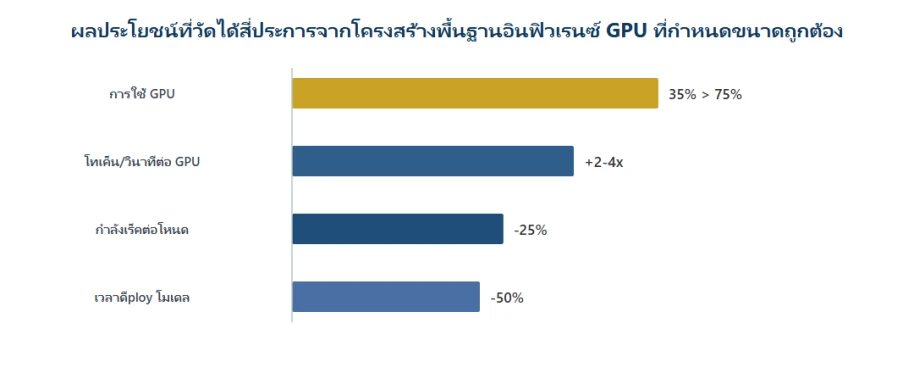
ภาพที่ 2: ผลประโยชน์ที่วัดได้สี่ประการจากโครงสร้างพื้นฐานอินฟิวเรนซ์ GPU ที่กำหนดขนาดถูกต้อง (เชิงประจักษ์, แหล่งในภาคผนวก)
กำลัง, การระบายความร้อน และห้องที่คุณลืมคำนวณในงบ
คำตอบสั้น: เซิร์ฟเวอร์ GPU ความหนาแน่นสูงเปลี่ยนเร็คให้เป็นเตาร้อน โหนด 4U ที่มี GPU 600W สี่ตัวรวม CPU และพัดลมอาจใช้ 3-4 kW; โหนด 8-GPU ทะลุ 8-10 kW ยืนยันว่า PDU, วงจร และการระบายความร้อนรับไหวก่อนฮาร์ดแวร์มาถึง
ทิศทางการไหลของอากาศ, การกั้นระเบียงร้อน และอุณหภูมิห้องล้วนกำหนดว่า� GPU จะ throttle ภายใต้ภาระอินฟิวเรนซ์ต่อเนื่องหรือไม่ หากสถานที่ของคุณไม่รองรับเร็คความหนาแน่นสูง โหนด 4U/4-GPU กำลังปานกลางมักเชื่อถือได้กว่าปีกษ์ 8-GPU ที่ throttle ด้วยความร้อน เสียงคือข้อจำกัดที่ถูกลืมอีกประการ: โมดูลพัดลม GPU หลังเสียงดัง จึงวางให้ห่างจากคน
เซิร์ฟเวอร์ ChangFan GPU: แพลตฟอร์มระบบเต็มสำหรับอินฟิวเรนซ์ AI
AI อุตสาหกรรมคือภาระงาน 70% และฮาร์ดแวร์ 30% แต่ 30% ที่ผิดอาจลบ 70% ได้ Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) ผลิตเซิร์ฟเวอร์ GPU แบบ rackmount ที่ออกแบบสำหรับอินฟิวเรนซ์ต่อเนื่อง: แพลตฟอร์ม 4U รองรับ GPU แบบ dual-width ได้ถึง 5 ตัวบน dual Intel Xeon Scalable (รุ่นที่ 1-5) ด้วยหน่วยความจำ DDR4/DDR5 ECC สูงสุด 4TB, รุ่น single-socket AMD EPYC 7002/7003/8004 ที่มี GPU แบบ dual-width 4 ตัว, และชาร์ชิส 24 ช่องพร้อม NVMe เสริมสำหรับเก็บโมเดล ทุกหน่วยมาพร้อมโมดูลพัดลม GPU หลังเฉพาะทาง, พาวเวอร์สำรอง 1+1 หรือ 2+2, เครือข่าย Gigabit บนบอร์ด, การขยาย PCIe และการจัดการระยะไกล IPMI
หากคุณกำลังประเมิน LLM แบบส่วนตัว, API อินฟิวเรนซ์ หรือฝูงเอเจนต์ ติดต่อ ChangFan เพื่อขอคำแนะนำการกำหนดค่าระบบเต็มที่ขนาดตามขนาดโมเดล x คอนครเรนซี x กำลังเร็ค (ฮาร์ดแวร์ only, ไม่มีสมัครสมาชิกซอฟต์แวร์) รองรับการปรับแต่ง OEM/ODM สำหรับผู้รวบรวมและแบรนด์
คำถามที่พบบ่อย (FAQ)
Q1: โมเดล 7B ต้องการ GPU กี่ตัวสำหรับอินฟิวเรนซ์?
A: การ์ด 24GB หนึ่งใบรันโมเดล 7B ใน INT8 ได้; สำหรับ FP16 และคอนครเรนซีปานกลาง การ์ด 48GB หนึ่งใบหรือสองใบ 24GB ให้ช่องว่างสบาย ข้อจำกัดแรกคือ VRAM ไม่ใช่ FLOPS
Q2: ควรใช้การ์ดผู้บริโภค RTX หรือ GPU 数据中心 สำหรับอินฟิวเรนซ์?
A: การ์ดผู้บริโภคชนะด้านราคาต่อ GB สำหรับโปรโตไทป์และเครื่องมือภายในคอนครเรนซีต่ำ; GPU 数据中心 ชนะด้านแบนด์วิธหน่วยความจำ, NVLink, ECC และความน่าเชื่อถือ 24/7 เลือกตาม SLA และคอนครเรนซี ไม่ใช่จุดสูงสุด FLOPS
Q3: เซิร์ฟเวอร์ 4U 4-GPU พอสำหรับโมเดล 70B หรือไม่?
A: สำหรับการให้บริการ INT8 ที่คอนครเรนซีปานกลาง ใช่: 4×48GB (192GB) จุโมเดล 70B INT8 พร้อม KV-cache ได้สบาย สำหรับ FP16, คอนครเรนซีสูง หรือโมเดล 180B ให้ย้ายไปโหนด 8-GPU NVLink
Q4: VRAM มากขึ้นหมายถึงอินฟิวเรนซ์เร็วขึ้นเสมอหรือ?
A: ไม่ โทเค็นต่อวินาทีขึ้นอยู่กับแบนด์วิธหน่วยความจำ, ขนาดแบตช์ และ interconnect ความจุเพิ่มป้องกัน OOM และเปิดให้แบตช์ใหญ่ขึ้น แต่แบนด์วิธและทอพอโลยีตัดสินทราฟฟิก
Q5: สามารถเพิ่ม GPU ในเซิร์ฟเวอร์ 2U มาตรฐานทีหลังได้หรือไม่?
A: โดยทั่วไปไม่ปลอดภัย: เซิร์ฟเวอร์มาตรฐานขาดการเดินสายไฟ GPU, โมดูลพัดลมหลัง และการจัดสรรเลน PCIe สำหรับการ์ดแบบ dual-width ซื้อชาร์ชิสที่ออกแบบสำหรับ GPU ตั้งแต่แรก
- บทความก่อนหน้า การขยายขอบเขต Edge AI ปี 2026: จาก Orin สู่ Thor, Changfan สร้างรากฐานคอมพิวเตอร์สำหรับ "Physical AI" ได้อย่างไร
- บทความถัดไป ไม่มีเหลือแล้ว