Como escolher um servidor GPU para inferência de LLM em 2026: VRAM, topologia e refrigeração
Introdução: a inferência é onde a conta da IA realmente chega
Em 2026 a conversa sobre IA passou do treino para a inferência. Treinar um modelo de fronteira é um investimento único; servi-lo aos usuários é um custo operacional permanente. As estimativas colocam o gasto em servidores de IA numa curva íngreme, e a parcela de computação dedicada à inferência em vez do treino já representa a maioria das horas de GPU implantadas. Para a maioria das empresas a pergunta prática já não é «qual GPU é a mais rápida», mas «qual servidor GPU mantém baixo o custo por milhão de tokens na minha concorrência, tamanho de modelo e orçamento de energia no rack». Este guia responde com números.
O que a inferência de LLM realmente consome?
Resposta rápida: a inferência é limitada pela largura de banda de memória, não pela computação. Gerar cada token significa transmitir os pesos do modelo e o KV-cache pela GPU, então tokens por segundo escalam muito mais com largura de banda de memória e tamanho do lote do que com TFLOPS brutos.
Duas fases importam. O prefill processa todo o prompt em paralelo e é intensivo em computação; o decode gera a saída token a token e é intensivo em largura de banda de memória. Prompts longos e saídas longas, portanto, pressionam recursos diferentes. É por isso que uma placa com TFLOPS enormes mas pouca VRAM e banda estreita pode perder para uma placa «mais lenta» com mais largura de banda em cargas reais de chat. Ao dimensionar um servidor, observe juntos capacidade de VRAM, largura de banda de VRAM e topologia NVLink/PCIe, não apenas o pico de FLOPS da ficha técnica.
Quanta VRAM os modelos 7B, 13B, 70B e 180B exigem?
Resposta rápida: calcule cerca de 2 bytes por parâmetro em FP16, 1 byte em INT8 e 0,5 byte em INT4, e acrescente 15-30 % para o KV-cache e a sobrecarga de execução. Um único modelo 70B em INT8 precisa de cerca de 80-100 GB antes do batching, ou seja, no mínimo placas 2x48GB ou 4x24GB.
O KV-cache é o custo oculto. Ele cresce com comprimento de contexto x sequências concorrentes x camadas, então um servidor que acomoda um modelo em contexto 4K pode ficar sem memória em 32K ou com alta concorrência. Planeje a VRAM para o comprimento de contexto p95 e a concorrência alvo, não para o prompt de demonstração. Como regra, implantações otimizadas para inferência deixam 20-30 % de folga de VRAM para que o escalonador possa fazer batching agressivo sem reinícios por OOM.
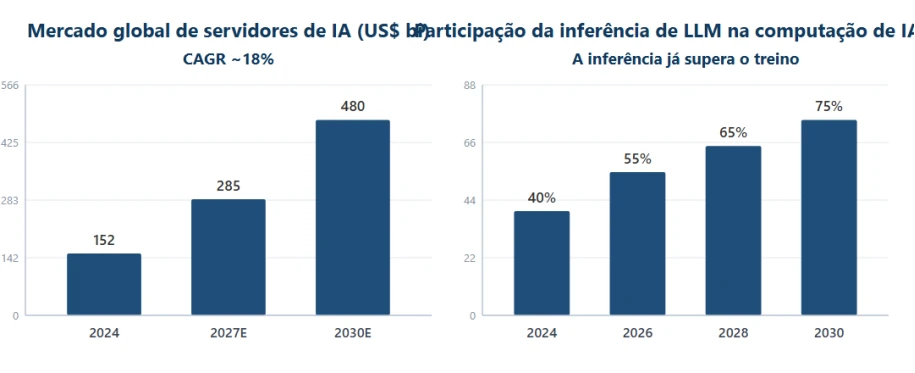
Figura 1: tamanho do mercado de servidores de IA e crescente participação da inferência de LLM (fontes no apêndice)
4U multi-GPU ou chassis de 8 GPU? Topologia, refrigeração e expansão
Resposta rápida: um servidor 4U com 4-5 GPU de largura dupla é o ponto ideal para a maioria das implantações de LLM privado; mude para uma plataforma de 8 GPU NVLink apenas quando um modelo precisar abranger mais de quatro GPU ou você precisar do máximo throughput por nó.
A topologia decide se a inferência multi-GPU escala. A distribuição apenas por PCIe basta para modelos pequenos e serviço em paralelismo de dados, mas o serviço em paralelismo de tensores de um modelo 70B+ exige enlaces GPU-GPU de alta largura de banda (NVLink/NVSwitch), ou a interconexão vira o gargalo. A térmica decide se sobrevive: quatro ou cinco placas de largura dupla de 350-700 W em 4U exigem um módulo de ventoinhas de GPU traseiro dedicado e fluxo de ar da frente para trás. Preveja fontes redundantes 3+1 ou 2+2 e confirme que o rack fornece os amperes.
▪ GPU única: ideal para protótipos 7B-13B e ferramentas internas de baixa concorrência.
▪ 2-4 GPU num 4U: melhor equilíbrio de capacidade, redundância e energia para modelos 32B-70B.
▪ Nó de 8 GPU NVLink: para serviço em paralelismo de tensores 70B+, APIs multi-inquilino ou frotas de agentes.
▪ Verifique sempre a alocação de lanes PCIe e o espaço da ventoinha traseira antes de comprar.
Cenários de inferência de LLM vs configuração de servidor GPU (2026)
A tabela abaixo mapeia cargas típicas de inferência para um envelope inicial de hardware. Trate-a como base de dimensionamento e refine com os tokens por segundo medidos no seu próprio mix de prompts.
Cenário | Modelo e concorrência | Configuração de GPU | VRAM alvo | Plataforma recomendada |
Protótipo / desenvolvedor único | 7B-13B, 1-3 usuários | 1 GPU de largura dupla | 24-48 GB | Estação GPU 1U/2U |
Inferência de equipe | 7B-32B, 5-20 usuários | 1-2 GPU de largura dupla | 48-96 GB | Servidor GPU 2U |
LLM departamental | 70B (INT8), 20-50 usuários | 2-4 GPU | 96-160 GB | Servidor 4U de 4 GPU |
Serviço empresarial | 70B-180B, 50-200 usuários | 4-8 GPU + NVLink | 160-640 GB | Nó 4U/8 GPU NVLink |
Multi-inquilino / agentes | Qualquer, 200+ usuários | 8 GPU de data center | 640 GB+ | 8 GPU HGX / cluster |
Tabela 1: cargas de inferência de LLM vs configurações de servidor GPU (2026)
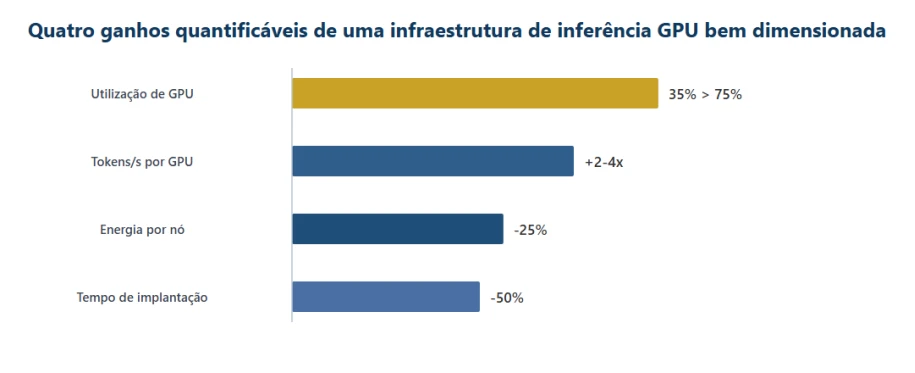
Figura 2: quatro ganhos quantificáveis de uma infraestrutura de inferência GPU bem dimensionada (ilustrativo, fontes no apêndice)
Energia, refrigeração e a sala que você esqueceu de orçar
Resposta rápida: servidores GPU densos transformam um rack num aquecedor. Um nó 4U com quatro GPU de 600 W, mais CPUs e ventoinhas, pode consumir 3-4 kW; nós de 8 GPU passam de 8-10 kW. Confirme que PDU, circuito e refrigeração suportam isso antes de o hardware chegar.
A direção do fluxo de ar, o confinamento de corredores quentes e a temperatura ambiente determinam se as GPU vão reduzir frequência sob carga sustentada de inferência. Se a sua instalação não suporta racks de alta densidade, um nó 4U/4 GPU com energia moderada costuma ser mais confiável do que um monstro teórico de 8 GPU que sofre throttling térmico. O ruído é a outra restrição esquecida: os módulos de ventoinhas traseiros de GPU são barulhentos, então planeje a posição longe das pessoas.
Servidores GPU ChangFan: uma plataforma completa feita para inferência de IA
A IA industrial é 70 % carga de trabalho e 30 % hardware, mas os 30 % errados podem anular os 70 %. A Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) fabrica servidores GPU em rack projetados para inferência contínua: plataformas 4U com até 5 GPU de largura dupla em dual Intel Xeon Scalable (1ª-5ª geração) com até 4 TB de memória DDR4/DDR5 ECC, variantes single-socket AMD EPYC 7002/7003/8004 com 4 GPU de largura dupla e chassis de 24 baias com NVMe opcional para armazenar modelos. Cada unidade inclui módulo de ventoinhas de GPU traseiro dedicado, alimentação redundante 1+1 ou 2+2, rede Gigabit integrada, expansão PCIe e gestão remota IPMI.
Se você está avaliando um LLM privado, uma API de inferência ou uma frota de agentes, contate a ChangFan para uma recomendação de configuração completa dimensionada por tamanho de modelo x concorrência x energia no rack (apenas hardware, sem assinatura de software). A personalização OEM/ODM é suportada para integradores e marcas.
Perguntas frequentes (FAQ)
P1: Quantas GPU um modelo 7B precisa para inferência?
R: Uma única placa de 24 GB roda um modelo 7B em INT8; para FP16 e concorrência moderada, uma placa de 48 GB ou duas de 24 GB dão folga confortável. A VRAM, não os FLOPS, é a primeira restrição.
P2: Devo usar placas RTX de consumo ou GPU de data center?
R: As placas de consumo ganham em preço por GB para protótipos e ferramentas internas de baixa concorrência; as GPU de data center ganham em largura de banda de memória, NVLink, ECC e confiabilidade 24/7. Escolha por SLA e concorrência, não por pico de FLOPS.
P3: Um servidor 4U de 4 GPU basta para um modelo 70B?
R: Para serviço INT8 com concorrência moderada, sim: 4x48 GB (192 GB) acomodam com folga um modelo 70B INT8 mais o KV-cache. Para FP16, alta concorrência ou modelos 180B, mude para um nó de 8 GPU NVLink.
P4: Mais VRAM significa sempre inferência mais rápida?
R: Não. Tokens por segundo dependem de largura de banda de memória, tamanho do lote e interconexão. Mais capacidade evita OOM e permite lotes maiores, mas largura de banda e topologia decidem o throughput.
P5: Posso adicionar GPU a um servidor 2U padrão depois?
R: Normalmente não com segurança: servidores padrão não têm cabeamento de energia para GPU, módulos de ventoinhas traseiros nem alocação de lanes PCIe para placas de largura dupla. Compre desde o início um chassis projetado para GPU.
- Artigo anterior Expansão da Edge AI em 2026: De Orin a Thor, Como a Changfan Garante a Base de Computação para a "IA Física" (Physical AI)
- Próximo artigo não há mais nenhum