2026년 LLM 추론용 GPU 서버 선택 가이드: VRAM, 토폴로지, 냉각
- 광저우 창판 지능형 기술 유한회사
- 2026-10-23
서론: 추론, AI 청구서가 실제로 발생하는 곳
2026년 AI 논의는 학습에서 추론으로 옮겨갔습니다. 프론티어 모델 학습은 일회성 자본 지출이지만, 이를 사용자에게 제공하는 것은 영구적인 운영 비용입니다. 업계 추정에 따르면 AI 서버 지출은 가파른 곡선을 그리고 있으며, 학습이 아닌 추론에 할당되는 컴퓨트 비중은 이미 배포된 GPU 시간의 다수를 차지합니다. 대부분 기업에서 실질적인 질문은 '어느 GPU가 가장 빠른가'가 아니라 '내 동시성·모델 크기·랙 전력 예산에서 백만 토큰당 비용을 낮게 유지하는 GPU 서버는 무엇인가'입니다. 이 가이드는 수치로 답합니다.
LLM 추론이 실제로 소비하는 것은 무엇인가?
빠른 답: 추론은 메모리 대역폭 제약을 받지, 연산 제약을 받지 않습니다. 각 토큰을 생성하려면 모델 가중치와 KV 캐시를 GPU를 통해 스트리밍해야 하므로 초당 토큰 수는 순수 TFLOPS보다 메모리 대역폭과 배치 크기에 훨씬 더 비례합니다.
두 단계가 중요합니다. Prefill은 전체 프롬프트를 병렬로 처리하며 연산 집약적이고, decode는 출력 토큰을 하나씩 생성하며 메모리 대역폭 집약적입니다. 따라서 긴 프롬프트와 긴 출력은 서로 다른 자원을 압박합니다. 그래서 TFLOPS는 크지만 VRAM이 작고 대역폭이 좁은 카드는 실제 채팅 부하에서 대역폭이 더 넓은 '느린' 카드에 질 수 있습니다. 서버 규모를 정할 때는 사양서의 피크 FLOPS만이 아니라 VRAM 용량·VRAM 대역폭·NVLink/PCIe 토폴로지를 함께 보십시오.
7B·13B·70B·180B 모델에 VRAM은 얼마나 필요한가?
빠른 답: FP16에서 매개변수당 약 2바이트, INT8에서 1바이트, INT4에서 0.5바이트를 잡고 KV 캐시와 런타임 오버헤드로 15~30%를 추가하십시오. 단일 70B 모델을 INT8로 쓰려면 배치 전 약 80~100GB가 필요하므로 최소 2×48GB 또는 4×24GB 카드가 필요합니다.
KV 캐시는 숨겨진 비용입니다. 컨텍스트 길이 × 동시 시퀀스 수 × 레이어 수에 따라 커지므로, 4K 컨텍스트에서 모델이 들어가는 서버도 32K나 높은 동시성에서는 메모리가 부족해질 수 있습니다. 데모 프롬프트가 아니라 p95 컨텍스트 길이와 목표 동시성을 기준으로 VRAM을 계획하십시오. 경험적으로 추론 최적화 배포는 OOM 재시작 없이 공격적으로 배치할 수 있도록 VRAM의 20~30%를 여유분으로 둡니다.
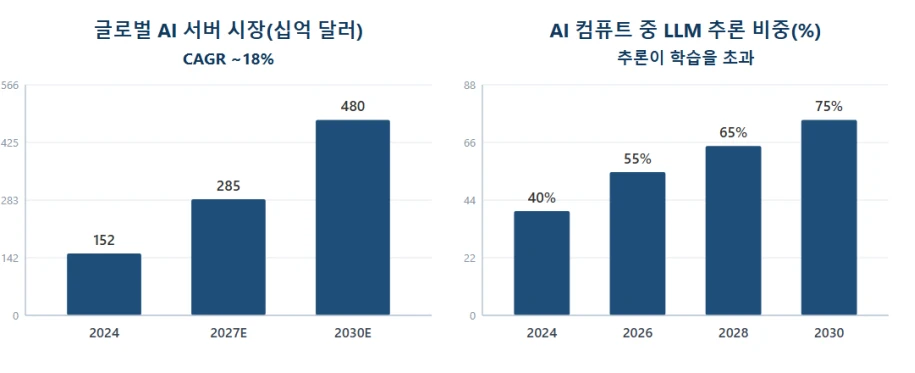
그림 1: AI 서버 시장 규모와 LLM 추론 점유율 상승 (출처는 부록)
4U 멀티 GPU 또는 8-GPU 섀시? 토폴로지, 냉각, 확장
빠른 답: 대부분의 프라이빗 LLM 배포에서 4~5개의 듀얼 폭 GPU를 갖춘 단일 4U 서버가 가장 효율적입니다. 하나의 모델이 4개 이상의 GPU에 걸쳐야 하거나 노드당 최대 처리량이 필요할 때만 8-GPU NVLink 플랫폼으로 넘어가십시오.
토폴로지는 멀티 GPU 추론이 확장되는지 결정합니다. PCIe 전용 팬아웃은 작은 모델과 데이터 병렬 서비스에 충분하지만, 70B+ 모델의 텐서 병렬 서비스에는 고대역폭 GPU 간 연결(NVLink/NVSwitch)이 필요하며, 그렇지 않으면 상호 연결이 병목이 됩니다. 열 관리는 생존 여부를 결정합니다. 4U에서 350~700W 듀얼 폭 카드 4~5개는 전용 후면 GPU 팬 모듈과 전면-후면 공기 흐름이 필요합니다. 3+1 또는 2+2 예비 전원을 계획하고 랙이 필요한 전류를 공급할 수 있는지 확인하십시오.
▪ 단일 GPU: 7B~13B 프로토타입과 낮은 동시성 내부 도구에 가장 적합.
▪ 단일 4U의 2~4 GPU: 32B~70B 모델의 용량·중복성·전력 균형이 가장 좋음.
▪ 8-GPU NVLink 노드: 70B+ 텐서 병렬 서비스, 멀티 테넌트 API, 에이전트 군집용.
▪ 구매 전 반드시 PCIe 레인 할당과 후면 팬 클리어런스를 확인하십시오.
LLM 추론 시나리오 대 GPU 서버 구성 (2026)
아래 표는 전형적인 추론 워크로드를 시작 하드웨어 범위에 매핑합니다. 이를 규모 산정 기준으로 삼고, 직접 프롬프트 믹스에서 측정한 초당 토큰 수로 정교화하십시오.
시나리오 | 모델 및 동시성 | GPU 구성 | VRAM 목표 | 권장 플랫폼 |
프로토타입 / 단일 개발자 | 7B~13B, 사용자 1~3명 | 듀얼 폭 GPU 1개 | 24~48GB | 1U/2U GPU 워크스테이션 |
팀 추론 | 7B~32B, 사용자 5~20명 | 듀얼 폭 GPU 1~2개 | 48~96GB | 2U GPU 서버 |
부서 LLM | 70B(INT8), 사용자 20~50명 | GPU 2~4개 | 96~160GB | 4U 4-GPU 서버 |
기업 서비스 | 70B~180B, 사용자 50~200명 | GPU 4~8개 + NVLink | 160~640GB | 4U/8-GPU NVLink 노드 |
멀티 테넌트 / 에이전트 | 모든 모델, 사용자 200명+ | 데이터센터 GPU 8개 | 640GB+ | 8-GPU HGX / 클러스터 |
표 1: LLM 추론 워크로드 대 GPU 서버 구성 (2026)
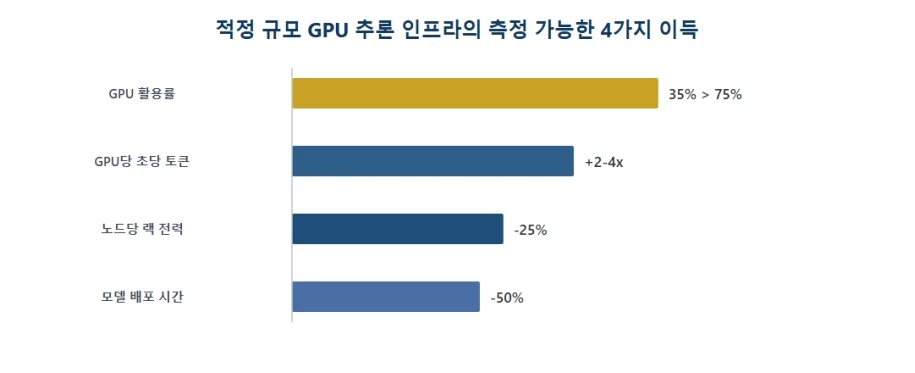
그림 2: 적정 규모 GPU 추론 인프라의 측정 가능한 4가지 이득 (예시, 출처는 부록)
전력, 냉각, 그리고 예산에 잊힌 공간
빠른 답: 고밀도 GPU 서버는 랙을 난로로 만듭니다. 600W GPU 4개와 CPU·팬이 있는 4U 노드는 3~4kW를 소비할 수 있고, 8-GPU 노드는 8~10kW를 넘깁니다. 하드웨어가 도착하기 전에 PDU·회로·냉각이 감당되는지 확인하십시오.
공기 흐름 방향, 핫 아이슬 격리, 주변 온도는 지속 추론 부하에서 GPU가 스로틀되는지 결정합니다. 시설이 고밀도 랙을 지원하지 못하면 4U/4-GPU 중간 전력 노드가 열로 스로틀되는 8-GPU 괴물보다 신뢰할 수 있는 경우가 많습니다. 소음은 또 다른 잊힌 제약입니다. 후면 GPU 팬 모듈은 시끄러우므로 사람과 떨어진 곳에 배치하십시오.
ChangFan GPU 서버: AI 추론을 위해 설계된 풀시스템 플랫폼
산업용 AI는 70% 워크로드와 30% 하드웨어이지만, 잘못된 30%가 70%를 무효화할 수 있습니다. 광저우 창판 지능기술 유한공사(ChangFan)는 지속 추론을 위해 설계된 랙마운트 GPU 서버를 제조합니다. 듀얼 Intel Xeon Scalable(1~5세대)에 최대 5개 듀얼 폭 GPU, 최대 4TB DDR4/DDR5 ECC 메모리를 지원하는 4U 플랫폼, 단일 소켓 AMD EPYC 7002/7003/8004 변형에 듀얼 폭 GPU 4개, 그리고 선택적 NVMe 모델 저장장치를 갖춘 24베이 섀시가 있습니다. 모든 장치에는 전용 후면 GPU 팬 모듈, 1+1 또는 2+2 예비 전원, 온보드 기가비트 네트워킹, PCIe 확장, IPMI 원격 관리가 포함됩니다.
프라이빗 LLM, 추론 API, 에이전트 군집을 검토 중이라면 모델 크기 × 동시성 × 랙 전력으로 규모가 정해지는 풀시스템 구성 추천을 위해 ChangFan에 문의하십시오(하드웨어만, 소프트웨어 구독 없음). 통합업체와 브랜드를 위한 OEM/ODM 맞춤화를 지원합니다.
자주 묻는 질문 (FAQ)
Q1: 7B 모델 추론에 GPU는 몇 개 필요한가?
A: 24GB 카드 하나면 7B 모델을 INT8로 구동할 수 있습니다. FP16과 중간 동시성에서는 48GB 카드 하나나 24GB 카드 두 개가 넉넉한 여유를 제공합니다. 첫 제약은 FLOPS가 아닌 VRAM입니다.
Q2: 추론에 소비자용 RTX 카드와 데이터센터 GPU 중 무엇을 써야 하나?
A: 소비자 카드는 프로토타입과 낮은 동시성 내부 도구에서 GB당 가격 면에서 유리합니다. 데이터센터 GPU는 메모리 대역폭·NVLink·ECC·24/7 신뢰성 면에서 유리합니다. 피크 FLOPS가 아닌 SLA와 동시성으로 선택하십시오.
Q3: 4U 4-GPU 서버로 70B 모델이 충분한가?
A: 중간 동시성 INT8 서비스라면 충분합니다. 4×48GB(192GB)면 70B INT8 모델과 KV 캐시를 편안히 담습니다. FP16, 높은 동시성, 180B 모델은 8-GPU NVLink 노드로 넘어가십시오.
Q4: VRAM이 클수록 항상 추론이 빨라지나?
A: 아닙니다. 초당 토큰 수는 메모리 대역폭·배치 크기·상호 연결에 달려 있습니다. 추가 용량은 OOM을 막고 더 큰 배치를 가능하게 하지만, 처리량은 대역폭과 토폴로지가 결정합니다.
Q5: 나중에 표준 2U 서버에 GPU를 추가할 수 있나?
A: 보통 안전하지 않습니다. 표준 서버는 듀얼 폭 카드용 GPU 전원 케이블·후면 팬 모듈·PCIe 레인 할당이 없습니다. 처음부터 GPU용 섀시를 사십시오.