Cómo elegir un servidor GPU para inferencia LLM en 2026: VRAM, topología y refrigeración
Introducción: la inferencia es donde realmente llega la factura de la IA
En 2026 la conversación sobre IA ha pasado del entrenamiento a la inferencia. Entrenar un modelo de frontera es una inversión puntual; servirlo a los usuarios es un coste operativo permanente. Las estimaciones sitúan el gasto en servidores de IA en una curva pronunciada, y la parte de cómputo dedicada a inferencia en lugar de entrenamiento ya representa la mayoría de las horas GPU desplegadas. Para la mayoría de las empresas la pregunta ya no es «qué GPU es la más rápida» sino «qué servidor GPU mantiene bajo el coste por millón de tokens con mi concurrencia, tamaño de modelo y presupuesto de potencia en rack». Esta guía lo responde con números.
¿Qué consume realmente la inferencia LLM?
Respuesta rápida: la inferencia está limitada por el ancho de banda de memoria, no por el cómputo. Generar cada token obliga a transferir los pesos del modelo y el KV-cache a través de la GPU, así que los tokens por segundo escalan mucho más con el ancho de banda de memoria y el tamaño de lote que con los TFLOPS brutos.
Importan dos fases. El prefill procesa todo el prompt en paralelo y es intensivo en cómputo; el decode genera la salida token a token y es intensivo en ancho de banda de memoria. Por eso los prompts largos y las salidas largas estresan recursos distintos. Es la razón de que una tarjeta con TFLOPS enormes pero poca VRAM y ancho de banda estrecho pueda perder frente a una tarjeta «más lenta» con más ancho de banda en cargas reales de chat. Al dimensionar un servidor, observe juntos la capacidad de VRAM, el ancho de banda de VRAM y la topología NVLink/PCIe, no solo el pico de FLOPS de la ficha técnica.
¿Cuánta VRAM necesitan los modelos 7B, 13B, 70B y 180B?
Respuesta rápida: calcule unos 2 bytes por parámetro en FP16, 1 byte en INT8 y 0,5 bytes en INT4, y añada un 15-30 % para el KV-cache y la sobrecarga de ejecución. Un modelo de 70B en INT8 necesita unos 80-100 GB antes del batching, es decir, al menos tarjetas 2x48GB o 4x24GB.
El KV-cache es el coste oculto. Crece con la longitud de contexto x secuencias concurrentes x capas, así que un servidor que aloja un modelo a 4K de contexto puede quedarse sin memoria a 32K o con alta concurrencia. Planifique la VRAM para la longitud de contexto p95 y la concurrencia objetivo, no para el prompt de demostración. Como regla general, los despliegues optimizados para inferencia dejan un 20-30 % de margen de VRAM para que el planificador pueda agrupar de forma agresiva sin reinicios por OOM.
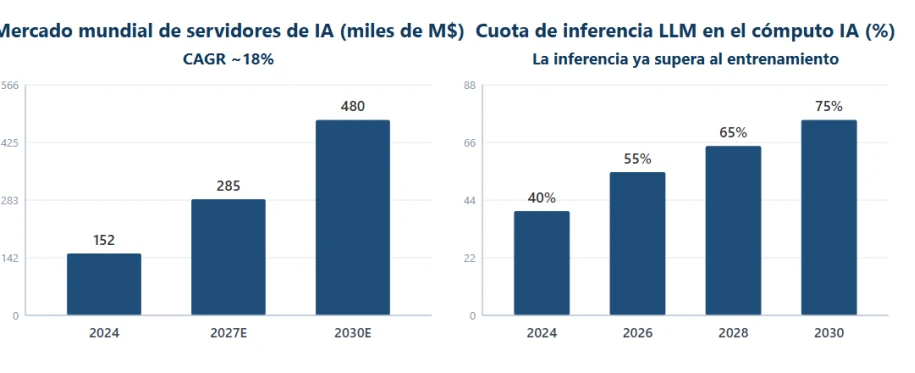
Figura 1: tamaño del mercado de servidores de IA y creciente cuota de la inferencia LLM (fuentes en el apéndice)
¿4U multi-GPU o chasis de 8 GPU? Topología, refrigeración y expansión
Respuesta rápida: un servidor 4U con 4-5 GPU de doble ancho es el punto óptimo para la mayoría de despliegues LLM privados; pase a una plataforma de 8 GPU NVLink solo cuando un modelo deba abarcar más de cuatro GPU o necesite el máximo rendimiento por nodo.
La topología decide si la inferencia multi-GPU escala. La distribución solo por PCIe basta para modelos pequeños y servicio en paralelismo de datos, pero el servicio en paralelismo de tensores de un modelo 70B+ exige enlaces GPU-GPU de alto ancho de banda (NVLink/NVSwitch), o la interconexión se convierte en el cuello de botella. La refrigeración decide si sobrevive: cuatro o cinco tarjetas de doble ancho de 350-700 W en 4U requieren un módulo de ventiladores GPU trasero dedicado y flujo de aire de delante hacia atrás. Prevea fuentes redundantes 3+1 o 2+2 y confirme que el rack entrega los amperios.
▪ GPU única: ideal para prototipos 7B-13B y herramientas internas de baja concurrencia.
▪ 2-4 GPU en un 4U: mejor equilibrio de capacidad, redundancia y potencia para modelos 32B-70B.
▪ Nodo de 8 GPU NVLink: para servicio en paralelismo de tensores 70B+, API multiinquilino o flotas de agentes.
▪ Verifique siempre la asignación de líneas PCIe y el espacio del ventilador trasero antes de comprar.
Escenarios de inferencia LLM frente a configuración de servidor GPU (2026)
La tabla siguiente asigna cargas de inferencia típicas a un envolvente de hardware inicial. Úsela como base de dimensionamiento y luego ajústela con los tokens por segundo medidos en su propia mezcla de prompts.
Escenario | Modelo y concurrencia | Configuración GPU | VRAM objetivo | Plataforma recomendada |
Prototipo / desarrollador único | 7B-13B, 1-3 usuarios | 1 GPU de doble ancho | 24-48 GB | Estación GPU 1U/2U |
Inferencia de equipo | 7B-32B, 5-20 usuarios | 1-2 GPU de doble ancho | 48-96 GB | Servidor GPU 2U |
LLM departamental | 70B (INT8), 20-50 usuarios | 2-4 GPU | 96-160 GB | Servidor 4U de 4 GPU |
Servicio empresarial | 70B-180B, 50-200 usuarios | 4-8 GPU + NVLink | 160-640 GB | Nodo 4U/8 GPU NVLink |
Multiinquilino / agentes | Cualquiera, 200+ usuarios | 8 GPU de centro de datos | 640 GB+ | 8 GPU HGX / clúster |
Tabla 1: cargas de inferencia LLM frente a configuraciones de servidor GPU (2026)
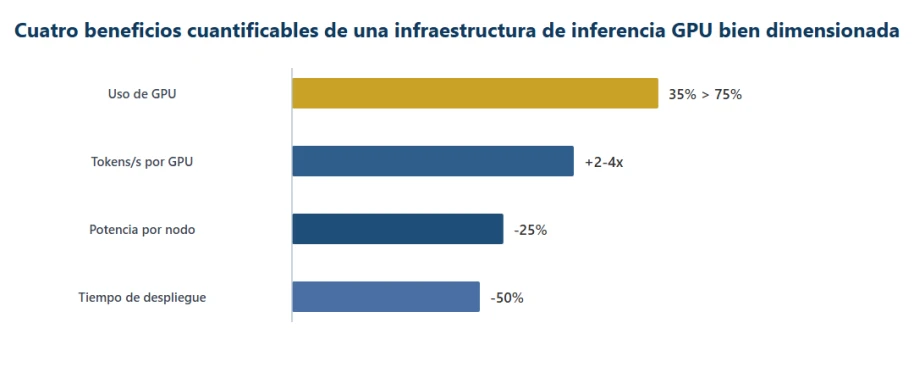
Figura 2: cuatro beneficios cuantificables de una infraestructura de inferencia GPU bien dimensionada (ilustrativo, fuentes en el apéndice)
Potencia, refrigeración y la sala que olvidó presupuestar
Respuesta rápida: los servidores GPU densos convierten un rack en un radiador. Un nodo 4U con cuatro GPU de 600 W, más CPU y ventiladores, puede consumir 3-4 kW; los nodos de 8 GPU superan los 8-10 kW. Confirme que su PDU, circuito y refrigeración lo soportan antes de que llegue el hardware.
La dirección del flujo de aire, el confinamiento de pasillos calientes y la temperatura ambiente determinan si las GPU bajan de frecuencia bajo carga sostenida de inferencia. Si su instalación no soporta racks de alta densidad, un nodo 4U/4 GPU a potencia moderada suele ser más fiable que un monstruo teórico de 8 GPU que se ahoga térmicamente. El ruido es la otra restricción olvidada: los módulos de ventiladores GPU traseros son ruidosos, así que planifique su ubicación lejos de las personas.
Servidores GPU ChangFan: una plataforma completa diseñada para la inferencia IA
La IA industrial es 70 % carga de trabajo y 30 % hardware, pero el 30 % equivocado puede borrar el 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) fabrica servidores GPU en rack diseñados para inferencia sostenida: plataformas 4U con hasta 5 GPU de doble ancho sobre doble Intel Xeon Scalable (1.ª-5.ª gen.), hasta 4 TB de memoria DDR4/DDR5 ECC; variantes monoprocesador AMD EPYC 7002/7003/8004 con 4 GPU de doble ancho; chasis de 24 bahías con NVMe opcional para almacenar modelos. Cada unidad incluye un módulo de ventiladores GPU trasero dedicado, alimentación redundante 1+1 o 2+2, red Gigabit integrada, expansión PCIe y gestión remota IPMI.
Si está evaluando un LLM privado, una API de inferencia o una flota de agentes, contacte con ChangFan para una recomendación de configuración completa dimensionada por tamaño de modelo x concurrencia x potencia de rack (solo hardware, sin suscripción de software). Se admite personalización OEM/ODM para integradores y marcas.
Preguntas frecuentes (FAQ)
P1: ¿Cuántas GPU necesita un modelo 7B para inferencia?
R: Una sola tarjeta de 24 GB ejecuta un modelo 7B en INT8; para FP16 y concurrencia moderada, una tarjeta de 48 GB o dos de 24 GB dan margen cómodo. La VRAM, no los FLOPS, es la primera restricción.
P2: ¿Debo usar tarjetas RTX de consumo o GPU de centro de datos?
R: Las tarjetas de consumo ganan en precio por GB para prototipos y herramientas internas de baja concurrencia; las GPU de centro de datos ganan en ancho de banda de memoria, NVLink, ECC y fiabilidad 24/7. Elija por SLA y concurrencia, no por pico de FLOPS.
P3: ¿Basta un servidor 4U de 4 GPU para un modelo 70B?
R: Para servicio INT8 con concurrencia moderada, sí: 4x48 GB (192 GB) albergan cómodamente un modelo 70B INT8 más el KV-cache. Para FP16, alta concurrencia o modelos 180B, pase a un nodo de 8 GPU NVLink.
P4: ¿Más VRAM significa siempre inferencia más rápida?
R: No. Los tokens por segundo dependen del ancho de banda de memoria, el tamaño de lote y la interconexión. Más capacidad evita OOM y permite lotes mayores, pero el ancho de banda y la topología deciden el rendimiento.
P5: ¿Puedo añadir GPU a un servidor 2U estándar más adelante?
R: Normalmente no de forma segura: los servidores estándar carecen de cableado de alimentación GPU, módulos de ventiladores traseros y asignación de líneas PCIe para tarjetas de doble ancho. Compre desde el primer día un chasis diseñado para GPU.
- Artículo anterior El despliegue de la IA en el borde en 2026: De Orin a Thor, cómo Changfan asegura la base de computación para la "IA Física" (Physical AI)
- Artículo siguiente No hay más