Så väljer du en GPU-server för LLM-inferens 2026: VRAM, topologi och kylning
Introduktion: Inferens är där AI-räkningen faktiskt landar
2026 har AI-samtalet flyttat från träning till inferens. Att träna en frontier-modell är en engångskapitalhändelse; att servera den till användare är en permanent driftskostnad. Branschuppskattningar lägger AI-serverutgifter på en brant kurva, och andelen beräkning som ägnas åt inferens i stället för träning är nu majoriteten av distribuerade GPU-timmar. För de flesta företag är den praktiska frågan inte längre 'vilken GPU är snabbast' utan 'vilken GPU-server håller kostnaden per miljon tokens låg vid min samtidighet, modellstorlek och rack-effektbudget'. Denna guide svarar med siffror.
Vad förbrukar LLM-inferens egentligen?
Snabbt svar: inferens begränsas av minnesbandbredd, inte beräkning. Att generera varje token innebär att strömma modellvikterna och KV-cachen genom GPU:n, så tokens per sekund skalar mycket mer med minnesbandbredd och batchstorlek än med råa TFLOPS.
Två faser spelar roll. Prefill bearbetar hela prompten parallellt och är beräkningstung; decode genererar utdata token för token och är minnesbandbreddstung. Långa prompts och långa utdata belastar alltså olika resurser. Därför kan ett kort med enorma TFLOPS men liten VRAM och smal bandbredd förlora mot ett 'långsammare' kort med mer minnesbandbredd under verklig chattbelastning. När du dimensionerar en server, titta på VRAM-kapacitet, VRAM-bandbredd och NVLink/PCIe-topologi tillsammans, inte bara topp-FLOPS från databladet.
Hur mycket VRAM behöver du för 7B-, 13B-, 70B- och 180B-modeller?
Snabbt svar: räkna med ungefär 2 byte per parameter i FP16, 1 byte i INT8 och 0,5 byte i INT4, och lägg sedan till 15-30% för KV-cachen och körningens overhead. En enda 70B-modell i INT8 behöver cirka 80-100 GB före batching, alltså minst 2×48GB eller 4×24GB-kort.
KV-cachen är den dolda kostnaden. Den växer med kontextlängd × samtidiga sekvenser × lager, så en server som får plats med en modell vid 4K-kontext kan få slut på minne vid 32K eller hög samtidighet. Planera VRAM för p95-kontextlängd och målsamtidighet, inte demoprompten. Som tumregel lämnar inferensoptimerade distributioner 20-30% VRAM-utrymme så att schemaläggaren kan batcha aggressivt utan omstarter på grund av minnesfel.
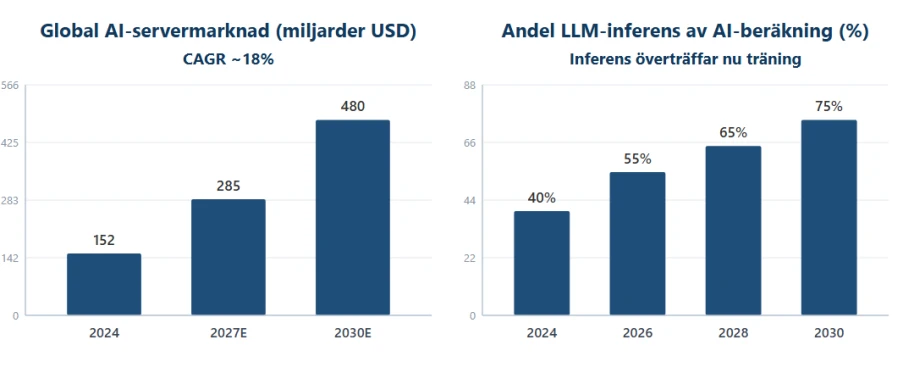
Figur 1: AI-servermarknadens storlek och det växande inferensandelen av LLM (källor i bilagan)
4U multi-GPU eller 8-GPU-chassi? Topologi, kylning och expansion
Snabbt svar: en enda 4U-server med 4-5 dubbelbreda GPU:er är sötpunkten för de flesta privata LLM-distributioner; gå över till en 8-GPU NVLink-plattform bara när en modell måste spänna över fler än fyra GPU:er eller du behöver maximalt genomflöde per nod.
Topologin avgör om multi-GPU-inferens skalar. Ren PCIe-utgrenning räcker för små modeller och data-parallel servering, men tensor-parallel servering av en 70B+-modell kräver GPU-till-GPU-länkar med hög bandbredd (NVLink/NVSwitch), annars blir interconnecten flaskhalsen. Termiken avgör om det överlever: fyra eller fem 350-700W dubbelbreda kort i 4U kräver en dedikerad bakre GPU-fläktmodul och luftflöde framifrån och bak. Planera 3+1- eller 2+2-redundanta nätaggregat och bekräfta att racket levererar amperena.
▪ En GPU: bäst för 7B-13B-prototyper och interna verktyg med låg samtidighet.
▪ 2-4 GPU:er i en 4U: bästa balansen av kapacitet, redundans och effekt för 32B-70B-modeller.
▪ 8-GPU NVLink-nod: för 70B+ tensor-parallel servering, multi-tenant API:er eller agentflottor.
▪ Kontrollera alltid PCIe-banfördelning och bakre fläktavstånd före köp.
LLM-inferensscenarier mot GPU-serverkonfiguration (2026)
Tabellen nedan kopplar typiska inferensarbetsbelastningar till en startram för hårdvara. Använd den som en dimensioneringsbaslinje och förfina sedan med uppmätta tokens per sekund på din egen promptmix.
Scenario | Modell och samtidighet | GPU-konfiguration | VRAM-mål | Rekommenderad plattform |
Prototyp / enskild utvecklare | 7B-13B, 1-3 användare | 1x dubbelbred GPU | 24-48 GB | 1U/2U GPU-arbetsstation |
Team-inferens | 7B-32B, 5-20 användare | 1-2x dubbelbred GPU | 48-96 GB | 2U GPU-server |
Avdelnings-LLM | 70B (INT8), 20-50 användare | 2-4x GPU | 96-160 GB | 4U 4-GPU-server |
Företagsservering | 70B-180B, 50-200 användare | 4-8x GPU + NVLink | 160-640 GB | 4U/8-GPU NVLink-nod |
Multi-tenant / agenter | Vilken som helst, 200+ användare | 8x datacenter-GPU | 640 GB+ | 8-GPU HGX / kluster |
Tabell 1: LLM-inferensarbetsbelastningar mot GPU-serverkonfigurationer (2026)
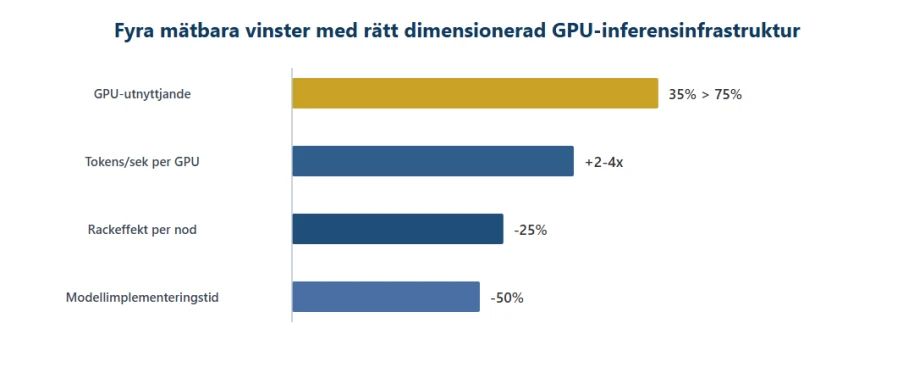
Figur 2: Fyra mätbara vinster med rätt dimensionerad GPU-inferensinfrastruktur (illustrativt, källor i bilagan)
Effekt, kylning och rummet du glömde budgetera
Snabbt svar: täta GPU-servrar förvandlar ett rack till en element. En 4U-nod med fyra 600W-GPU:er plus CPU:er och fläktar kan dra 3-4 kW; åtta-GPU-noder passerar 8-10 kW. Bekräfta att din PDU, krets och kylning klarar det innan hårdvaran anländer.
Luftflödesriktning, varmgångsavskiljning och omgivningstemperatur påverkar alla om GPU:er throttlar under ihållande inferensbelastning. Om din anläggning inte stöder högdensitetsrack är en 4U/4-GPU-nod med måttlig effekt ofta mer pålitlig än ett teoretiskt 8-GPU-monster som throttlar termiskt. Buller är den andra bortglömda begränsningen: bakre GPU-fläktmoduler är högljudda, så planera placeringen bort från människor.
ChangFan GPU-servrar: en helsystemplattform byggd för AI-inferens
Industriell AI är 70% arbetsbelastning och 30% hårdvara, men fel 30% kan radera 70%. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) tillverkar rackmonterade GPU-servrar konstruerade för ihållande inferens: 4U-plattformar som stöder upp till 5 dubbelbreda GPU:er på dubbla Intel Xeon Scalable (1:a-5:e generationen) med upp till 4TB DDR4/DDR5 ECC-minne, ensocket AMD EPYC 7002/7003/8004-varianter med 4 dubbelbreda GPU:er, och 24-bays chassi med valfritt NVMe för modelllagring. Varje enhet levereras med en dedikerad bakre GPU-fläktmodul, 1+1- eller 2+2-redundant strömförsörjning, inbyggt Gigabit-nätverk, PCIe-expansion och IPMI-fjärrhantering.
Om du utvärderar en privat LLM, ett inferens-API eller en agentflotta, kontakta ChangFan för ett helsystemkonfigurationsförslag dimensionerat efter modellstorlek × samtidighet × rack-effekt (endast hårdvara, ingen mjukvaruprenumeration). OEM/ODM-anpassning stöds för integratörer och varumärken.
Vanliga frågor (FAQ)
F1: Hur många GPU:er behöver en 7B-modell för inferens?
A: Ett enda 24GB-kort kör en 7B-modell i INT8; för FP16 och måttlig samtidighet ger ett 48GB-kort eller två 24GB-kort bekvämt utrymme. Första begränsningen är VRAM, inte FLOPS.
F2: Ska jag använda konsument-RTX-kort eller datacenter-GPU:er för inferens?
A: Konsumentkort vinner på pris per GB för prototyper och interna verktyg med låg samtidighet; datacenter-GPU:er vinner på minnesbandbredd, NVLink, ECC och 24/7-tillförlitlighet. Välj efter SLA och samtidighet, inte efter topp-FLOPS.
F3: Räcker en 4U 4-GPU-server för en 70B-modell?
A: För INT8-servering vid måttlig samtidighet, ja: 4×48GB (192GB) rymmer bekvämt en 70B INT8-modell plus KV-cache. För FP16, hög samtidighet eller 180B-modeller, gå till en 8-GPU NVLink-nod.
F4: Innebär mer VRAM alltid snabbare inferens?
A: Nej. Tokens per sekund beror på minnesbandbredd, batchstorlek och interconnect. Extra kapacitet förhindrar OOM och möjliggör större batcher, men bandbredd och topologi bestämmer genomflödet.
F5: Kan jag lägga till GPU:er i en standard 2U-server senare?
A: Vanligtvis inte säkert: standardservrar saknar GPU-strömkablar, bakre fläktmoduler och PCIe-banfördelning för dubbelbreda kort. Köp ett chassi designat för GPU:er från första dagen.
- Föregående artikel Edge AI:s utbyggnad 2026: Från Orin till Thor – hur Changfan säkrar beräkningsfundamentet för "Fysisk AI" (Physical AI)
- Nästa artikel det finns inga kvar