Cách Chọn Máy Chủ GPU Cho Suy Luận LLM Năm 2026: VRAM, Topology và Tản Nhiệt
Lời Mở Đầu: Hóa Đơn AI Thực Sự Đổ Vào Suy Luận
Năm 2026, cuộc thảo luận về AI đã chuyển từ huấn luyện sang suy luận. Huấn luyện một mô hình tiên tiến là một sự kiện vốn một lần; còn phục vụ nó cho người dùng là một chi phí vận hành vĩnh viễn. Ước tính của ngành cho thấy chi tiêu cho máy chủ AI đang trên đà tăng vọt, và tỷ trọng điện toán dành cho suy luận thay vì huấn luyện giờ đây đã chiếm đa số số giờ GPU được triển khai. Với hầu hết các công ty, câu hỏi thực tế không còn là 'GPU nào nhanh nhất' mà là 'máy chủ GPU nào giữ chi phí mỗi triệu token thấp ở mức đồng thời, quy mô mô hình và ngân sách nguồn rack của tôi'. Cẩm nang này trả lời câu hỏi đó bằng những con số.
Suy Luận LLM Thực Sự Tiêu Thụ Gì?
Câu trả lời nhanh: suy luận bị giới hạn bởi băng thông bộ nhớ, không phải bởi tính toán. Tạo ra mỗi token đồng nghĩa với việc truyền trọng số mô hình và KV cache qua GPU, do đó số token mỗi giây tỷ lệ thuận với băng thông bộ nhớ và kích thước batch hơn là với TFLOPS đỉnh.
Hai giai đoạn quan trọng. Prefill xử lý toàn bộ prompt song song và nặng về tính toán; decode tạo đầu ra từng token một và nặng về băng thông bộ nhớ. Do đó, prompt dài và đầu ra dài gây áp lực lên các tài nguyên khác nhau. Đó là lý do một card có TFLOPS khổng lồ nhưng VRAM nhỏ và băng thông hẹp có thể thua một card 'chậm hơn' với băng thông bộ nhớ lớn hơn trên khối lượng công việc hội thoại thực tế. Khi định cỡ máy chủ, hãy xem xét dung lượng VRAM, băng thông VRAM và topology NVLink/PCIe cùng nhau, chứ không chỉ nhìn FLOPS đỉnh trên bảng thông số.
Bạn Cần Bao Nhiêu VRAM Cho Các Mô Hình 7B, 13B, 70B và 180B?
Câu trả lời nhanh: dự trù khoảng 2 byte mỗi tham số ở FP16, 1 byte ở INT8 và 0,5 byte ở INT4, sau đó cộng thêm 15–30% cho KV cache và chi phí vận hành. Một mô hình 70B đơn ở INT8 cần khoảng 80–100 GB trước khi batching, nghĩa là cần ít nhất 2×48GB hoặc 4×24GB card.
KV cache là chi phí ẩn. Nó tăng theo độ dài ngữ cảnh × số chuỗi đồng thời × số lớp, do đó một máy chủ chứa được mô hình ở ngữ cảnh 4K có thể hết bộ nhớ ở 32K hoặc khi đồng thời cao. Hãy lập kế hoạch VRAM cho độ dài ngữ cảnh p95 và mức đồng thời mục tiêu, không phải theo prompt demo. Theo kinh nghiệm, các triển khai tối ưu suy luận để lại 20–30% dư địa VRAM để bộ lập lịch có thể batch mạnh mẽ mà không gặp khởi động lại do hết bộ nhớ (OOM).
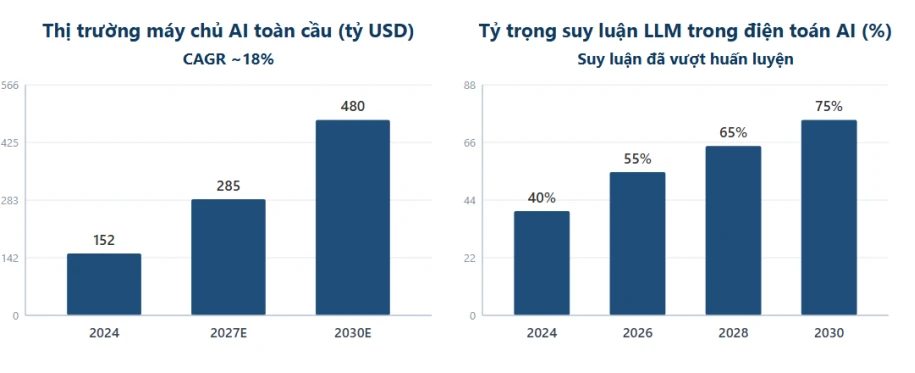
Hình 1: Quy mô thị trường máy chủ AI và tỷ trọng suy luận LLM ngày càng tăng (nguồn dữ liệu xem phụ lục)
Máy Chủ 4U Đa GPU Hay Khung 8-GPU? Topology, Tản Nhiệt và Mở Rộng
Câu trả lời nhanh: một máy chủ 4U với 4–5 GPU hai khe là điểm ngọt cho hầu hết triển khai LLM riêng tư; chỉ chuyển lên nền tảng 8-GPU NVLink khi một mô hình phải trải rộng trên hơn bốn GPU hoặc bạn cần thông lượng tối đa mỗi nút.
Topology quyết định suy luận đa GPU có mở rộng tuyến tính hay không. Phân tán chỉ PCIe thì đủ cho mô hình nhỏ và phục vụ song song dữ liệu, nhưng phục vụ song song tensor của mô hình 70B+ cần liên kết GPU-GPU băng thông cao (NVLink/NVSwitch), nếu không interconnect sẽ thành nút thắt. Nhiệt quyết định nó có sống sót hay không: bốn hoặc năm card hai khe 350–700W trong 4U đòi hỏi module quạt GPU phía sau chuyên dụng và luồng khí trước-sau. Hãy bố trí nguồn dự phòng 3+1 hoặc 2+2 và xác nhận rack cung cấp đủ ampe.
▪ Đơn GPU: tốt nhất cho nguyên mẫu 7B–13B và công cụ nội bộ đồng thời thấp.
▪ 2–4 GPU trong một 4U: cân bằng tốt nhất giữa dung lượng, dự phòng và nguồn cho mô hình 32B–70B.
▪ Nút 8-GPU NVLink: cho phục vụ song song tensor 70B+, API đa thuê bao, hoặc fleet agent.
▪ Luôn xác minh phân bổ lane PCIe và khoảng trống quạt phía sau trước khi mua.
Kịch Bản Suy Luận LLM So Với Cấu Hình Máy Chủ GPU (2026)
Bảng dưới đây ánh xạ các khối lượng công việc suy luận điển hình tới một bao phần cứng khởi điểm. Hãy coi nó là cơ sở định cỡ, sau đó tinh chỉnh theo số token mỗi giây đo được trên hỗn hợp prompt của riêng bạn.
Kịch bản | Mô hình & đồng thời | Cấu hình GPU | Mục tiêu VRAM | Nền tảng đề xuất |
Nguyên mẫu / nhà phát triển đơn | 7B–13B, 1–3 người dùng | 1× GPU hai khe | 24–48 GB | Trạm làm việc GPU 1U/2U |
Suy luận nhóm | 7B–32B, 5–20 người dùng | 1–2× GPU hai khe | 48–96 GB | Máy chủ GPU 2U |
LLM cấp phòng ban | 70B (INT8), 20–50 người dùng | 2–4× GPU | 96–160 GB | Máy chủ 4U 4-GPU |
Phục vụ doanh nghiệp | 70B–180B, 50–200 người dùng | 4–8× GPU + NVLink | 160–640 GB | Nút 4U/8-GPU NVLink |
Đa thuê bao / agent | Bất kỳ, 200+ người dùng | 8× GPU trung tâm dữ liệu | 640 GB+ | HGX 8-GPU / cụm |
Bảng 1: Khối lượng suy luận LLM so với cấu hình máy chủ GPU (2026)
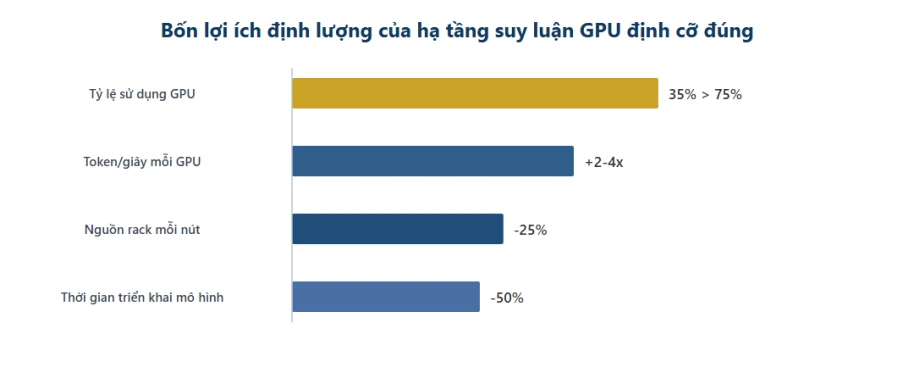
Hình 2: Bốn lợi ích định lượng được của hạ tầng suy luận GPU định cỡ đúng (minh họa, nguồn dữ liệu xem phụ lục)
Nguồn, Tản Nhiệt và Căn Phòng Bạn Quên Lập Ngân Sách
Câu trả lời nhanh: máy chủ GPU dày đặc biến rack thành một máy sưởi. Một nút 4U với bốn GPU 600W cộng CPU và quạt có thể tiêu thụ 3–4 kW; nút tám GPU vượt quá 8–10 kW. Hãy xác nhận PDU, mạch điện và tản nhiệt của bạn chịu tải được trước khi phần cứng đến nơi.
Hướng luồng khí, cách ly lối nóng, và nhiệt độ môi trường đều ảnh hưởng đến việc GPU có bị giảm tốc độ dưới tải suy luận liên tục hay không. Nếu cơ sở của bạn không hỗ trợ rack mật độ cao, một nút 4U/4-GPU ở nguồn vừa phải thường đáng tin cậy hơn một 'quái vật' 8-GPU lý thuyết bị giảm tốc độ nhiệt. Tiếng ồn là ràng buộc bị lãng quên khác: module quạt GPU phía sau rất ồn, nên bố trí xa khu vực có người.
Máy Chủ GPU ChangFan: Nền Tảng Nguyên Khối Được Xây Dựng Cho Suy Luận AI
AI công nghiệp là 70% khối lượng công việc và 30% phần cứng, nhưng 30% sai có thể xóa sạch 70%. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) xây dựng máy chủ GPU rackmount được thiết kế cho suy luận liên tục: nền tảng 4U hỗ trợ tối đa 5 GPU hai khe trên nền tảng lõi kép Intel Xeon Scalable (thế hệ 1–5) với bộ nhớ ECC DDR4/DDR5 lên đến 4TB, các biến thể lõi đơn AMD EPYC 7002/7003/8004 với 4 GPU hai khe, và khung 24 ổ đĩa với tùy chọn NVMe để lưu trữ mô hình. Mỗi thiết bị được trang bị module quạt GPU phía sau chuyên dụng, nguồn dự phòng 1+1 hoặc 2+2, mạng Gigabit tích hợp, mở rộng PCIe, và quản lý từ xa IPMI.
Nếu bạn đang đánh giá một LLM riêng tư, một API suy luận, hay một fleet agent, hãy liên hệ ChangFan để nhận đề xuất cấu hình nguyên khối được định cỡ theo quy mô mô hình × đồng thời × nguồn rack (chỉ phần cứng nguyên khối, không có đăng ký phần mềm). Hỗ trợ tùy chỉnh OEM/ODM cho các nhà tích hợp và thương hiệu.
Các Câu Hỏi Thường Gặp (FAQ)
Q1: Mô hình 7B cần bao nhiêu GPU để suy luận?
A: Một card 24GB chạy mô hình 7B ở INT8; với FP16 và đồng thời vừa phải, một card 48GB hoặc hai card 24GB cho dư địa thoải mái. VRAM, không phải FLOPS, là ràng buộc đầu tiên.
Q2: Nên dùng card RTX tiêu dùng hay GPU trung tâm dữ liệu cho suy luận?
A: Card tiêu dùng thắng về giá mỗi GB cho nguyên mẫu và công cụ nội bộ đồng thời thấp; GPU trung tâm dữ liệu thắng về băng thông bộ nhớ, NVLink, ECC và độ tin cậy 24/7. Chọn theo SLA và đồng thời, không phải theo FLOPS đỉnh.
Q3: Máy chủ 4U 4-GPU có đủ cho mô hình 70B không?
A: Cho dịch vụ INT8 ở đồng thời vừa phải, có: 4×48GB (192GB) chứa thoải mái mô hình 70B INT8 cộng KV cache. Cho FP16, đồng thời cao, hoặc mô hình 180B, hãy chuyển lên nút 8-GPU NVLink.
Q4: VRAM nhiều hơn có luôn đồng nghĩa suy luận nhanh hơn không?
A: Không. Số token mỗi giây phụ thuộc vào băng thông bộ nhớ, kích thước batch và interconnect. Dung lượng thêm ngăn OOM và cho phép batch lớn hơn, nhưng băng thông và topology quyết định thông lượng.
Q5: Tôi có thể thêm GPU vào máy chủ 2U tiêu chuẩn sau này không?
A: Thường là không an toàn: máy chủ tiêu chuẩn thiếu dây nguồn GPU, module quạt phía sau và phân bổ lane PCIe cho card hai khe. Hãy mua khung được thiết kế cho GPU ngay từ đầu.
- Bài viết trước Sự bùng nổ của Edge AI năm 2026: Từ Orin đến Thor, Changfan củng cố nền tảng điện toán cho "AI Vật lý" (Physical AI) như thế nào?
- Bài viết tiếp theo không còn nữa