عنوان ۱: چگونه در سال ۲۰۲۶ یک سرور GPU برای استنتاج LLM انتخاب کنیم: VRAM، توپولوژی و خنکسازی
مقدمه: استنتاج جایی است که صورتحساب هوش مصنوعی واقعاً میرسد
در سال ۲۰۲۶ گفتوگو درباره هوش مصنوعی از آموزش به استنتاج منتقل شده است. آموزش یک مدل پیشرو یک سرمایهگذاری یکباره است؛ اما سرویسدهی آن به کاربران هزینه عملیاتی دائمی است. برآوردها هزینه سرورهای هوش مصنوعی را روی منحنی شیبدار قرار میدهند و سهم محاسباتی که به استنتاج (نه آموزش) اختصاص مییابد اکنون اکثریت ساعتهای GPU مستقر را تشکیل میدهد. برای بیشتر شرکتها پرسش عملی دیگر «کدام GPU سریعتر است» نیست، بلکه «کدام سرور GPU هزینه هر میلیون توکن را در همزمانی، اندازه مدل و بودجه توان رک من پایین نگه میدارد». این راهنما با اعداد پاسخ میدهد.
استنتاج LLM واقعاً چه چیزی مصرف میکند؟
پاسخ کوتاه: استنتاج محدود به پهنای باند حافظه است، نه توان محاسباتی. تولید هر توکن یعنی عبور وزنهای مدل و حافظه KV از GPU، بنابراین توکن بر ثانیه بسیار بیشتر با پهنای باند حافظه و اندازه دسته مقیاس میگیرد تا با TFLOPS خام.
دو فاز مهماند. Prefill کل پرامپت را موازی پردازش میکند و محاسباتبر است؛ Decode خروجی را توکنبهتوکن تولید میکند و پهنایباندبر است. بنابراین پرامپتهای بلند و خروجیهای بلند منابع متفاوتی را تحت فشار میگذارند. به همین دلیل کارتی با TFLOPS بسیار زیاد اما VRAM کم و پهنای باند باریک ممکن است در بارهای واقعی چت به کارتی «کندتر» با پهنای باند بیشتر ببازد. هنگام اندازهگذاری سرور، ظرفیت VRAM، پهنای باند VRAM و توپولوژی NVLink/PCIe را با هم ببینید، نه فقط اوج FLOPS در برگه مشخصات.
چه مقدار VRAM برای مدلهای 7B، 13B، 70B و 180B لازم است؟
پاسخ کوتاه: حدود ۲ بایت بهازای هر پارامتر در FP16، ۱ بایت در INT8 و ۰٫۵ بایت در INT4 در نظر بگیرید، سپس ۱۵-۳۰٪ برای KV-cache و سربار اجرا اضافه کنید. یک مدل 70B در INT8 پیش از بچبندی حدود ۸۰-۱۰۰ گیگابایت نیاز دارد، یعنی حداقل کارتهای 2×48 گیگابایت یا 4×24 گیگابایت.
KV-cache هزینه پنهان است. با طول زمینه × توالیهای همزمان × لایهها رشد میکند؛ بنابراین سروری که مدل را در زمینه 4K جای میدهد ممکن است در 32K یا همزمانی بالا حافظهاش تمام شود. VRAM را برای طول زمینه p95 و همزمانی هدف برنامهریزی کنید، نه برای پرامپت نمایشی. بهطور کلی استقرارهای بهینهشده برای استنتاج ۲۰-۳۰٪ حاشیه VRAM نگه میدارند تا زمانبند بتواند بدون راهاندازی مجدد ناشی از OOM تهاجمی بچ کند.
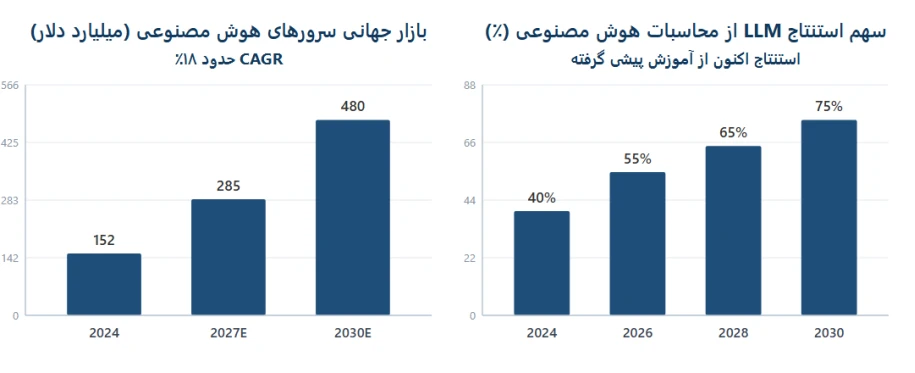
شکل ۱: اندازه بازار سرورهای هوش مصنوعی و سهم روبهرشد استنتاج LLM (منابع در پیوست)
4U چندGPU یا شاسی ۸ GPU؟ توپولوژی، خنکسازی و توسعه
پاسخ کوتاه: یک سرور 4U با ۴-۵ کارت GPU دوعرض نقطه بهینه برای بیشتر استقرارهای خصوصی LLM است؛ تنها زمانی به پلتفرم ۸ GPU با NVLink بروید که یک مدل باید بیش از چهار GPU را پوشش دهد یا به حداکثر توان عبوری هر گره نیاز دارید.
توپولوژی تعیین میکند که استنتاج چندGPU مقیاسپذیر باشد. توزیع صرفاً PCIe برای مدلهای کوچک و سرویس دادهموازی کافی است، اما سرویس تانسورموازی مدل 70B+ به پیوندهای پرسرعت GPU-GPU (NVLink/NVSwitch) نیاز دارد، وگرنه اتصال گلوگاه میشود. خنکسازی تعیین میکند که دوام بیاورد: چهار یا پنج کارت دوعرض ۳۵۰-۷۰۰ وات در 4U به ماژول فن GPU پشتی اختصاصی و جریان هوا از جلو به عقب نیاز دارند. منابع تغذیه افزونه 3+1 یا 2+2 را در نظر بگیرید و مطمئن شوید رک آمپر لازم را تأمین میکند.
▪ یک GPU: بهترین برای نمونههای 7B-13B و ابزارهای داخلی با همزمانی کم.
▪ ۲-۴ GPU در یک 4U: بهترین توازن ظرفیت، افزونگی و توان برای مدلهای 32B-70B.
▪ گره ۸ GPU با NVLink: برای سرویس تانسورموازی 70B+، API چندمستأجری یا ناوگان عاملها.
▪ پیش از خرید همیشه تخصیص خطوط PCIe و فضای فن پشتی را بررسی کنید.
سناریوهای استنتاج LLM در برابر پیکربندی سرور GPU (۲۰۲۶)
جدول زیر بارهای معمول استنتاج را به یک پوشش سختافزاری آغازین نگاشت میکند. آن را پایه اندازهگذاری بدانید و سپس با توکن بر ثانیه measured روی ترکیب پرامپت خود تنظیم کنید.
سناریو | مدل و همزمانی | پیکربندی GPU | هدف VRAM | پلتفرم پیشنهادی |
نمونه اولیه / یک توسعهدهنده | 7B-13B، ۱-۳ کاربر | ۱ GPU دوعرض | ۲۴-۴۸ گیگابایت | ایستگاه GPU 1U/2U |
استنتاج تیمی | 7B-32B، ۵-۲۰ کاربر | ۱-۲ GPU دوعرض | ۴۸-۹۶ گیگابایت | سرور GPU 2U |
LLM دپارتمانی | 70B (INT8)، ۲۰-۵۰ کاربر | ۲-۴ GPU | ۹۶-۱۶۰ گیگابایت | سرور 4U با ۴ GPU |
سرویس سازمانی | 70B-180B، ۵۰-۲۰۰ کاربر | ۴-۸ GPU + NVLink | ۱۶۰-۶۴۰ گیگابایت | گره 4U/۸ GPU با NVLink |
چندمستأجری / عاملها | هر، ۲۰۰+ کاربر | ۸ GPU مرکز داده | ۶۴۰ گیگابایت+ | ۸ GPU HGX / خوشه |
جدول ۱: بارهای استنتاج LLM در برابر پیکربندیهای سرور GPU (۲۰۲۶)
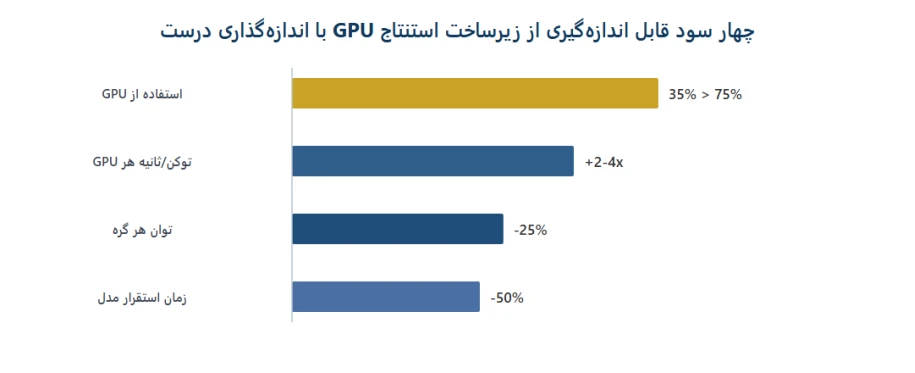
شکل ۲: چهار سود قابل اندازهگیری از زیرساخت استنتاج GPU با اندازهگذاری درست (توضیحی، منابع در پیوست)
توان، خنکسازی و اتاقی که بودجهاش را فراموش کردید
پاسخ کوتاه: سرورهای GPU متراکم رک را به بخاری تبدیل میکنند. یک گره 4U با چهار GPU ۶۰۰ وات بههمراه CPU و فنها میتواند ۳-۴ کیلووات مصرف کند؛ گرههای ۸ GPU از ۸-۱۰ کیلووات فراتر میروند. پیش از رسیدن سختافزار مطمئن شوید PDU، مدار و خنکسازی آن را تحمل میکنند.
جهت جریان هوا، محصورسازی راهروهای گرم و دمای محیط تعیین میکند که GPUها زیر بار مداوم استنتاج دچار کاهش فرکانس شوند یا نه. اگر تأسیسات شما رکهای چگالی بالا را پشتیبانی نمیکند، گره 4U/4 GPU با توان متوسط اغلب مطمئنتر از یک هیولای نظری ۸ GPU است که بهدلیل حرارت افت میکند. صدا محدودیت فراموششده دیگر است: ماژولهای فن پشتی GPU پرصدا هستند، پس محل نصب را دور از افراد برنامهریزی کنید.
سرورهای GPU ChangFan: پلتفرمی یکپارچه ساختهشده برای استنتاج هوش مصنوعی
هوش مصنوعی صنعتی ۷۰٪ بار کاری و ۳۰٪ سختافزار است، اما ۳۰٪ نادرست میتواند ۷۰٪ را صفر کند. شرکت Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) سرورهای GPU رکمونت را برای استنتاج مداوم میسازد: پلتفرمهای 4U با پشتیبانی از حداکثر ۵ GPU دوعرض روی دو Intel Xeon Scalable (نسل ۱-۵) با حافظه DDR4/DDR5 ECC تا ۴ ترابایت، نسخههای تکسوکتی AMD EPYC 7002/7003/8004 با ۴ GPU دوعرض، و شاسی ۲۴ بیزی با NVMe اختیاری برای ذخیره مدل. هر واحد با ماژول فن GPU پشتی اختصاصی، تغذیه افزونه 1+1 یا 2+2، شبکه Gigabit onboard، توسعه PCIe و مدیریت از راه دور IPMI عرضه میشود.
اگر در حال ارزیابی یک LLM خصوصی، یک API استنتاج یا ناوگان عامل هستید، با ChangFan تماس بگیرید تا توصیه پیکربندی یکپارچه بر اساس اندازه مدل × همزمانی × توان رک دریافت کنید (فقط سختافزار، بدون اشتراک نرمافزار). سفارشیسازی OEM/ODM برای یکپارچهسازان و برندها پشتیبانی میشود.
پرسشهای متداول (FAQ)
پ۱: یک مدل 7B برای استنتاج چند GPU لازم دارد؟
پاسخ: یک کارت ۲۴ گیگابایتی مدل 7B را در INT8 اجرا میکند؛ برای FP16 با همزمانی متوسط، یک کارت ۴۸ گیگابایتی یا دو کارت ۲۴ گیگابایتی حاشیه راحت میدهند. محدودیت نخست VRAM است نه FLOPS.
پ۲: از کارتهای مصرفی RTX استفاده کنم یا GPU مرکز داده؟
پاسخ: کارتهای مصرفی در قیمت هر گیگابایت برای نمونهها و ابزارهای داخلی کمهمزمانی برندهاند؛ GPUهای مرکز داده در پهنای باند حافظه، NVLink، ECC و قابلیت اطمینان ۲۴/۷ برندهاند. بر اساس SLA و همزمانی انتخاب کنید نه اوج FLOPS.
پ۳: آیا سرور 4U با ۴ GPU برای مدل 70B کافی است؟
پاسخ: برای سرویس INT8 با همزمانی متوسط بله: 4×48 گیگابایت (۱۹۲ گیگابایت) بهراحتی مدل 70B INT8 بههمراه KV-cache را جای میدهد. برای FP16، همزمانی بالا یا مدلهای 180B به گره ۸ GPU با NVLink بروید.
پ۴: آیا VRAM بیشتر همیشه استنتاج سریعتر است؟
پاسخ: خیر. توکن بر ثانیه به پهنای باند حافظه، اندازه دسته و اتصال بستگی دارد. ظرفیت بیشتر از OOM جلوگیری میکند و دستههای بزرگتر را ممکن میسازد، اما پهنای باند و توپولوژی توان عبوری را تعیین میکنند.
پ۵: آیا میتوانم بعداً به یک سرور 2U استاندارد GPU اضافه کنم؟
پاسخ: معمولاً نه، بهطور ایمن: سرورهای استاندارد کابلکشی توان GPU، ماژول فن پشتی و تخصیص خطوط PCIe برای کارتهای دوعرض ندارند. از ابتدا شاسیای بخرید که برای GPU طراحی شده است.
- مقاله قبلی عنوان اصلی: توربوشارژ هوش مصنوعی لبهای در سال 2026: از Orin تا Thor، چگونه Changfan پایه محاسباتی «هوش مصنوعی فیزیکی» (Physical AI) را ایمن میکند
- مقاله بعدی چیزی باقی نمانده است