Station de travail RTX PRO 6000 Blackwell vs Max-Q vs Server Edition : caractéristiques, choix et guide de configuration (1, 4 ou 8 GPU)
1. La réponse en 30 secondes : un tableau pour savoir quoi choisir
La NVIDIA RTX PRO 6000 Blackwell existe en trois versions : Workstation Edition, Max-Q Workstation Edition et Server Edition. Toutes trois utilisent le même die GB202, les mêmes 24 064 cœurs CUDA et la même mémoire GDDR7 ECC de 96 Go — les capacités fondamentales en IA et en rendu sont strictement identiques. L'enjeu du choix n'est pas « laquelle est la plus rapide », mais la consommation, le mode de refroidissement et le format de déploiement.
Version | Positionnement en une phrase | Pour qui |
Workstation Edition (600 W) | Plafond de performance en carte unique, refroidissement actif double ventilateur | Utilisateurs bureau en carte unique : développement IA, rendu 8K, analyse par simulation |
Max-Q Workstation Edition (300 W) | Consommation divisée par deux, blower à extraction arrière, jusqu'à 4 cartes par station | Stations haute densité 2–4 GPU au bureau, partage multi-utilisateurs |
Server Edition (600 W) | Refroidissement passif sans sorties vidéo, conçue pour le rack en 7×24 | Serveurs IA 4–8 GPU en datacenter, clusters d'inférence, bureaux virtuels |
Remarque : les trois versions embarquent 96 Go de GDDR7 ECC et une interface PCIe 5.0 x16, sans NVLink. Les prix fluctuent avec l'approvisionnement en GDDR7 ; les budgets ci-dessous sont des estimations de marché 2026 — demandez un devis en temps réel pour les prix réels.
2. Comparaison des caractéristiques clés des trois versions
Le tableau ci-dessous récapitule les spécifications clés des trois versions. Comme on le voit, la puissance de calcul de base (nombre de cœurs CUDA / Tensor / RT, capacité mémoire) est identique sur les trois ; les vraies différences se concentrent sur le TDP, la conception du refroidissement, les sorties vidéo et les scénarios de déploiement visés.
Caractéristique | Workstation Edition | Max-Q Workstation Edition | Server Edition |
Architecture GPU | NVIDIA Blackwell (GB202) | Idem | Idem |
Cœurs CUDA | 24 064 | 24 064 | 24 064 |
Cœurs Tensor / RT | 752 (5e gén.) / 188 (4e gén.) | Idem | Idem |
Mémoire | 96 Go GDDR7 ECC | 96 Go GDDR7 ECC | 96 Go GDDR7 ECC |
Bande passante mémoire | 1 792 Go/s | 1 792 Go/s | 1 597 Go/s |
FP32 simple précision | 125 TFLOPS | 110 TFLOPS | ~117 TFLOPS |
Calcul IA (FP4) | ~4 000 AI TOPS | 3 511 AI TOPS | ~3 800 AI TOPS |
Consommation de la carte (TDP) | 600 W | 300 W | 600 W (configurable 400–600 W sur certaines plateformes) |
Refroidissement | Actif double ventilateur (double flux) | Blower simple ventilateur (extraction arrière) | Passif (dépend du flux d'air du châssis) |
Sorties vidéo | 4× DisplayPort 2.1 | 4× DisplayPort 2.1 | Sans sorties vidéo |
Dimensions | Double slot, hauteur étendue 5,4"×12" | Double slot 4,4"×10,5" | Double slot 4,4"×10,5" |
Multi-instances MIG | Pris en charge | Pris en charge (jusqu'à 4×24 Go) | Pris en charge (jusqu'à 4 instances) |
Nombre de GPU recommandé | 1 GPU | 1–4 GPU (station de travail) | 4–8 GPU (serveur rack) |
Sources : pages de spécifications officielles NVIDIA et fiches techniques OEM. Les valeurs AI TOPS utilisent la convention FP4 sparse ; les mentions varient légèrement selon les plateformes.
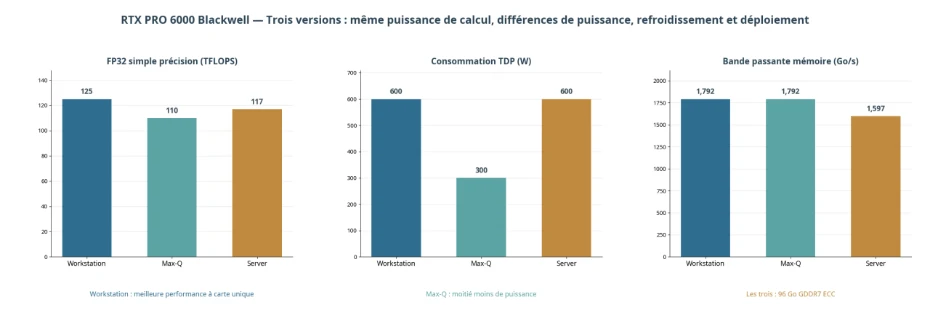
Figure 1 — Indicateurs clés des trois versions : même calcul, puissance et formats divergents
3. Les différences en détail : même calcul — puissance, refroidissement et format de déploiement différents
3.1 Workstation Edition : le plafond de performance en carte unique
La Workstation Edition est la forme « pleine puissance » de la RTX PRO 6000 Blackwell : 600 W de consommation, 125 TFLOPS FP32, 1 792 Go/s de bande passante mémoire, refroidissement actif double ventilateur à double flux — une seule carte libère toute la performance et offre 4 sorties DisplayPort 2.1. La contrepartie est tout aussi directe : 600 W de chaleur cohabitent difficilement en multi-cartes sur un bureau — deux cartes actives de 600 W dans un même châssis perturbent mutuellement leurs flux d'air, et le bruit comme les températures deviennent inacceptables. C'est pourquoi la Workstation Edition est officiellement positionnée pour une utilisation en carte unique.
3.2 Max-Q Workstation Edition : la version « demi-puissance » née pour le multi-GPU
La Max-Q ramène le TDP à 300 W (exactement la moitié) et utilise un radiateur de type blower qui expulse l'air chaud directement à l'arrière du châssis : les cartes ne « respirent » pas l'échappement des autres — 2 à 4 cartes fonctionnent stablement dans une même station, jusqu'à 384 Go de VRAM par machine. Côté performance, le FP32 conserve environ 88 % de la version pleine puissance, tandis que les charges d'inférence IA (surtout l'inférence de grands modèles, limitée par la bande passante mémoire et non par la puissance) mesurent généralement un écart d'environ 10 %. Pour les utilisateurs de stations multi-GPU, la Max-Q est quasiment la seule bonne réponse.
3.3 Server Edition : conçue pour les racks et le fonctionnement 7×24
La Server Edition n'a ni ventilateurs ni connecteurs vidéo ; elle dépend entièrement du flux d'air du châssis serveur pour son refroidissement. Elle prend en charge les déploiements denses de 4 à 8 cartes et le partitionnement multi-instances MIG (jusqu'à 4 instances isolées par carte), avec un support pilote et de validation pour les scénarios de datacenter tels que la virtualisation vGPU et les clusters d'inférence mutualisés. Sa bande passante mémoire est légèrement inférieure (1 597 Go/s), mais l'impact sur la grande majorité des charges IA est minime. À retenir : la Server Edition ne peut pas être installée dans une station tour classique — sans flux d'air de châssis, elle ne peut pas se refroidir.
3.4 Quelle est réellement l'ampleur de l'écart de performance ?
En prenant la Workstation Edition comme référence à 100 %, les mesures tierces placent la Max-Q à environ 90 % sur les charges IA/ML, 88 % en création de contenu et 85 % en rendu Blender ; la Server Edition atteint environ 85 %/85 %/80 %. Autrement dit : échanger 10 %–15 % de performance contre une consommation divisée par deux ou une capacité de déploiement en rack est une très bonne affaire en multi-GPU — car à ce stade, le goulot d'étranglement est « combien de cartes peuvent tenir », pas le sommet d'une carte seule.
4. Recommandations de choix par scénario
Scénario typique | Version recommandée | Justification |
Développement IA individuel, fine-tuning LLM, ComfyUI, rendu 3D (bureau en carte unique) | Workstation Edition | Meilleure performance en carte unique avec sorties vidéo — une carte suffit |
Stations partagées 2–4 GPU au bureau, équipes R&D multi-utilisateurs | Max-Q Workstation Edition | 300 W à extraction arrière — même un châssis tour gère 4 cartes |
Serveurs d'inférence/entraînement 4–8 GPU en datacenter, services en ligne 7×24 | Server Edition | Refroidissement passif assorti au flux d'air du rack ; prend en charge MIG et la virtualisation vGPU |
Calcul mutualisé en universités/laboratoires (partitionnement par utilisateur) | Server Edition (MIG) | Jusqu'à 4 instances de 24 Go par carte — une carte sert plusieurs utilisateurs |
Jumeaux numériques, visualisation 8K, sortie multi-écrans | Workstation Edition | Sortie quadri-écran DP 2.1, pleine performance graphique |
Mini-cluster d'inférence de bureau (sensible au budget) | Max-Q Workstation Edition | Loge 1–2 cartes de plus que la Workstation Edition à budget égal |
Une phrase à retenir : une carte sur le bureau — Workstation Edition ; plusieurs cartes sur le bureau — Max-Q ; en rack dans la salle serveurs — Server Edition.
5. Recommandations de configurations complètes (machines 1 / 4 / 8 GPU)
Chaque niveau ci-dessous propose deux options : la « configuration au coût minimal » comprime le budget tout en restant exploitable ; la « configuration au meilleur rapport qualité-prix » est plus équilibrée en fiabilité, extensibilité et coût d'usage sur cinq ans. Les fourchettes de budget couvrent la machine complète : GPU, plateforme, mémoire, stockage, alimentation et châssis.
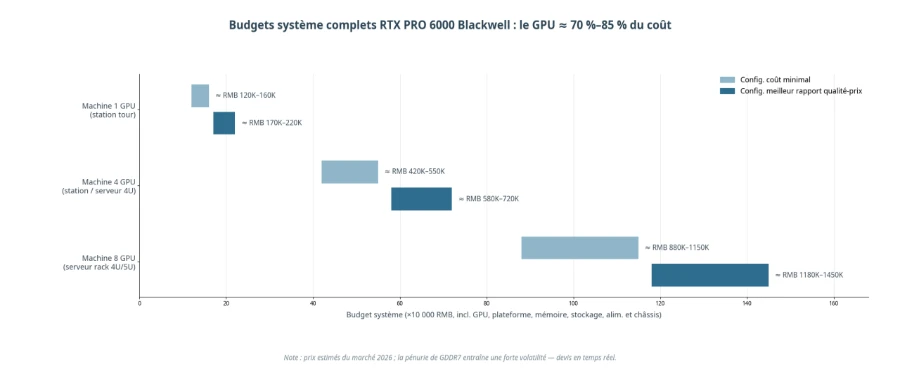
Figure 2 — Fourchettes budgétaires indicatives des trois niveaux de machines (estimations de marché 2026 ; le GPU représente environ 70 %–85 % du coût total)
5.1 Machine 1 GPU (station tour, environ 120 000–220 000 RMB)
Composant | Configuration au coût minimal | Configuration au meilleur rapport qualité-prix |
GPU | RTX PRO 6000 Workstation Edition ×1 | Max-Q ×1 (avec réserve d'extension à 4 GPU) ou Workstation Edition ×1 |
CPU | AMD Ryzen 9 9950X (16 cœurs) | Threadripper 7970X / Xeon W-2500 series |
Mémoire | 64 Go DDR5 | 128–256 Go DDR5 ECC |
Stockage | 2 To NVMe SSD | 4 To NVMe (séparation système/données, compatible RAID) |
Alimentation / châssis | 1200 W Gold + tour refroidie par air | 1600 W Platinum + grande tour (espace multi-GPU réservé) |
Budget de la machine | Environ 120 000–160 000 RMB | Environ 170 000–220 000 RMB |
Convient à : développeurs IA indépendants, design industriel, studios de vidéo 8K et de rendu. Si vous savez que vous passerez à 2–4 GPU sous deux ans, partez directement sur la plateforme Max-Q pour éviter de changer de carte.
5.2 Machine 4 GPU (station haute densité / serveur 4U, environ 420 000–720 000 RMB)
Composant | Configuration au coût minimal | Configuration au meilleur rapport qualité-prix |
GPU | Max-Q Workstation Edition ×4 (384 Go de VRAM au total) | Server Edition ×4 (rack 4U, fonctionnement 7×24) |
CPU | AMD EPYC 9554 simple socket (64 cœurs) | EPYC 9005 series / Xeon 6 double socket |
Mémoire | 256 Go DDR5 | 512 Go DDR5 ECC RDIMM |
Stockage | 2×4 To NVMe | 4×4 To NVMe entreprise (RAID10) + disque système |
Alimentation / châssis | Châssis 4U + 2000 W×2 | Châssis serveur GPU 4U + alimentations redondantes 2700 W |
Budget de la machine | Environ 420 000–550 000 RMB | Environ 580 000–720 000 RMB |
Convient à : fine-tuning et inférence LLM pour équipes petites et moyennes, fermes de rendu par lots, calcul mutualisé multi-utilisateurs. Choisissez Max-Q en environnement bureautique, Server Edition en salle serveurs.
5.3 Machine 8 GPU (serveur rack 4U/5U, environ 880 000–1 450 000 RMB)
Composant | Configuration au coût minimal | Configuration au meilleur rapport qualité-prix |
GPU | Server Edition ×8 (768 Go de VRAM au total) | Server Edition ×8 |
CPU | EPYC 9554 double socket | EPYC 9755 double socket (128 cœurs ×2) |
Mémoire | 768 Go DDR5 | 1–1,5 To DDR5 ECC RDIMM |
Stockage | 8×4 To NVMe | 8×8 To NVMe entreprise + disque de rechange à chaud |
Réseau | 100GbE | 200G/400G InfiniBand ou RoCE (CX-7) |
Alimentation / châssis | 4U/5U + redondance 3000 W | Châssis optimisé GPU + redondance N+N + PDU rack |
Budget de la machine | Environ 880 000–1 150 000 RMB | Environ 1 180 000–1 450 000 RMB |
Convient à : clusters d'inférence d'entreprise, plateformes de fine-tuning de grands modèles, centres de calcul universitaires. Les machines 8 GPU imposent la Server Edition, et la salle serveurs doit fournir ≥6 kW par rack ainsi que le refroidissement correspondant.
Précision budgétaire : sur les trois niveaux, le GPU représente 70 %–85 % du coût total. Sous l'effet de la pénurie de mémoire GDDR7, les prix mondiaux de la RTX PRO 6000 Blackwell ont nettement fluctué depuis le lancement (le prix de référence de la boutique officielle est monté à environ 16 000 USD par carte) — basez les devis de machines sur le jour de la demande.
6. Pièges d'achat et questions fréquentes (FAQ)
Q1 : la mémoire est-elle identique sur les trois versions ?
Strictement identique : 96 Go de GDDR7 ECC avec bus 512 bits. Ne vous souciez pas de la mémoire au moment du choix — seuls comptent la consommation, le refroidissement et le format de déploiement.
Q2 : peut-on mélanger des cartes Max-Q et Server Edition ?
Déconseillé. Les deux ont des conceptions de refroidissement différentes (actif à extraction arrière vs passif) ; les mélanger perturbe les flux d'air et déclenche le throttling thermique. Gardez une seule version par machine.
Q3 : la Server Edition peut-elle s'installer dans une station tour classique ?
Non. La Server Edition est à refroidissement passif, sans ventilateurs, et dépend du flux d'air forcé d'un châssis serveur ; dans un boîtier classique, elle passera en protection thermique en quelques minutes.
Q4 : quelle taille de modèle peut faire tourner 96 Go de VRAM ?
Une seule carte exécute fluidement l'inférence quantifiée (Q4) de modèles classe 70B ou l'inférence haute précision classe 32B ; 4 cartes (384 Go) permettent le fine-tuning de modèles classe 70B ; 8 cartes (768 Go) supportent un service d'inférence pour une centaine d'utilisateurs concurrents.
Q5 : où en sont les prix actuellement ?
La RTX PRO 6000 Blackwell a été lancée en mars 2025 au prix officiel de 8 565 USD ; sous l'effet de la pénurie de GDDR7, le prix de référence de la boutique officielle est monté en 2026 à environ 16 000 USD, et les prix des canaux domestiques chinois fluctuent fortement. Les achats en volume (machines 4/8 GPU) obtiennent généralement de meilleures offres globales — demandez un devis sur la machine complète plutôt que d'additionner les cartes seules.
Q6 : y a-t-il une différence entre une machine certifiée et un assemblage de cartes au détail ?
Oui. Les machines certifiées sont validées au niveau système (thermique, puissance, compatibilité) et couvertes par une garantie machine complète ; l'auto-assemblage en multi-GPU rencontre souvent des problèmes d'alimentation, de refroidissement et de compatibilité des pilotes. À partir de 4 GPU, une solution complète du fabricant est fortement recommandée.
- Article précédent 6 indicateurs clés pour choisir des GPU destinés aux centres de calcul IA : une comparaison approfondie des modèles H100/H200/B200/B300 face aux Ascend 910B/910C/950PR | Changfan Industrial
- Article suivant Refroidissement liquide ou à air ? Guide complet 2026 des voies thermiques pour centres de données IA haute densité