RTX PRO 6000 Blackwell (Workstation) vs. Máximo-Q vs. Server Edition: Especificações, Seleção e Guia de Montagem com 1, 4 ou 8 GPUs
1. A resposta em 30 segundos: uma tabela para ver como escolher
A NVIDIA RTX PRO 6000 Blackwell existe em três versões: Workstation Edition, Max-Q Workstation Edition e Server Edition. As três usam o mesmo die GB202, os mesmos 24.064 núcleos CUDA e a mesma memória GDDR7 ECC de 96 GB — a capacidade central de IA e renderização é totalmente idêntica. A chave da escolha não é «qual é mais rápida», mas consumo, tipo de refrigeração e formato de implantação.
Versão | Posicionamento em uma frase | Para quem |
Workstation Edition (600 W) | Teto de desempenho de uma placa, refrigeração ativa com duas ventoinhas | Usuários de mesa com uma placa: desenvolvimento de IA, renderização 8K, análise de simulação |
Max-Q Workstation Edition (300 W) | Consumo pela metade, blower com exaustão traseira, até 4 placas por workstation | Workstations de alta densidade de 2–4 GPUs em escritório, compartilhamento multiusuário |
Server Edition (600 W) | Refrigeração passiva sem saídas de vídeo, projetada para rack 7×24 | Servidores de IA de 4–8 GPUs em data center, clusters de inferência, desktops virtuais |
Nota: as três versões trazem 96 GB de GDDR7 ECC e interface PCIe 5.0 x16, sem NVLink. Os preços flutuam com o fornecimento de GDDR7; os orçamentos abaixo são estimativas de mercado de 2026 — solicite uma cotação em tempo real para os preços reais.
2. Comparação das especificações-chave das três versões
A tabela a seguir resume as especificações-chave das três versões. Como se vê, a computação central (número de núcleos CUDA / Tensor / RT, capacidade de memória) é idêntica nas três; as diferenças reais concentram-se no TDP, no design de refrigeração, nas saídas de vídeo e nos cenários de implantação visados.
Especificação | Workstation Edition | Max-Q Workstation Edition | Server Edition |
Arquitetura da GPU | NVIDIA Blackwell (GB202) | Idem | Idem |
Núcleos CUDA | 24.064 | 24.064 | 24.064 |
Núcleos Tensor / RT | 752 (5ª geração) / 188 (4ª geração) | Idem | Idem |
Memória | 96 GB GDDR7 ECC | 96 GB GDDR7 ECC | 96 GB GDDR7 ECC |
Largura de banda de memória | 1.792 GB/s | 1.792 GB/s | 1.597 GB/s |
FP32 de precisão simples | 125 TFLOPS | 110 TFLOPS | ~117 TFLOPS |
Computação de IA (FP4) | ~4.000 AI TOPS | 3.511 AI TOPS | ~3.800 AI TOPS |
Consumo da placa (TDP) | 600 W | 300 W | 600 W (configurável 400–600 W em algumas plataformas) |
Refrigeração | Ativa com duas ventoinhas (dois canais de ar) | Blower de uma ventoinha (exaustão traseira) | Passiva (depende do fluxo de ar do chassi) |
Saídas de vídeo | 4× DisplayPort 2.1 | 4× DisplayPort 2.1 | Sem saídas de vídeo |
Dimensões | Dois slots, altura estendida 5,4"×12" | Dois slots 4,4"×10,5" | Dois slots 4,4"×10,5" |
Multi-instância MIG | Suportado | Suportado (até 4×24 GB) | Suportado (até 4 instâncias) |
Número de GPUs recomendado | 1 GPU | 1–4 GPUs (workstation) | 4–8 GPUs (servidor rack) |
Fontes: páginas oficiais de especificações da NVIDIA e datasheets de canais OEM. Os valores de AI TOPS seguem a convenção FP4 com sparsity; a rotulagem varia ligeiramente entre plataformas.
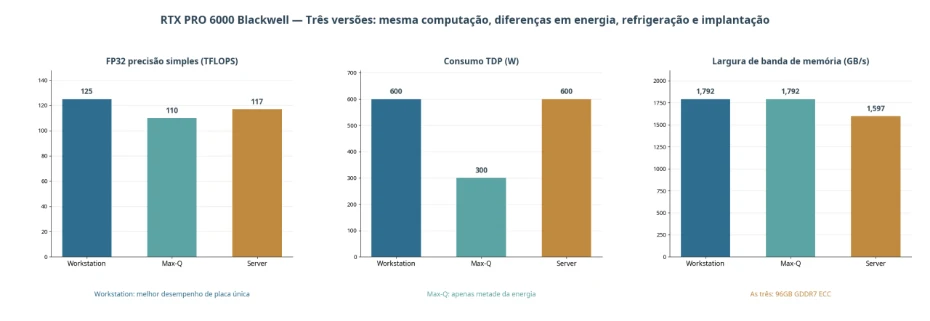
Figura 1 — Indicadores-chave das três versões: mesma computação, potência e formatos divergentes
3. As diferenças em detalhe: mesma computação — diferentes potência, refrigeração e forma de implantação
3.1 Workstation Edition: o teto de desempenho de uma só placa
A Workstation Edition é a forma «de potência plena» da RTX PRO 6000 Blackwell: 600 W de consumo, 125 TFLOPS FP32, 1.792 GB/s de largura de banda de memória, refrigeração ativa com duas ventoinhas e dois canais de ar — uma única placa libera todo o desempenho e oferece 4 saídas DisplayPort 2.1. O custo é igualmente direto: 600 W de calor dificilmente coexistem em arranjos multiplacas na mesa — duas placas ativas de 600 W no mesmo gabinete interferem no fluxo de ar uma da outra, e ruído e temperaturas tornam-se inaceitáveis. Por isso a Workstation Edition é oficialmente posicionada para uso com uma só GPU.
3.2 Max-Q Workstation Edition: a versão de «meia potência» feita para multi-GPU
A Max-Q reduz o TDP para 300 W (exatamente a metade) e usa um cooler tipo blower que expele o ar quente diretamente pela traseira do gabinete, de modo que as placas não «respiram» o exaustor umas das outras — de 2 a 4 placas funcionam com estabilidade numa mesma workstation, até 384 GB de VRAM por máquina. Em desempenho, o FP32 mantém cerca de 88% da versão plena, enquanto as cargas de inferência de IA (sobretudo a inferência de modelos grandes, limitada pela largura de banda de memória e não pela potência) medem em geral uma diferença em torno de 10%. Para usuários de workstations multiplacas, a Max-Q é quase a única resposta correta.
3.3 Server Edition: projetada para racks e operação 7×24
A Server Edition não tem ventoinhas nem conectores de vídeo; depende inteiramente do fluxo de ar do chassi do servidor para se refrigerar. Suporta implantações densas de 4 a 8 placas e particionamento multi-instância MIG (até 4 instâncias isoladas por placa), com suporte de drivers e validação para cenários de data center como virtualização vGPU e clusters de inferência compartilhados. Sua largura de banda de memória é ligeiramente menor (1.597 GB/s), mas o impacto na grande maioria das cargas de IA é mínimo. Atenção: a Server Edition não pode ser instalada numa workstation torre comum — sem o fluxo de ar do chassi, ela não consegue se resfriar.
3.4 Qual é, afinal, o tamanho real da diferença de desempenho?
Tomando a Workstation Edition como referência de 100%, medições de terceiros colocam a Max-Q em torno de 90% em cargas de IA/ML, 88% em criação de conteúdo e 85% em renderização Blender; a Server Edition fica em torno de 85%/85%/80%. Em outras palavras: trocar 10%–15% de desempenho pela metade do consumo ou pela capacidade de implantação em rack é um ótimo negócio em cenários multiplacas — porque aí o gargalo é «quantas placas cabem», não o pico de uma placa só.
4. Recomendações de escolha por cenário
Cenário típico | Versão recomendada | Justificativa |
Desenvolvimento de IA pessoal, fine-tuning de LLM, ComfyUI, renderização 3D (mesa com uma placa) | Workstation Edition | Máximo desempenho de uma placa com saídas de vídeo — uma placa resolve tudo |
Workstations compartilhadas de 2–4 GPUs em escritório, grupos de P&D multiusuário | Max-Q Workstation Edition | 300 W com exaustão traseira — até um gabinete torre comporta 4 placas |
Servidores de inferência/treinamento de 4–8 GPUs em data center, serviços online 7×24 | Server Edition | Refrigeração passiva alinhada ao fluxo do rack; suporta MIG e virtualização vGPU |
Computação compartilhada em universidades/laboratórios (partição por usuário) | Server Edition (MIG) | Até 4 instâncias de 24 GB por placa — uma placa atende vários usuários |
Gêmeos digitais, visualização 8K, saída multitela | Workstation Edition | Saída para quatro telas via DP 2.1, desempenho gráfico pleno |
Minicluster de inferência de mesa (sensível ao orçamento) | Max-Q Workstation Edition | Com o mesmo orçamento, comporta 1–2 placas a mais que a Workstation Edition |
Uma frase para memorizar: uma placa na mesa — Workstation Edition; várias placas na mesa — Max-Q; no rack da sala de servidores — Server Edition.
5. Recomendações de configuração de sistemas completos (máquinas de 1 / 4 / 8 GPUs)
Cada nível abaixo oferece duas opções: a «configuração de custo mínimo» comprime o orçamento mantendo a usabilidade; a «configuração de melhor custo-benefício» é mais equilibrada em confiabilidade, expansibilidade e custo de uso em cinco anos. As faixas de orçamento cobrem o sistema completo: GPU, plataforma, memória, armazenamento, fonte e gabinete.
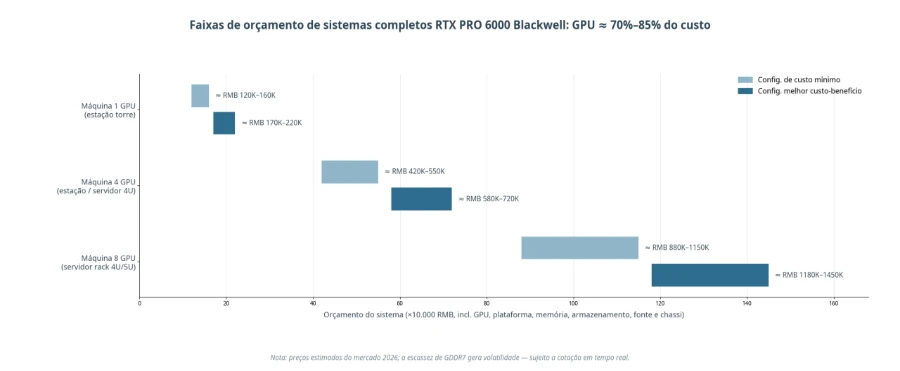
Figura 2 — Faixas de orçamento de referência dos três níveis de máquinas (estimativas de mercado 2026; a GPU representa cerca de 70%–85% do custo total)
5.1 Máquina de 1 GPU (workstation torre, aprox. 120.000–220.000 RMB)
Componente | Configuração de custo mínimo | Configuração de melhor custo-benefício |
GPU | RTX PRO 6000 Workstation Edition ×1 | Max-Q ×1 (com margem para expansão a 4 GPUs) ou Workstation Edition ×1 |
CPU | AMD Ryzen 9 9950X (16 núcleos) | Threadripper 7970X / Xeon W-2500 series |
Memória | 64 GB DDR5 | 128–256 GB DDR5 ECC |
Armazenamento | 2 TB NVMe SSD | 4 TB NVMe (separação sistema/dados, com suporte a RAID) |
Fonte / gabinete | 1200 W Gold + torre refrigerada a ar | 1600 W Platinum + torre completa (espaço reservado para multi-GPU) |
Orçamento do sistema | Aprox. 120.000–160.000 RMB | Aprox. 170.000–220.000 RMB |
Indicada para: desenvolvedores de IA individuais, design industrial, estúdios de vídeo 8K e renderização. Se em dois anos a expansão para 2–4 GPUs é certa, suba direto para a plataforma Max-Q e evite trocar de placa.
5.2 Máquina de 4 GPUs (workstation de alta densidade / servidor 4U, aprox. 420.000–720.000 RMB)
Componente | Configuração de custo mínimo | Configuração de melhor custo-benefício |
GPU | Max-Q Workstation Edition ×4 (384 GB de VRAM no total) | Server Edition ×4 (rack 4U, operação 7×24) |
CPU | AMD EPYC 9554 single-socket (64 núcleos) | EPYC 9005 series / Xeon 6 dual-socket |
Memória | 256 GB DDR5 | 512 GB DDR5 ECC RDIMM |
Armazenamento | 2×4 TB NVMe | 4×4 TB NVMe empresarial (RAID10) + disco de sistema |
Fonte / gabinete | Gabinete 4U + 2000 W×2 | Gabinete de servidor GPU 4U + fontes redundantes de 2700 W |
Orçamento do sistema | Aprox. 420.000–550.000 RMB | Aprox. 580.000–720.000 RMB |
Indicada para: fine-tuning e inferência de LLM em equipes pequenas e médias, fazendas de renderização em lote, computação compartilhada multiusuário. Escolha Max-Q em escritório e Server Edition em sala de servidores.
5.3 Máquina de 8 GPUs (servidor rack 4U/5U, aprox. 880.000–1.450.000 RMB)
Componente | Configuração de custo mínimo | Configuração de melhor custo-benefício |
GPU | Server Edition ×8 (768 GB de VRAM no total) | Server Edition ×8 |
CPU | EPYC 9554 dual-socket | EPYC 9755 dual-socket (128 núcleos ×2) |
Memória | 768 GB DDR5 | 1–1,5 TB DDR5 ECC RDIMM |
Armazenamento | 8×4 TB NVMe | 8×8 TB NVMe empresarial + hot spare |
Rede | 100GbE | 200G/400G InfiniBand ou RoCE (CX-7) |
Fonte / gabinete | 4U/5U + redundância de 3000 W | Gabinete otimizado para GPU + redundância N+N + PDUs de rack |
Orçamento do sistema | Aprox. 880.000–1.150.000 RMB | Aprox. 1.180.000–1.450.000 RMB |
Indicada para: clusters de inferência corporativos, plataformas de fine-tuning de modelos grandes, centros de computação universitários. Máquinas de 8 GPUs exigem a Server Edition, e a sala deve oferecer alimentação ≥6 kW por rack e a refrigeração correspondente.
Nota sobre orçamento: nos três níveis, a GPU representa 70%–85% do custo do sistema. Devido à escassez de memória GDDR7, os preços globais da RTX PRO 6000 Blackwell flutuaram bastante desde o lançamento (o preço de referência da loja oficial subiu para cerca de US$ 16.000 por placa) — baseie as cotações de sistemas no dia da consulta.
6. Armadilhas de compra e perguntas frequentes (FAQ)
P1: a memória é igual nas três versões?
Exatamente igual: 96 GB de GDDR7 ECC com barramento de 512 bits. Não se preocupe com memória na escolha — só importam potência, refrigeração e forma de implantação.
P2: posso misturar placas Max-Q e Server Edition?
Não recomendado. As duas têm designs de refrigeração diferentes (ativo com exaustão traseira vs. passivo); misturá-las desorganiza o fluxo de ar e dispara throttling térmico. Mantenha uma única versão por máquina.
P3: a Server Edition pode ser instalada numa workstation torre comum?
Não. A Server Edition é de refrigeração passiva, sem ventoinhas, e depende do fluxo de ar forçado de um chassi de servidor; num gabinete comum, entrará em proteção térmica em poucos minutos.
P4: que tamanho de modelo 96 GB de VRAM conseguem rodar?
Uma única placa roda com fluidez inferência quantizada (Q4) de modelos classe 70B ou inferência de alta precisão classe 32B; 4 placas (384 GB) permitem fine-tuning de modelos classe 70B; 8 placas (768 GB) sustentam serviço de inferência para cerca de cem usuários simultâneos.
P5: como estão os preços agora?
A RTX PRO 6000 Blackwell foi lançada em março de 2025 ao preço oficial de US 16.000, e os preços dos canais domésticos chineses flutuam bastante. Compras em volume (sistemas de 4/8 GPUs) costumam obter melhores ofertas globais — peça cotação pelo sistema completo em vez de somar placas avulsas.
P6: há diferença entre sistema certificado e montagem própria com placas avulsas?
Há. Sistemas certificados passam por validação em nível de máquina para térmica, potência e compatibilidade e trazem garantia do sistema inteiro; a montagem própria multiplacas costuma enfrentar problemas de alimentação, refrigeração e compatibilidade de drivers. A partir de 4 GPUs, recomenda-se fortemente a solução completa do fabricante.
7. Sobre a ChangFan Industrial Computing
A ChangFan Industrial Computing (Guangzhou ChangFan Intelligent Technology Co., Ltd. — ChangFan, site oficial cfitsi.com) é fabricante profissional de computadores industriais e equipamentos de computação de IA: PCs industriais, workstations GPU, servidores de IA, mini PCs e dispositivos de segurança de rede, com produtos exportados para mercados internacionais.
• Todas as versões em estoque: RTX PRO 6000 Blackwell Workstation Edition / Max-Q / Server Edition — placas avulsas e sistemas completos fornecidos em paralelo;
• Sistemas sob medida: torres de 1 GPU, workstations de alta densidade de 2–4 GPUs e servidores rack de 4–8 GPUs configurados sob demanda, com teste de burn-in de 48 horas antes do envio;
• Entrega global: suporte técnico multilíngue, logística mundial e termos de comércio exterior (FOB/CIF/DDP), com garantia de três anos;
• Consultoria de soluções: avaliação de configuração gratuita — informe o tamanho do modelo, a concorrência e o orçamento, e nossos engenheiros entregarão uma lista de configuração em 24 horas.
Para uma cotação de sistema RTX PRO 6000 Blackwell ou o white paper técnico, visite cfitsi.com ou fale com um engenheiro de vendas da ChangFan Industrial Computing.
- Artigo anterior •Seleção de GPUs para Centros de Computação de IA: 6 Indicadores Relevantes — H100/H200/B200/B300 vs. Ascend 910B/910C/950PR | ChangFan Industrial Computing
- Próximo artigo Refrigeração a Líquido ou a Ar? Um Guia Completo de 2026 sobre Soluções Térmicas para Data Centers de IA de Alta Densidade