Perspektywy infrastruktury obliczeniowej dla AI w latach 2026–2030: era wnioskowania (inference), ekologiczne obliczenia oraz suwerenna sztuczna inteligencja
Wprowadzenie: obliczenia przechodzą „zmianę warty”
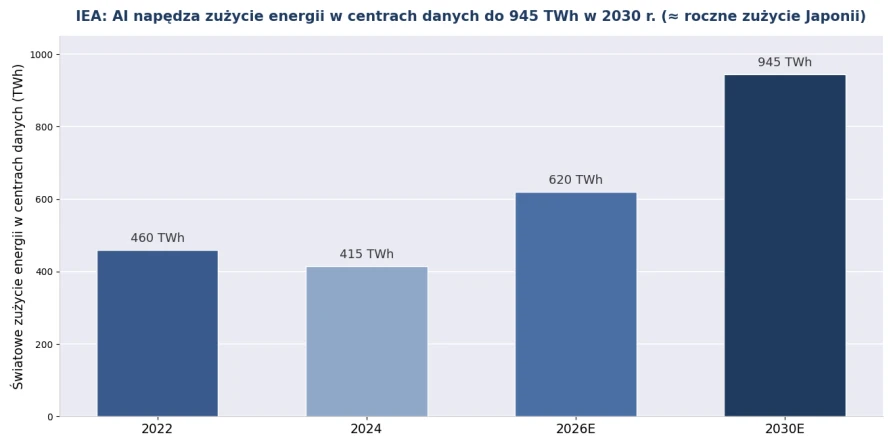
Patrząc wstecz z połowy 2026 roku, widać, że logika branży obliczeniowej AI uległa wymianie: wyścig zbrojeń w treningu ustąpił miejsca ekonomii inferencji; uniwersalne serwerownie — wysokogęstościowym klastrom z chłodzeniem cieczą; dominacja chmury publicznej — wielopoziomowej architekturze „chmura – brzeg – urządzenie”; globalne łańcuchy dostaw — lokalnemu budowaniu suwerennego AI. Międzynarodowa Agencja Energetyczna (IEA) przewiduje, że światowe zużycie energii przez centra danych do 2030 roku sięgnie około 945 TWh — niemal rocznego zużycia energii przez Japonię. Dla firm planujących działania na pięć lat zrozumienie tych pięciu pewnych trendów jest ważniejsze niż podążanie za pojedynczymi modami.
Trend 1: inferencja wyprzedza trening — obliczenia wchodzą w „erę eksploatacji”
Krótka odpowiedź: McKinsey przewiduje, że do 2030 roku inferencja odpowiadać będzie za ponad połowę mocy obliczeniowej centrów AI. Wydatki na obliczenia przechodzą z jednorazowych nakładów inwestycyjnych (capex) w cykliczne koszty operacyjne (opex), a optymalizacja przesuwa się od „szybkiego kupowania” ku „oszczędnej eksploatacji” — kluczowymi wskaźnikami stają się koszt na token i przepustowość na wat.
Bezpośrednie konsekwencje dla firm: przebuduj planowanie zasobów według zasady „inferencja przede wszystkim” — stałe obciążenia inferencyjne należy przenieść do lokalnej infrastruktury lub kolokacji, podczas gdy trening i szczytowa elastyczność pozostają w chmurze; ocena zakupów przesuwa się z papierowych TFLOPS na całkowity koszt posiadania (TCO) w trzyletniej perspektywie, przy czym energia i chłodzenie już dziś pochłaniają 20–30% TCO i muszą obowiązkowo znaleźć się w modelu.
Trend 2: energia staje się pierwszym ograniczeniem — „mieć prąd” jest rzadsze niż „mieć GPU”
Krótka odpowiedź: w latach 2026–2030 głównym wąskim gardłem ekspansji AI będzie sieć energetyczna, a nie chipy — IEA spodziewa się, że zużycie energii przez centra danych mniej więcej podwoi się już w 2026 roku i zmierza do 945 TWh w 2030; w gorących rynkach, takich jak północna Wirginia, budowa nowych linii wysokiego napięcia trwa 5–7 lat, co tworzy „ścianę energetyczną”.
Reakcja branży jest już wyraźna: duże kampusy podłączają się bezpośrednio do sieci wysokiego napięcia lub budują własną generację („generacja za licznikiem”); gaz ziemny z wychwytem węgla, małe reaktory modułowe (SMR) i długoterminowe magazyny energii wchodzą do miksu energetycznego centrów danych; a centra danych zmieniają się z biernych odbiorców w aktywnych uczestników regulacji szczytów sieci. Dla firm „limit mocy i cena prądu” powinny znaleźć się w pierwszej trójce priorytetów przy wyborze lokalizacji i planowaniu mocy; w regionach z deficytem energii wysokosprawny sprzęt i chłodzenie cieczą są równoznaczne z ukrytą rozbudową mocy.
Rysunek 1: Trend światowego zużycia energii przez centra danych (źródła w aneksie)
Trend 3: chłodzenie cieczą z „premium” staje się „standardem” — zielone obliczenia jako próg regulacyjny
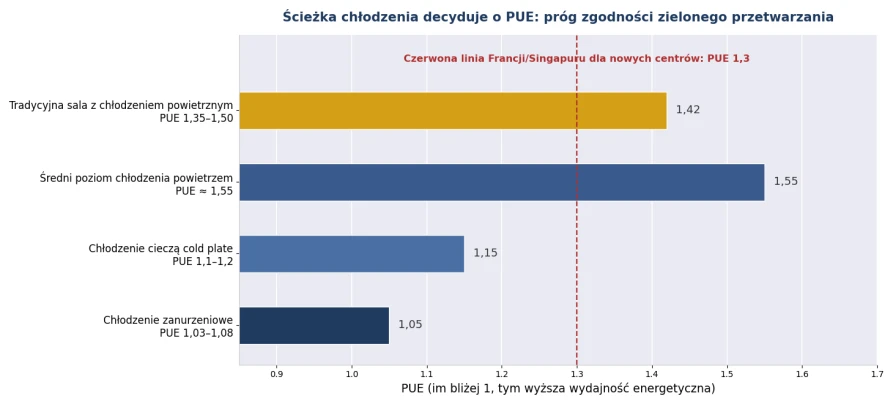
Krótka odpowiedź: pobór mocy pojedynczego GPU zmierza do 2000 W, a odsetek chłodzenia cieczą w nowo budowanych systemach AI wyniósł 67% w pierwszym kwartale 2026 roku; równolegle zaostrzają się przepisy dotyczące PUE (Singapur i Francja wymagają poniżej 1,3 dla nowych inwestycji, Irlandia — 1,2 od 2027 roku) — wybór schematu chłodzenia stał się kwestią zgodności z przepisami, a nie decyzją inżynierską.
Rachunek zielonych obliczeń twardnieje: immersyjne chłodzenie cieczą pozwala zejść z PUE do 1,03–1,08, odcinając zużycie energii na chłodzenie o 40–60%; regulacje UE, takie jak EED, wprowadzają obowiązkowe raportowanie PUE/WUE. W latach 2026–2030 „wydajność na wat” zastąpi „wydajność na dolara” jako pierwszy miernik ekonomii obliczeń, a odzysk ciepła i gospodarka wodna trafią do kart oceny zakupowej.
Rysunek 2: Poziomy PUE według schematów chłodzenia wobec regulacyjnych czerwonych linii (źródła w aneksie)
Trend 4: rozkwit AI brzegowego — architektura obliczeniowa dzieli się na poziomy „chmura – brzeg – urządzenie”
Krótka odpowiedź: małe modele językowe (SLM) przenoszą 80–90% korporacyjnych obciążeń inferencyjnych do lokalnej infrastruktury, a rynek AI brzegowego rośnie w tempie 32,5% rocznie (47 mld USD w 2026 roku → 445,8 mld USD w 2034 roku); trzypoziomowa architektura — trening w chmurze, inferencja na brzegu, percepcja na urządzeniu — staje się korporacyjnym standardem.
Architektura wielopoziomowa zmienia zakupy: chmura rozlicza się za użycie, ale brzeg wymaga sprzętu lokalnego, który „stoi w miejscu i działa stabilnie” — komputery przemysłowe do hali produkcyjnej, minikomputery do sklepów, brzegowe serwery kampusowe oraz jednostki GPU do serwerowni. Dla firm obliczenia brzegowe nie są zamiennikiem chmury, lecz punktem przecięcia trzech wymagań: zgodność danych (dane nie opuszczają zakładu ani kampusu), opóźnienie (odpowiedź w milisekundy) i koszt (bez wiecznych rachunków za API).
Trend 5: suwerenny AI przechodzi z planów do realizacji — lokalne obliczenia jako strategia państwowa i potrzeba firm
Krótka odpowiedź: 71% menedżerów wyższego szczebla już uważa suwerenny AI za imperatyw strategiczny — lokalna kontrola nad danymi, modelami i mocą obliczeniową jest zarówno państwową strategią przemysłową, jak i twardym warunkiem zakupowym klientów z sektora finansów, ochrony zdrowia i administracji.
W 2026 roku suwerenny AI przeszedł od haseł do budżetów: państwa przyspieszają budowę krajowych centrów obliczeniowych, a programy krajowej infrastruktury AI są wdrażane na Bliskim Wschodzie, w Azji Południowo-Wschodniej i Europie; po stronie firm prywatne wdrożenia wracają do łask — kluczowe obciążenia inferencyjne wrażliwych branż wracają do lokalnych serwerowni, napędzając stabilny popyt na serwery GPU, systemy pamięci masowej i sprzęt bezpieczeństwa sieciowego. W latach 2026–2030 wymóg „dane nie opuszczają organizacji” zmieni się z atutu w warunek kwalifikacji w przetargach, a lokalna infrastruktura obliczeniowa stanie się jedną z niewielu okazji typu „łopata i kilof” tej transformacji.
Harmonogram inwestycji w obliczenia dla decydentów (2026–2030)
Tabela 1: Harmonogram działań inwestycyjnych firm w moc obliczeniową na lata 2026–2030
Okno czasowe | Główny wątek branżowy | Działania firmy |
2026 (teraz) | Wojna o koszty inferencji się rozpoczyna; modele SLM trafiają do użytku | Zinwentaryzuj strukturę obciążeń AI; przenieś stałą inferencję z powrotem do infrastruktury lokalnej; przelicz istniejące rachunki chmurowe przez pryzmat TCO |
2026–2027 | Chłodzenie cieczą przekracza 50% adopcji; zaostrzanie przepisów o PUE | Wymagaj gotowości na chłodzenie cieczą w nowych systemach GPU; oceń przejściowe rozwiązania RDHx dla istniejących serwerowni |
2027–2028 | Skalowanie inferencji brzegowej; agenci wchodzą do systemów produkcyjnych | Wdróż węzły brzegowe w halach i sklepach; zbuduj architekturę „trening w chmurze – inferencja na brzegu” |
2028–2030 | Dojrzałość regulacyjna suwerennego AI; uwidocznienie ograniczeń energetycznych | Zakończ prywatną modernizację obciążeń wrażliwych; uwzględnij moc i chłodzenie w pięcioletnim planowaniu lokalizacji |
Przez cały okres | Przyspieszona rotacja sprzętu (nowe pokolenie GPU co dwa lata) | Wybieraj platformy przemysłowe o długim cyklu dostaw i skalowalności; unikaj sztywnego powiązania z jednym formatem GPU |
ChangFan Industrial: „dostawca infrastruktury obliczeniowej” na erę inferencji
Wszystkie pięć trendów ma wspólny punkt lądowania: długoterminowy, pewny popyt na lokalny sprzęt obliczeniowy. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial / ChangFan) obsługuje dokładnie poziomy „brzeg” i „urządzenie” architektury „chmura – brzeg – urządzenie”: serwery GPU 1U/2U/4U do prywatnej inferencji (wersje z chłodzeniem powietrznym i płytą chłodniczą), przemysłowe komputery o rozszerzonym zakresie temperatur i minikomputery dla węzłów hali i sklepu oraz platformy bezpieczeństwa sieciowego niezbędne w scenariuszach suwerennego AI — wszystko z długoterminowym wsparciem dostaw i konfiguracjami na zamówienie, z odpięciem od dwuletniego rytmu wymiany generacji GPU.
Na jakim etapie harmonogramu jesteś, ChangFan Industrial dostarczy rozwiązania sprzętowe, które „działają dziś i skalują się jutro”, dopasowane do struktury Twoich obciążeń — skontaktuj się z nami w sprawie rekomendacji sprzętowych dla pięcioletniego planu obliczeniowego (kompletne rozwiązania sprzętowe; bez subskrypcji oprogramowania).
Najczęściej zadawane pytania (FAQ)
P1: Jaka jest największa zmiana w obliczeniach AI między 2026 a 2030 rokiem? O: Inferencja zastępuje trening jako dominujące obciążenie (ponad połowa do 2030 roku), logika wydatków przechodzi z nakładów inwestycyjnych na operacyjne, a „koszt na token i przepustowość na wat” wypierają szczytową moc obliczeniową jako kluczowe metryki.
P2: Czy centrom danych naprawdę zabraknie prądu? O: IEA prognozuje około 945 TWh zużycia energii przez centra danych w 2030 roku (niemal roczne zużycie Japonii), a czas budowy nowych linii przesyłowych w gorących punktach to 5–7 lat; limit mocy stał się pierwszym ograniczeniem ekspansji obliczeń — „mieć prąd” jest rzadsze niż „mieć GPU”.
P3: Czy MŚP musi martwić się o chłodzenie cieczą i PUE? O: Tak, ale bez paniki — do około 700 W na kartę wystarczy chłodzenie powietrzne; nowe wysokogęstościowe systemy GPU warto jednak wybierać z gotowością na chłodzenie cieczą, zostawiając zapas na następne dwa pokolenia GPU (zmierzające do 2000 W).
P4: Co suwerenny AI oznacza dla zwykłych firm? O: W wrażliwych branżach (finanse, ochrona zdrowia, administracja) wymóg „dane nie opuszczają organizacji” zmienia się z atutu w warunek przetargowy; zwykłe firmy też powinny rozważyć opcje prywatne dla kluczowych obciążeń inferencyjnych, aby uniknąć ryzyk zgodności i długoterminowych kosztów API.
P5: W jakie pułapki inwestycyjne w obliczenia najłatwiej wpaść w ciągu najbliższych pięciu lat? O: W trzy — zakup pod kątem szczytowych TFLOPS bez uwzględnienia trzyletniego TCO (energia i chłodzenie to 20–30%); postawienie wszystkich obciążeń na chmurze publicznej i przegapienie punktu zwrotnego lokalnej ekonomii; oraz sztywne powiązanie z jednym formatem GPU, które nie nadąża za dwuletnim cyklem wymiany pokoleń.
- Poprzedni artykuł Cyberbezpieczeństwo w erze sztucznej inteligencji: skoro atakujący również korzystają z modeli bazowych, w jaki sposób przedsiębiorstwa powinny budować swoją obronę?
- Następny artykuł Skalowanie Edge AI w 2026 roku: Od Orin do Thor – jak Changfan zabezpiecza fundamenty obliczeniowe dla „Fizycznej AI” (Physical AI)