Prospettive per l'infrastruttura di calcolo per l'IA 2026–2030: l'era dell'inferenza, il calcolo sostenibile e l'IA sovrana
Introduzione: l’elaborazione vive un «cambio della guardia» strutturale
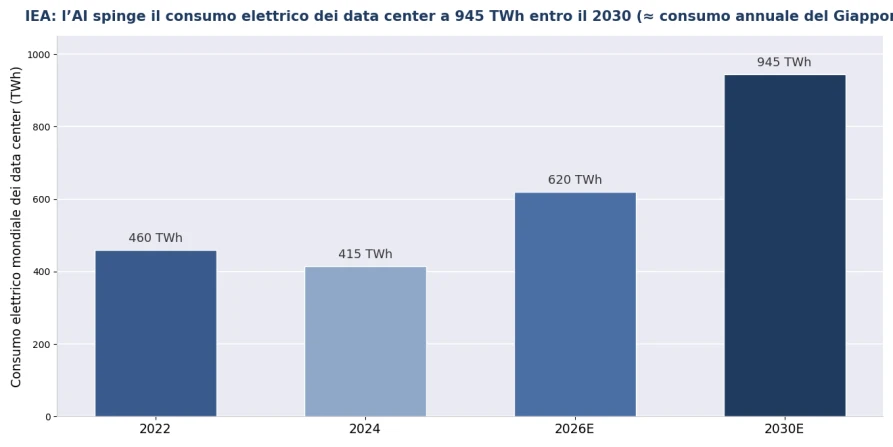
Vista da metà del 2026, la logica di fondo dell’industria dell’elaborazione AI è cambiata: la corsa agli armamenti del training cede il passo all’economia dell’inferenza; le sale server generiche ai cluster ad alta densità con raffreddamento a liquido; il dominio del cloud pubblico al dispiegamento stratificato «cloud – perimetro – dispositivo»; e gli acquisti globalizzati alla costruzione locale di AI sovrana. L’Agenzia internazionale dell’energia (IEA) prevede che il consumo elettrico mondiale dei data center raggiungerà circa 945 TWh entro il 2030 —vicino al consumo annuale di tutto il Giappone—. Per le aziende che preparano piani quinquennali, capire queste cinque tendenze certe conta più dell’inseguimento di qualsiasi singola moda.
Tendenza 1: l’inferenza supera il training — l’elaborazione entra nell’«era dell’esercizio»
Risposta rapida: McKinsey prevede che entro il 2030 l’inferenza rappresenterà più della metà della capacità di elaborazione dei data center AI. La spesa per l’elaborazione passa da un investimento una tantum a una spesa operativa continua, e l’ottimizzazione dei costi vira dall’«acquistare in fretta» al«far funzionare in modo parsimonioso» —costo per token e throughput per watt diventano i KPI centrali.
L’implicazione diretta per le aziende: ricostruire la pianificazione dell’elaborazione attorno al «prima l’inferenza» —i carichi di inferenza permanenti vanno in locale o in colocation, mentre training ed elasticità di picco restano nel cloud; la valutazione degli acquisti passa dai TFLOPS su carta al costo totale di proprietà (TCO) a tre anni, con energia elettrica e raffreddamento che già pesano dal 20 al 30 % del TCO e devono entrare nel modello.
Tendenza 2: l’energia elettrica diventa il primo vincolo — «avere corrente» è più raro che «avere GPU»
Risposta rapida: dal 2026 al 2030 il collo di bottiglia principale dell’espansione AI sarà la rete elettrica, non i chip —l’IEA si aspetta che il consumo dei data center raddoppi già nel 2026 e punti verso 945 TWh nel 2030; nei mercati caldi come la Virginia settentrionale, la costruzione di nuove linee ad alta tensione richiede 5–7 anni, creando un «muro elettrico».
La risposta del settore è già chiara: i grandi campus si collegano direttamente alla rete ad alta tensione o costruiscono generazione propria («generazione dietro il contatore»); gas naturale con cattura del carbonio, piccoli reattori modulari (SMR) e accumulo a lunga durata entrano nel mix energetico dei data center; e i data center passano da consumatori passivi a partecipanti attivi nello shaving dei picchi di rete. Per le aziende, «quota di potenza e prezzo dell’elettricità» devono entrare nella triade delle priorità nella scelta della sede e nella pianificazione della capacità; nelle regioni con tensione elettrica, hardware ad alta efficienza e raffreddamento a liquido equivalgono a un ampliamento di capacità per altra via.
Figura 1: Tendenza del consumo elettrico mondiale dei data center (fonti in appendice)
Tendenza 3: il raffreddamento a liquido passa da «premium» a «standard» — l’elaborazione verde diventa soglia di conformità
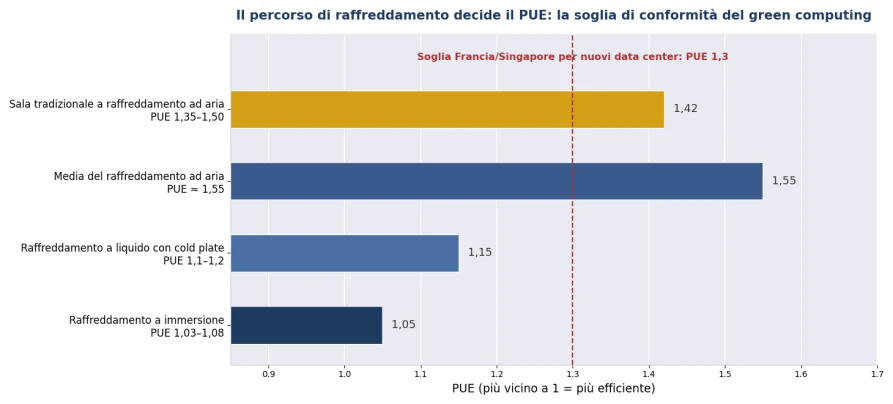
Risposta rapida: il consumo di una singola GPU evolve verso i 2000 W, e l’adozione del raffreddamento a liquido nelle nuove capacità AI ha raggiunto il 67 % nel primo trimestre del 2026; nel frattempo la regolamentazione PUE si inasprisce (Singapore e Francia richiedono sotto 1,3 per le nuove costruzioni, Irlanda 1,2 dal 2027) —la scelta del percorso di raffreddamento è passata da una decisione di ingegneria a una questione di conformità.
Il bilancio dell’elaborazione verde si indurisce: il raffreddamento a immersione può portare il PUE fino a 1,03–1,08, riducendo l’energia di raffreddamento dal 40 al 60 %; normative come la EED europea rendono obbligatoria la divulgazione di PUE/WUE. Dal 2026 al 2030, «la produzione per watt» sostituirà «la produzione per dollaro» come primo indicatore dell’economia dell’elaborazione, e il recupero del calore di scarto e la gestione dell’acqua entreranno anche nelle schede di valutazione degli acquisti.
Figura 2: Livelli di PUE per percorso di raffreddamento rispetto alle linee rosse normative (fonti in appendice)
Tendenza 4: l’ascesa dell’AI al perimetro — il dispiegamento diventa stratificato «cloud – perimetro – dispositivo»
Risposta rapida: i piccoli modelli linguistici (SLM) riportano in loco l’80–90 % dei carichi di inferenza aziendali, e il mercato dell’AI al perimetro cresce a un tasso annuo composto del 32,5 % (47 miliardi di dollari nel 2026 → 445,8 miliardi nel 2034); l’architettura a tre livelli —training nel cloud, inferenza al perimetro, percezione sul dispositivo— diventa la forma predefinita dell’azienda.
L’architettura stratificata ridisegna la struttura degli acquisti: il cloud si paga all’uso, ma il perimetro richiede hardware locale che «resta al suo posto e gira con stabilità» —PC industriali per il reparto, mini-PC per i punti vendita, server di perimetro per il campus e macchine complete con GPU per la sala server. Per l’azienda, l’elaborazione al perimetro non è un sostituto del cloud, ma l’intersezione di tre esigenze: conformità dei dati (che non escono dallo stabilimento né dal campus), latenza (risposta in millisecondi) e costo (senza bollette API perpetue).
Tendenza 5: l’AI sovrana atterra — l’elaborazione localizzata diventa strategia nazionale e necessità aziendale
Risposta rapida: il 71 % dei dirigenti aziendali considera già l’AI sovrana un imperativo strategico —il controllo locale di dati, modelli ed elaborazione è insieme una strategia industriale nazionale e una condizione d’acquisto rigida per i clienti di finanza, sanità e amministrazione pubblica.
Nel 2026 l’AI sovrana è passata dallo slogan al bilancio: i Paesi accelerano la costruzione di centri di elaborazione nazionali, con programmi statali di infrastruttura AI in Medio Oriente, Sud-est asiatico ed Europa; sul lato aziendale torna il dispiegamento privato —i carichi di inferenza critici dei settori sensibili tornano nella sala server locale, trainando una domanda certa di server GPU, storage e hardware di sicurezza di rete. Dal 2026 al 2030, «i dati non escono dal dominio» passerà da vantaggio a requisito di gara, e l’infrastruttura di elaborazione locale è una delle poche opportunità da «venditore di pale e picconi» di questa trasformazione.
Calendario d’investimento in elaborazione per i decisori (2026–2030)
Tabella 1: Calendario delle azioni di investimento in elaborazione aziendale 2026–2030
Finestra temporale | Linea industriale | Azioni consigliate |
2026 (adesso) | Inizia la guerra dei costi d’inferenza; gli SLM atterrano | Fate l’inventario della struttura dei carichi AI; riportate l’inferenza permanente in locale; rivalutate le fatture cloud alla luce del TCO |
2026–2027 | Il raffreddamento a liquido supera il 50 %; la normativa PUE si inasprisce | Nuovi sistemi GPU pronti al liquido; valutate la modifica a ponte RDHx per le sale esistenti |
2027–2028 | L’inferenza al perimetro scala; gli agenti entrano in produzione | Dispiegate nodi di perimetro in reparto e punti vendita; costruite l’architettura «training cloud – inferenza perimetro» |
2028–2030 | La conformità AI sovrana matura; i vincoli energetici mordono | Completate le privatizzazioni dei carichi sensibili; includete potenza e raffreddamento nella pianificazione quinquennale delle sedi |
Per tutto il periodo | Accelerazione dell’iterazione hardware (nuova generazione di GPU ogni due anni) | Scegliete piattaforme industriali con ciclo di fornitura lungo e scalabilità; evitate il vincolo a una sola forma di GPU |
ChangFan Industrial: un «fornitore di infrastruttura di elaborazione» per l’era dell’inferenza
Cinque tendenze hanno un unico punto di atterraggio: una domanda locale di hardware a lungo termine e certa. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial / ChangFan) copre esattamente i livelli «perimetro» e «dispositivo» dell’architettura «cloud – perimetro – dispositivo»: server GPU 1U/2U/4U per inferenza privata (varianti a raffreddamento ad aria e a liquido con cold plate), PC industriali a largo intervallo di temperatura e mini-PC per i nodi di reparto e punto vendita, oltre alle piattaforme di sicurezza di rete indispensabili negli scenari di AI sovrana —l’intera linea con supporto di cicli di fornitura lunghi e configurazioni personalizzate, disaccoppiata dal ritmo biennale delle generazioni di GPU.
In qualunque punto del calendario vi troviate, ChangFan Industrial può offrirvi soluzioni hardware che «funzionano oggi e scalano domani», adattate alla struttura dei vostri carichi —contattateci per raccomandazioni hardware per il vostro piano quinquennale di elaborazione (soluzioni hardware complete; senza abbonamenti software).
Domande frequenti (FAQ)
D1: Qual è il cambiamento più grande dell’elaborazione AI tra il 2026 e il 2030? R: L’inferenza sostituisce il training come carico dominante (oltre la metà entro il 2030), la logica della spesa passa dal capex all’opex, e «costo per token, throughput per watt» sostituiscono la capacità di picco come metriche centrali.
D2: I data center resteranno davvero senza energia? R: L’IEA prevede circa 945 TWh di consumo mondiale dei data center entro il 2030 (vicino al consumo annuale del Giappone), con tempi di 5–7 anni per nuove linee nei mercati caldi; la quota di potenza è diventata il primo vincolo di espansione —«avere corrente» è più raro che «avere GPU».
D3: Le PMI devono preoccuparsi di raffreddamento a liquido e PUE? R: Sì, ma senza angoscia —l’aria basta fino a circa 700 W per scheda; tuttavia i nuovi sistemi GPU ad alta densità dovrebbero scegliere piattaforme predisposte per il liquido, lasciando margine per le prossime due generazioni di GPU (verso i 2000 W).
D4: Cosa significa l’AI sovrana per un’azienda ordinaria? R: Nei settori sensibili (finanza, sanità, pubblica amministrazione), «i dati non escono dal dominio» passa da vantaggio a requisito di gara; anche le aziende ordinarie dovrebbero valutare opzioni private per i carichi di inferenza critici, evitando rischi di conformità e costi API a lungo termine.
D5: Quali sono le trappole più facili degli investimenti in elaborazione per i prossimi cinque anni? R: Tre —acquistare per TFLOPS di picco ignorando il TCO triennale (energia e raffreddamento al 20–30 %); puntare tutto sul cloud pubblico e perdere il punto di svolta del costo locale; e vincolarsi a una sola forma di GPU, incapace di seguire il ritmo biennale dell’hardware.
- Articolo precedente La sicurezza informatica nell'era dell'intelligenza artificiale: quando anche gli aggressori utilizzano i modelli di base, come dovrebbero strutturare le proprie difese le aziende?
- Articolo successivo L'espansione dell'Edge AI nel 2026: Da Orin a Thor, come Changfan protegge le fondamenta del calcolo per la "IA Fisica" (Physical AI)