Prospek Infrastruktur Komputasi AI 2026–2030: Era Inferensi, Pusat Data Hijau, dan AI Berdaulat
Pendahuluan: Komputasi Mengalami 'Pergantian Penjaga'
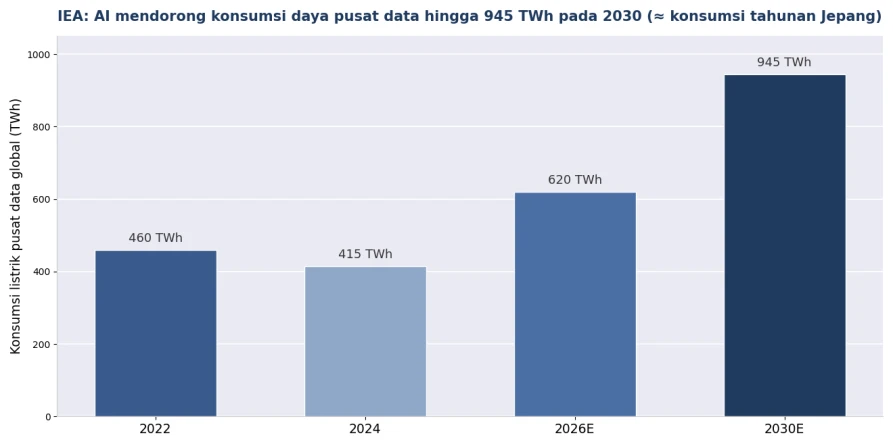
Melihat mundur dari pertengahan 2026, logika dasar industri komputasi AI telah berganti: perlombaan senjata dalam pelatihan tergusur oleh ekonomi inferensi; ruang server generik tergusur oleh klaster padat berpendingin cair; dominasi cloud publik tergusur oleh penyebaran berlapis 'cloud–tepi–perangkat'; dan pengadaan global tergusur oleh pembangunan AI berdaulat secara lokal. Badan Energi Internasional (IEA) memproyeksikan konsumsi listrik pusat data global mencapai sekitar 945 TWh pada 2030 — mendekati konsumsi tahunan seluruh Jepang. Bagi perusahaan yang menyusun rencana lima tahun, memahami lima tren pasti ini lebih penting daripada mengejar setiap topik hangat secara terpisah.
Tren 1: Inferensi Melampaui Pelatihan — Komputasi Memasuki 'Era Operasi'
Jawaban singkat: McKinsey memproyeksikan bahwa pada 2030 inferensi akan menyumbang lebih dari separuh kapasitas komputasi pusat data AI. Belanja komputasi bergeser dari belanja modal satu kali (capex) menjadi belanja operasional berulang (opex), dan optimasi biaya bergeser dari 'membeli cepat' menjadi 'mengoperasikan secara hemat' — biaya per token dan throughput per watt menjadi KPI inti.
Implikasi langsung bagi perusahaan: bangun kembali perencanaan komputasi di sekitar prinsip 'inferensi dahulu' — beban inferensi stabil sebaiknya berada di lingkungan lokal atau kolokasi, sementara pelatihan dan elastisitas puncak tetap di cloud; evaluasi pengadaan bergeser dari TFLOPS di atas kertas ke total biaya kepemilikan (TCO) tiga tahun, di mana listrik dan pendinginan sudah menyerap 20%–30% TCO sehingga wajib masuk dalam model.
Tren 2: Listrik Menjadi Kendala Pertama — 'Punya Listrik' Lebih Langka daripada 'Punya GPU'
Jawaban singkat: pada 2026–2030, hambatan utama perluasan AI adalah jaringan listrik, bukan chip — IEA memperkirakan konsumsi pusat data kira-kira berlipat ganda mulai 2026 dan menuju 945 TWh pada 2030; di pasar panas seperti Virginia Utara, pembangunan jalur transmisi tegangan tinggi baru memakan waktu 5–7 tahun, menciptakan 'dinding listrik'.
Jawaban industri sudah jelas: kampus besar terhubung langsung ke jaringan tegangan tinggi atau membangun pembangkit sendiri ('di belakang meteran'); gas alam dengan penangkapan karbon, reaktor modular kecil (SMR), dan penyimpanan berdurasi panjang masuk ke dalam bauran energi pusat data; dan pusat data berubah dari konsumen pasif menjadi peserta aktif dalam pemangkasan puncak jaringan. Bagi perusahaan, 'kuota daya dan tarif listrik' sebaiknya masuk tiga prioritas utama dalam pemilihan lokasi dan perencanaan kapasitas; di wilayah terbatas listrik, perangkat keras berdaya tinggi dan pendinginan cair setara dengan perluasan kapasitas secara terselubung.
Gambar 1: Tren konsumsi listrik pusat data global (sumber di lampiran)
Tren 3: Pendinginan Cair dari 'Premium' menjadi 'Standar' — Komputasi Hijau Menjadi Ambang Kepatuhan
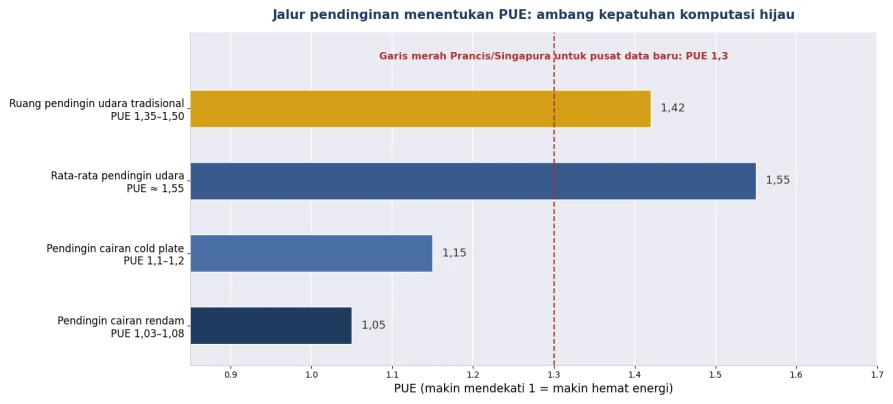
Jawaban singkat: daya serap satu GPU menuju 2000 W, dan adopsi pendinginan cair pada komputasi AI yang baru dibangun mencapai 67% pada kuartal pertama 2026; seiring itu regulasi PUE makin ketat (Singapura dan Prancis mensyaratkan di bawah 1,3 untuk bangunan baru, Irlandia 1,2 pada 2027) — pilihan rute pendinginan telah berubah dari keputusan rekayasa menjadi persoalan kepatuhan.
Perhitungan komputasi hijau mengeras: pendinginan cair rendam dapat menekan PUE hingga 1,03–1,08, memangkas energi pendinginan 40%–60%; regulasi seperti EED Uni Eropa mewajibkan pengungkapan PUE/WUE. Pada 2026–2030, 'hasil per watt' akan menggantikan 'hasil per dolar' sebagai tolok ukur pertama ekonomi komputasi, dan pemulihan panas buang serta pengelolaan air juga masuk ke dalam lembar penilaian pengadaan.
Gambar 2: Tingkat PUE menurut rute pendinginan versus garis merah regulasi (sumber di lampiran)
Tren 4: AI Tepi Bangkit — Penyebaran Komputasi Berlapis 'Cloud–Tepi–Perangkat'
Jawaban singkat: model bahasa kecil (SLM) membawa 80%–90% beban inferensi perusahaan ke lingkungan lokal, dan pasar AI tepi berkembang dengan laju majemuk 32,5% per tahun (47 miliar dolar pada 2026 → 445,8 miliar dolar pada 2034); arsitektur berlapis tiga — pelatihan di cloud, inferensi di tepi, persepsi di perangkat — menjadi standar perusahaan.
Arsitektur berlapis menulis ulang logika pengadaan: cloud ditagihkan per pemakaian, tetapi tepi memerlukan perangkat keras lokal yang 'tetap berdiri di tempat dan berjalan stabil' — komputer industri untuk lantai pabrik, mini PC untuk toko, server tepi kampus, dan unit GPU untuk ruang server. Bagi perusahaan, komputasi tepi bukan pengganti cloud, melainkan titik temu tiga tuntutan: kepatuhan data (data tidak meninggalkan pabrik atau kampus), latensi (respons dalam milidetik), dan biaya (tanpa tagihan API selamanya).
Tren 5: AI Berdaulat Mendarat — Komputasi Terlokalisasi Menjadi Strategi Nasional dan Kebutuhan Perusahaan
Jawaban singkat: 71% eksekutif perusahaan sudah memandang AI berdaulat sebagai keharusan strategis — kendali lokal atas data, model, dan komputasi sekaligus strategi industri nasional dan syarat pengadaan yang ketat bagi pelanggan dari keuangan, kesehatan, dan sektor publik.
Pada 2026, AI berdaulat berpindah dari slogan ke anggaran: negara mempercepat pembangunan pusat komputasi nasional, dengan program infrastruktur AI nasional digulirkan di Timur Tengah, Asia Tenggara, dan Eropa; di sisi perusahaan, penyebaran privat kembali — beban inferensi inti industri sensitif kembali ke ruang server lokal, menggerakkan permintaan stabil untuk server GPU, penyimpanan, dan perangkat keras keamanan jaringan. Pada 2026–2030, syarat 'data tetap dalam domain' akan berubah dari bonus menjadi syarat kualifikasi lelang, dan infrastruktur komputasi lokal adalah salah satu dari sedikit peluang 'pacul dan sekop' dalam transformasi ini.
Lini Masa Investasi Komputasi bagi Pengambil Keputusan (2026–2030)
Tabel 1: Lini masa tindakan investasi komputasi perusahaan, 2026–2030
Jendela waktu | Garis utama industri | Butir tindakan perusahaan |
2026 (sekarang) | Perang biaya inferensi dimulai; SLM turun ke produksi | Inventarisasi struktur beban AI Anda; kembalikan inferensi stabil ke lingkungan lokal; hitung ulang tagihan cloud yang ada berbasis TCO |
2026–2027 | Pendinginan cair melewati adopsi 50%; regulasi PUE mengeras | Syaratkan kesiapan pendinginan cair pada platform GPU baru; nilai retrofit RDHx sebagai jembatan untuk ruang server yang ada |
2027–2028 | Inferensi tepi diskalakan; agen masuk ke sistem produksi | Terapkan simpul tepi lantai pabrik dan toko; dirikan arsitektur berlapis 'pelatihan cloud – inferensi tepi' |
2028–2030 | Kepatuhan AI berdaulat matang; keterbatasan listrik terasa | Selesaikan retrofit privat untuk beban sensitif; masukkan daya dan pendinginan ke dalam perencanaan lokasi lima tahun |
Sepanjang periode | Iterasi perangkat keras dipercepat (generasi GPU baru setiap dua tahun) | Pilih platform industri dengan siklus pasokan panjang dan skalabilitas; hindari penguncian pada satu bentuk GPU |
ChangFan Industrial: 'Pemasok Infrastruktur Komputasi' untuk Era Inferensi
Kelima tren berbagi satu titik pendaratan: permintaan jangka panjang dan pasti atas perangkat keras komputasi lokal. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial / ChangFan) mencakup tepat lapisan 'tepi' dan 'perangkat' dari arsitektur 'cloud–tepi–perangkat': server GPU 1U/2U/4U untuk inferensi privat (varian pendingin udara dan pendingin cair cold-plate), komputer industri rentang suhu lebar dan mini PC untuk simpul lantai pabrik dan toko, serta platform perangkat keras keamanan jaringan yang tak tergantikan dalam skenario AI berdaulat — semuanya dengan dukungan siklus pasokan panjang dan konfigurasi kustom, lepas dari ritme penggantian generasi GPU dua tahunan.
Di mana pun posisi Anda pada lini masa, ChangFan Industrial dapat menyediakan solusi perangkat keras yang 'dipasang hari ini dan diskalakan besok', disesuaikan dengan struktur beban Anda — hubungi kami untuk rekomendasi perangkat keras bagi rencana komputasi lima tahun Anda (solusi perangkat keras lengkap; tanpa langganan perangkat lunak).
Pertanyaan yang Sering Diajukan (FAQ)
T1: Apa perubahan terbesar dalam komputasi AI antara 2026 dan 2030? J: Inferensi menggantikan pelatihan sebagai beban dominan (lebih dari separuh pada 2030), logika belanja bergeser dari capex ke opex, dan 'biaya per token, throughput per watt' menggantikan komputasi puncak sebagai metrik inti.
T2: Apakah pusat data benar-benar akan kekurangan listrik? J: IEA memproyeksikan sekitar 945 TWh konsumsi pusat data global pada 2030 (mendekati konsumsi tahunan Jepang), dengan waktu pembangunan jalur transmisi baru 5–7 tahun di pasar panas; kuota daya kini menjadi kendala pertama perluasan komputasi — 'punya listrik' lebih langka daripada 'punya GPU'.
T3: Apakah UKM perlu mengkhawatirkan pendinginan cair dan PUE? J: Ya, tetapi tanpa panik — pendinginan udara memadai hingga sekitar 700 W per kartu; namun sistem GPU padat baru sebaiknya dipilih siap pendinginan cair untuk memberi ruang bagi dua generasi GPU berikutnya (menuju 2000 W).
T4: Apa arti AI berdaulat bagi perusahaan biasa? J: Pada industri sensitif (keuangan, kesehatan, pemerintahan), syarat 'data tetap dalam domain' berubah dari bonus menjadi syarat lelang; perusahaan biasa pun sebaiknya menilai opsi privat untuk beban inferensi inti guna menghindari risiko kepatuhan data dan biaya API jangka panjang.
T5: Apa jebakan investasi komputasi yang paling mudah dalam lima tahun ke depan? J: Tiga — membeli berdasarkan TFLOPS puncak tanpa memperhitungkan TCO tiga tahun (listrik dan pendinginan = 20%–30%); memasang seluruh beban pada cloud publik dan melewatkan titik balik ekonomi lokal; serta terkunci pada satu bentuk GPU yang tak mampu mengikuti ritme perangkat keras dua tahunan.